
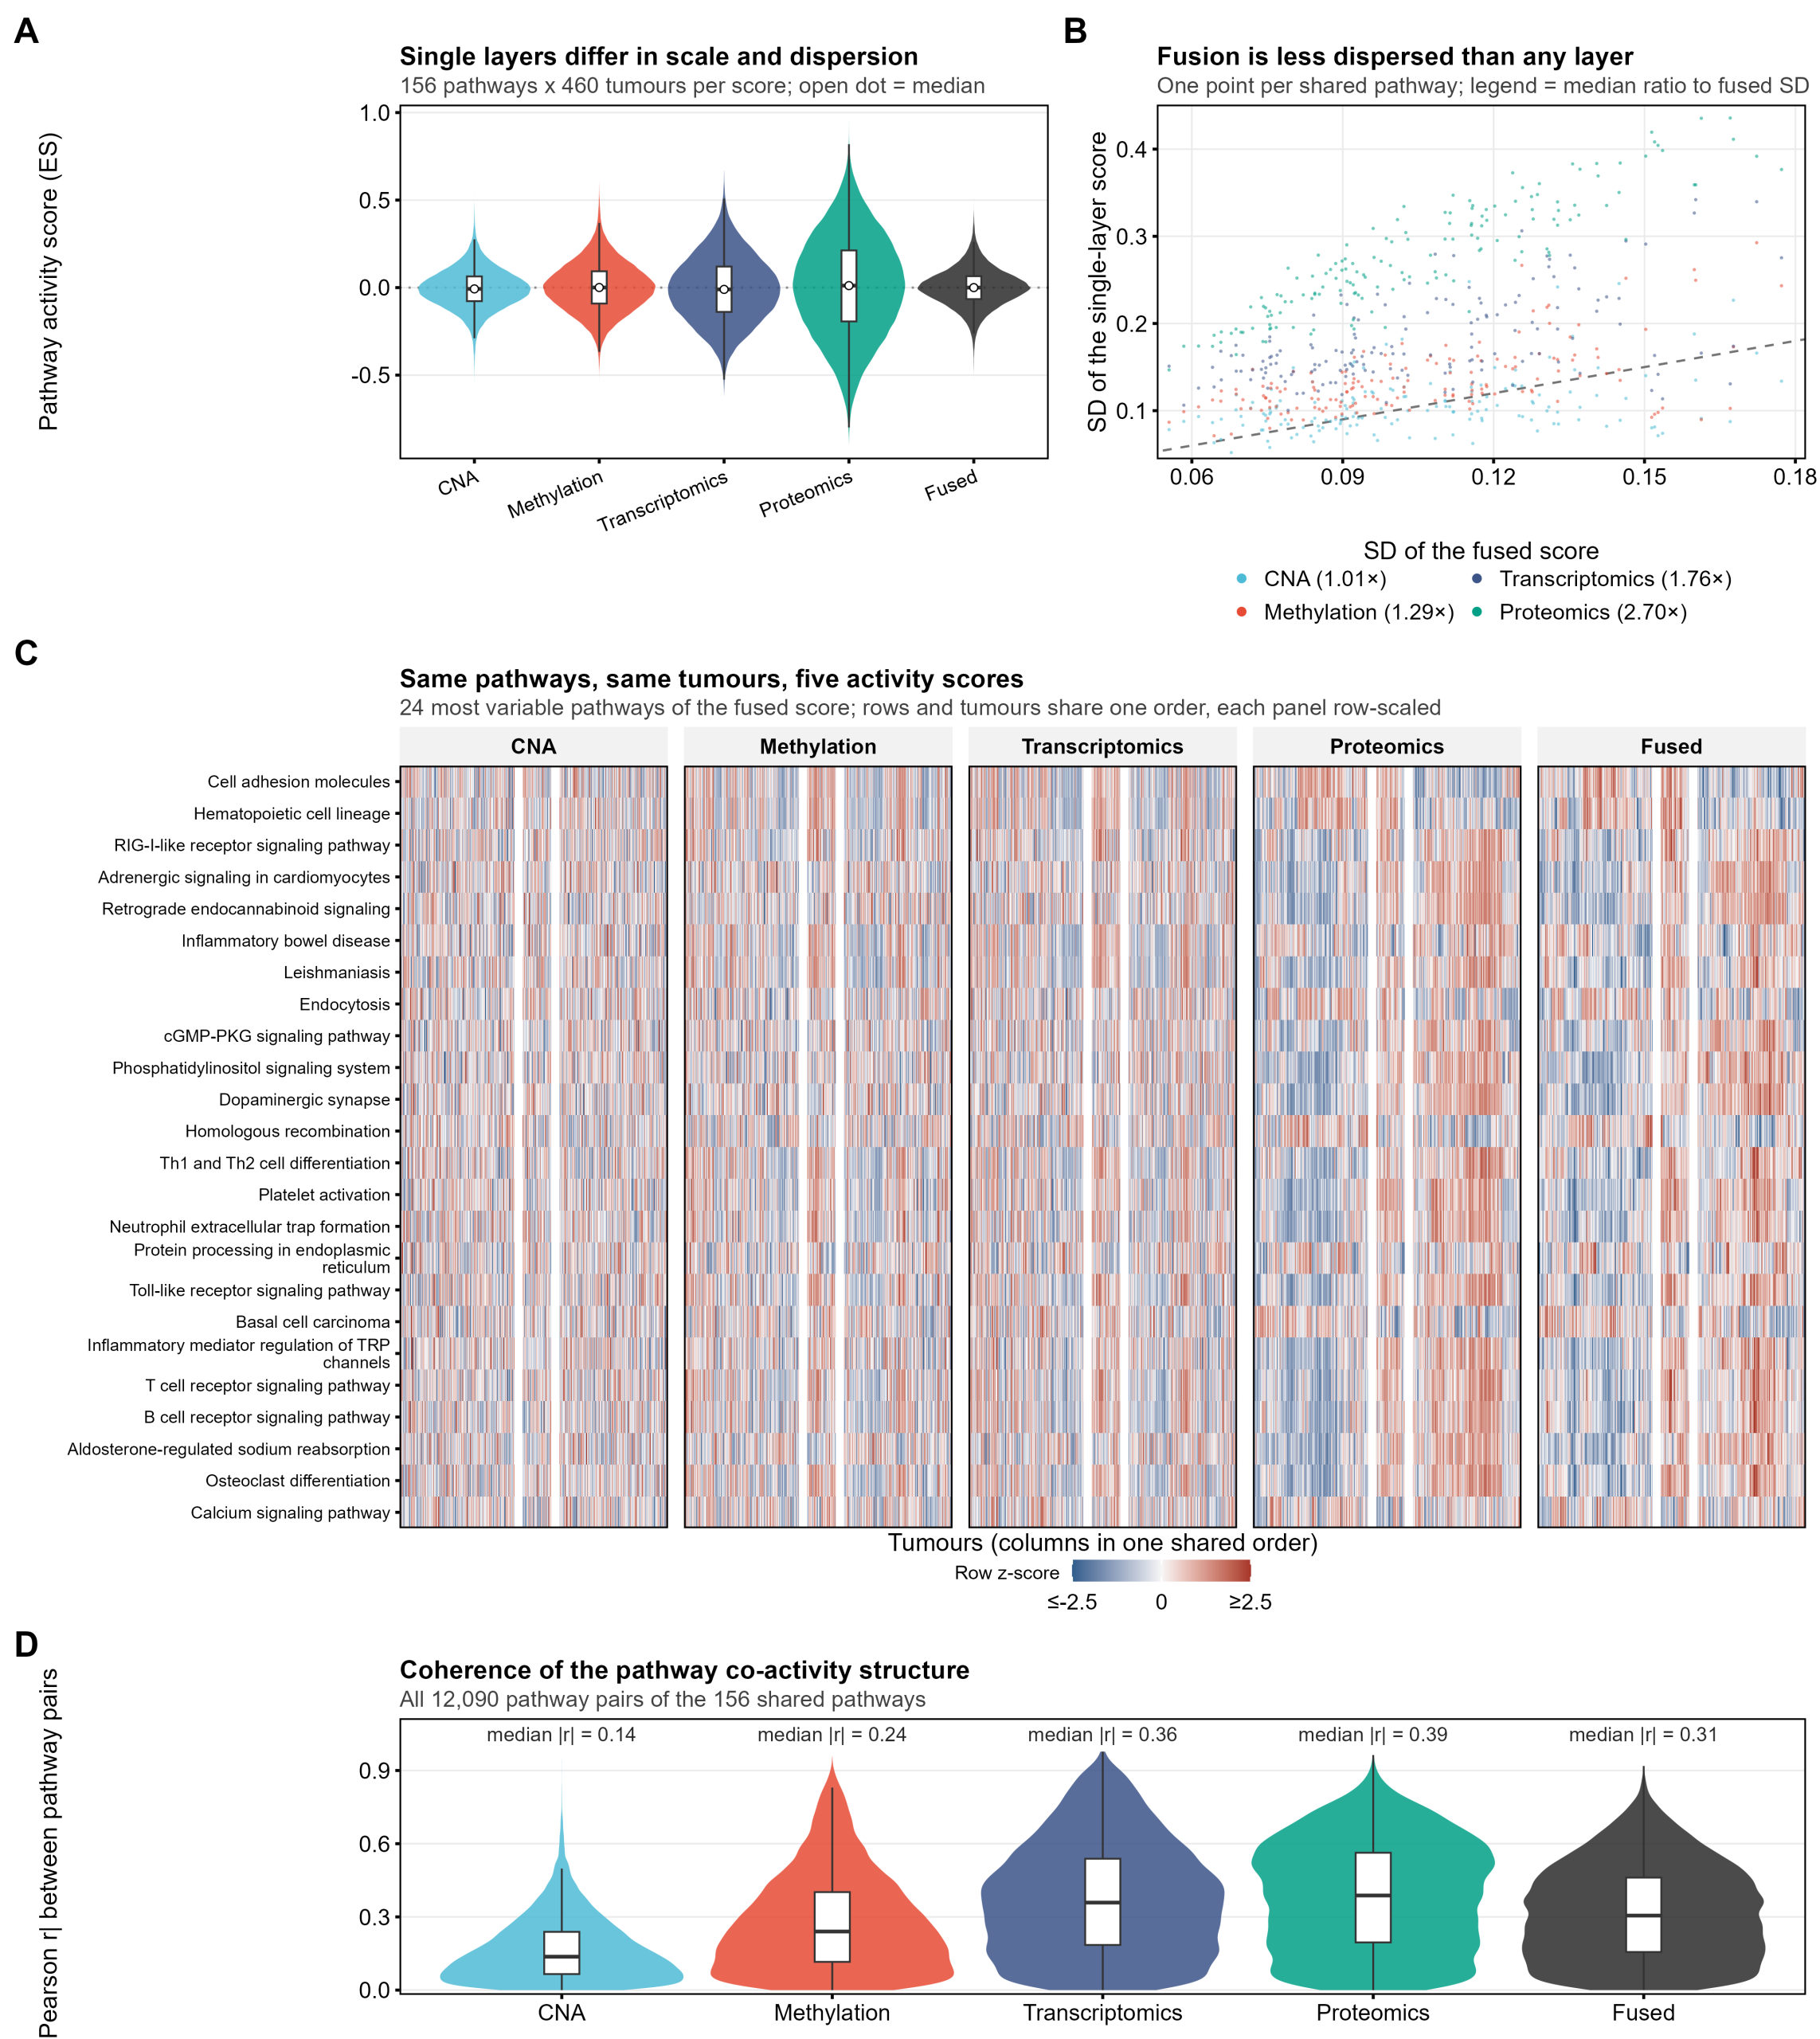
估计阅读时长: 14 分钟460 个乳腺癌、四个组学层、335 条 KEGG 通路。融合分数到底比"逐层算完再平均"强在哪?这篇文章把该泼的冷水泼完,再讲清楚它真正的价值。 面向:生物信息 / 计算生物学方向的研究生 | 预计阅读 30 分钟 数据:TCGA-BRCA(PanCanAtlas 处理版) | 配套:上篇讲数学,本篇讲实证 目录 先看数据:460 个肿瘤怎么变成四个矩阵 疾病背景:乳腺癌根本不是一种病 […]
估计阅读时长: 20 分钟用 GCModeller 做泛基因组分析(二):801 个大肠杆菌基因组实战 面向读者:具有一定 R 语言编程基础的生物信息学初学者、实验室里的微生物研究者。 本篇是系列的实战篇:从 GenBank 原始注释文件出发,用两条 R# 脚本跑完大肠杆菌的泛基因组分析, 并结合真实运行产出的结果文件逐项解读。算法原理(CD-HIT 聚类、PAV 矩阵、香农信息熵等) 请先阅读系列第一篇《用 […]
估计阅读时长: 5 分钟基因组 为了能够实现上面所描述的这种基于EC Number的不同层级的加权嵌入,我们在原来的基因组嵌入工具上添加了一个hierarchical选项,用于支持切换为层级嵌入的操作: Imports Microsoft.VisualBasic.Data.Framework Imports Microsoft.VisualBasic.Data.NLP Imports SMRUCC.genomics.Interops.NCBI.Extensions.Pipeline Public Class GenomeMetabolicEmbedding ReadOnly vec As New […]
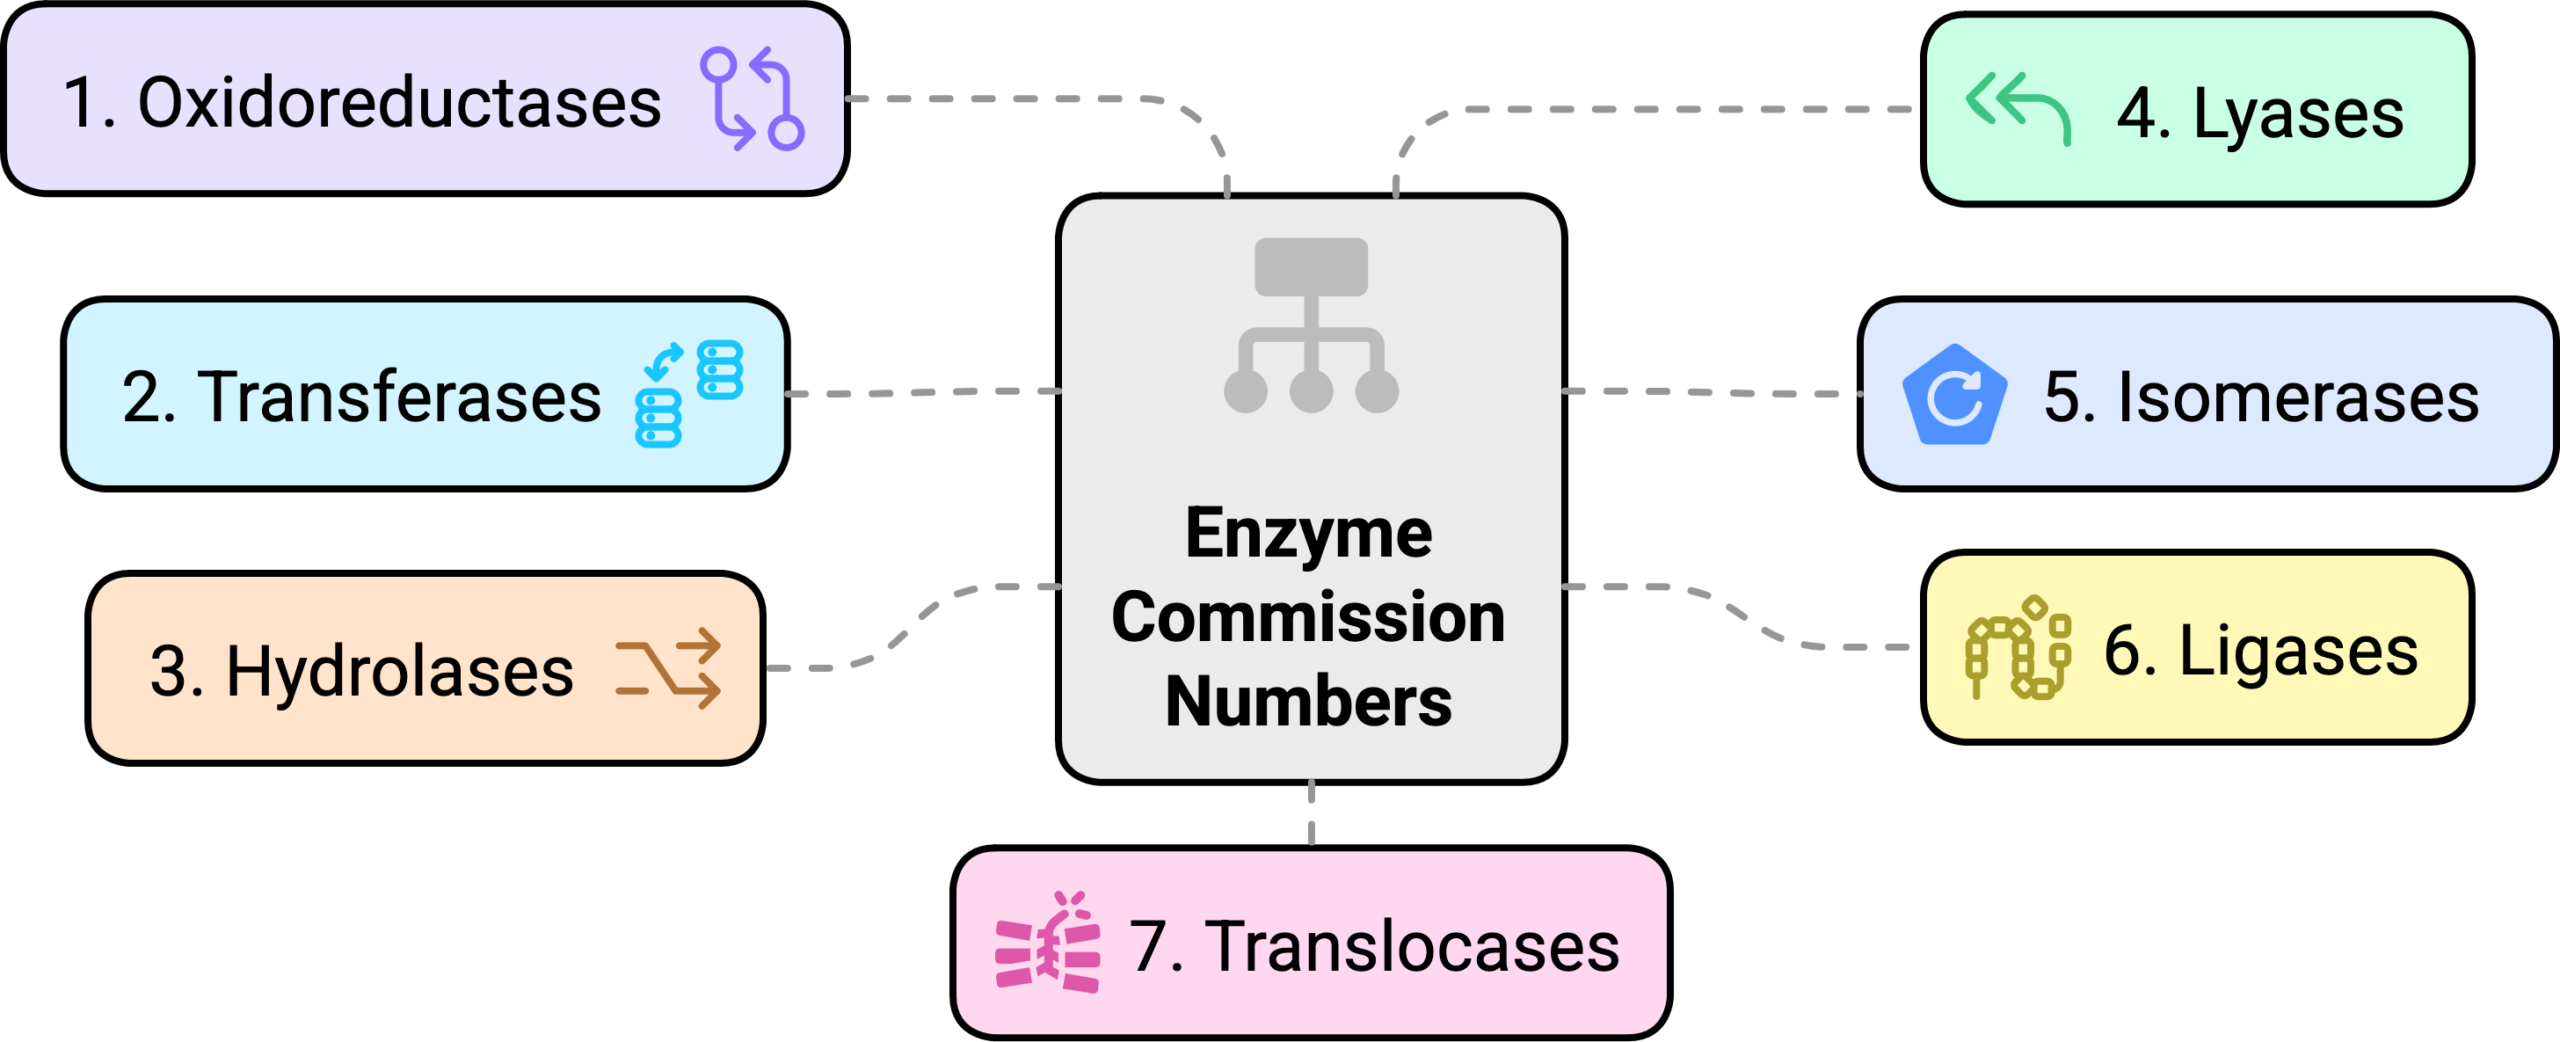
估计阅读时长: 14 分钟酶的EC number(Enzyme Commission number)是国际生物化学与分子生物学学会(IUBMB)酶学委员会制定的酶分类与命名体系的核心标识符,自1961年首次发布以来,已成为酶学研究、数据库管理和生物技术应用的全球标准。这套由四位数字所构成的的层级编码系统不仅解决了早期酶命名混乱的问题,还通过系统化分类揭示了酶催化功能的内在逻辑,为酶学研究提供了统一的框架。
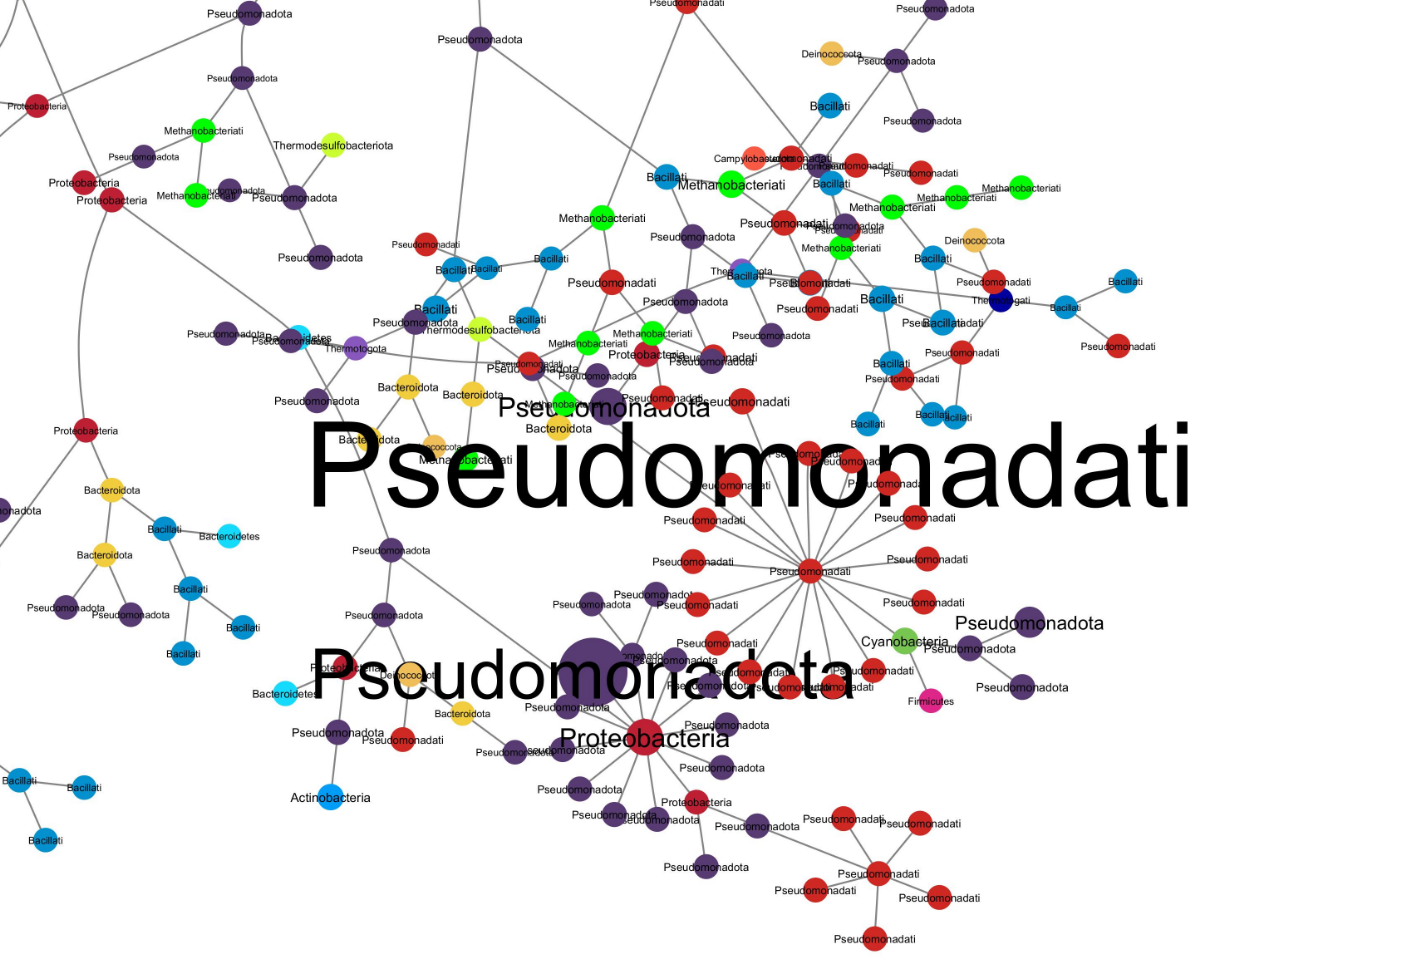
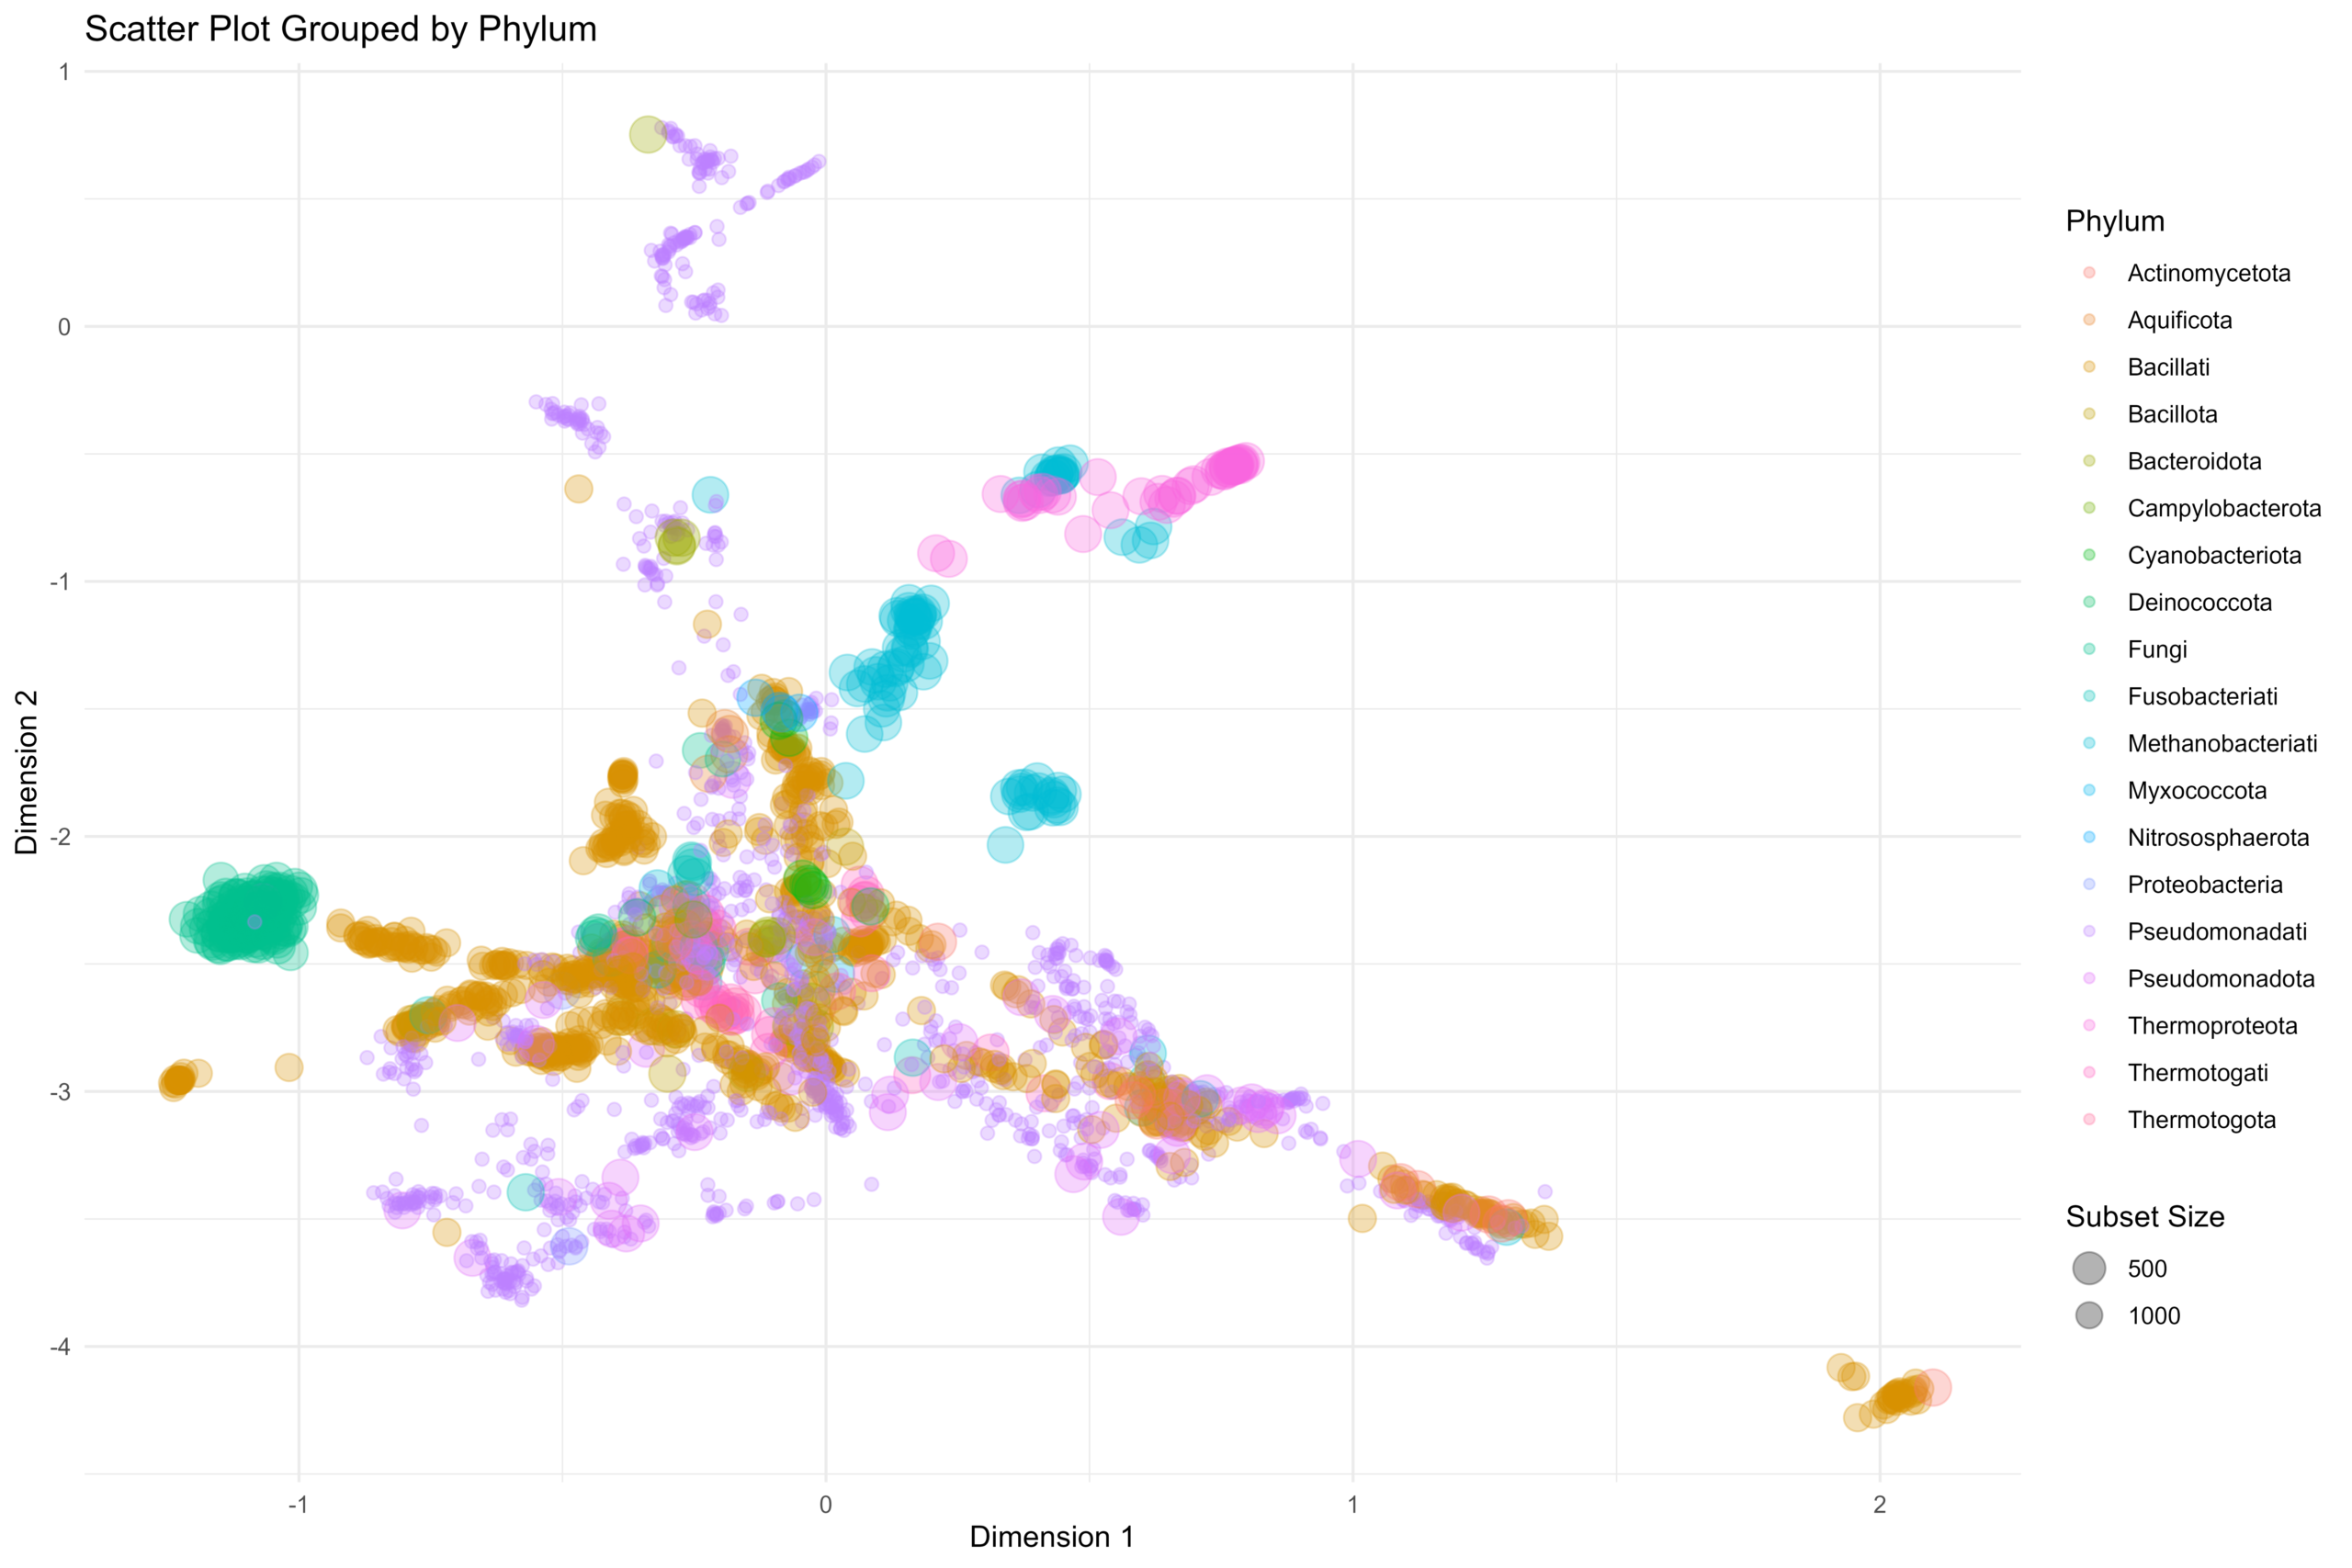
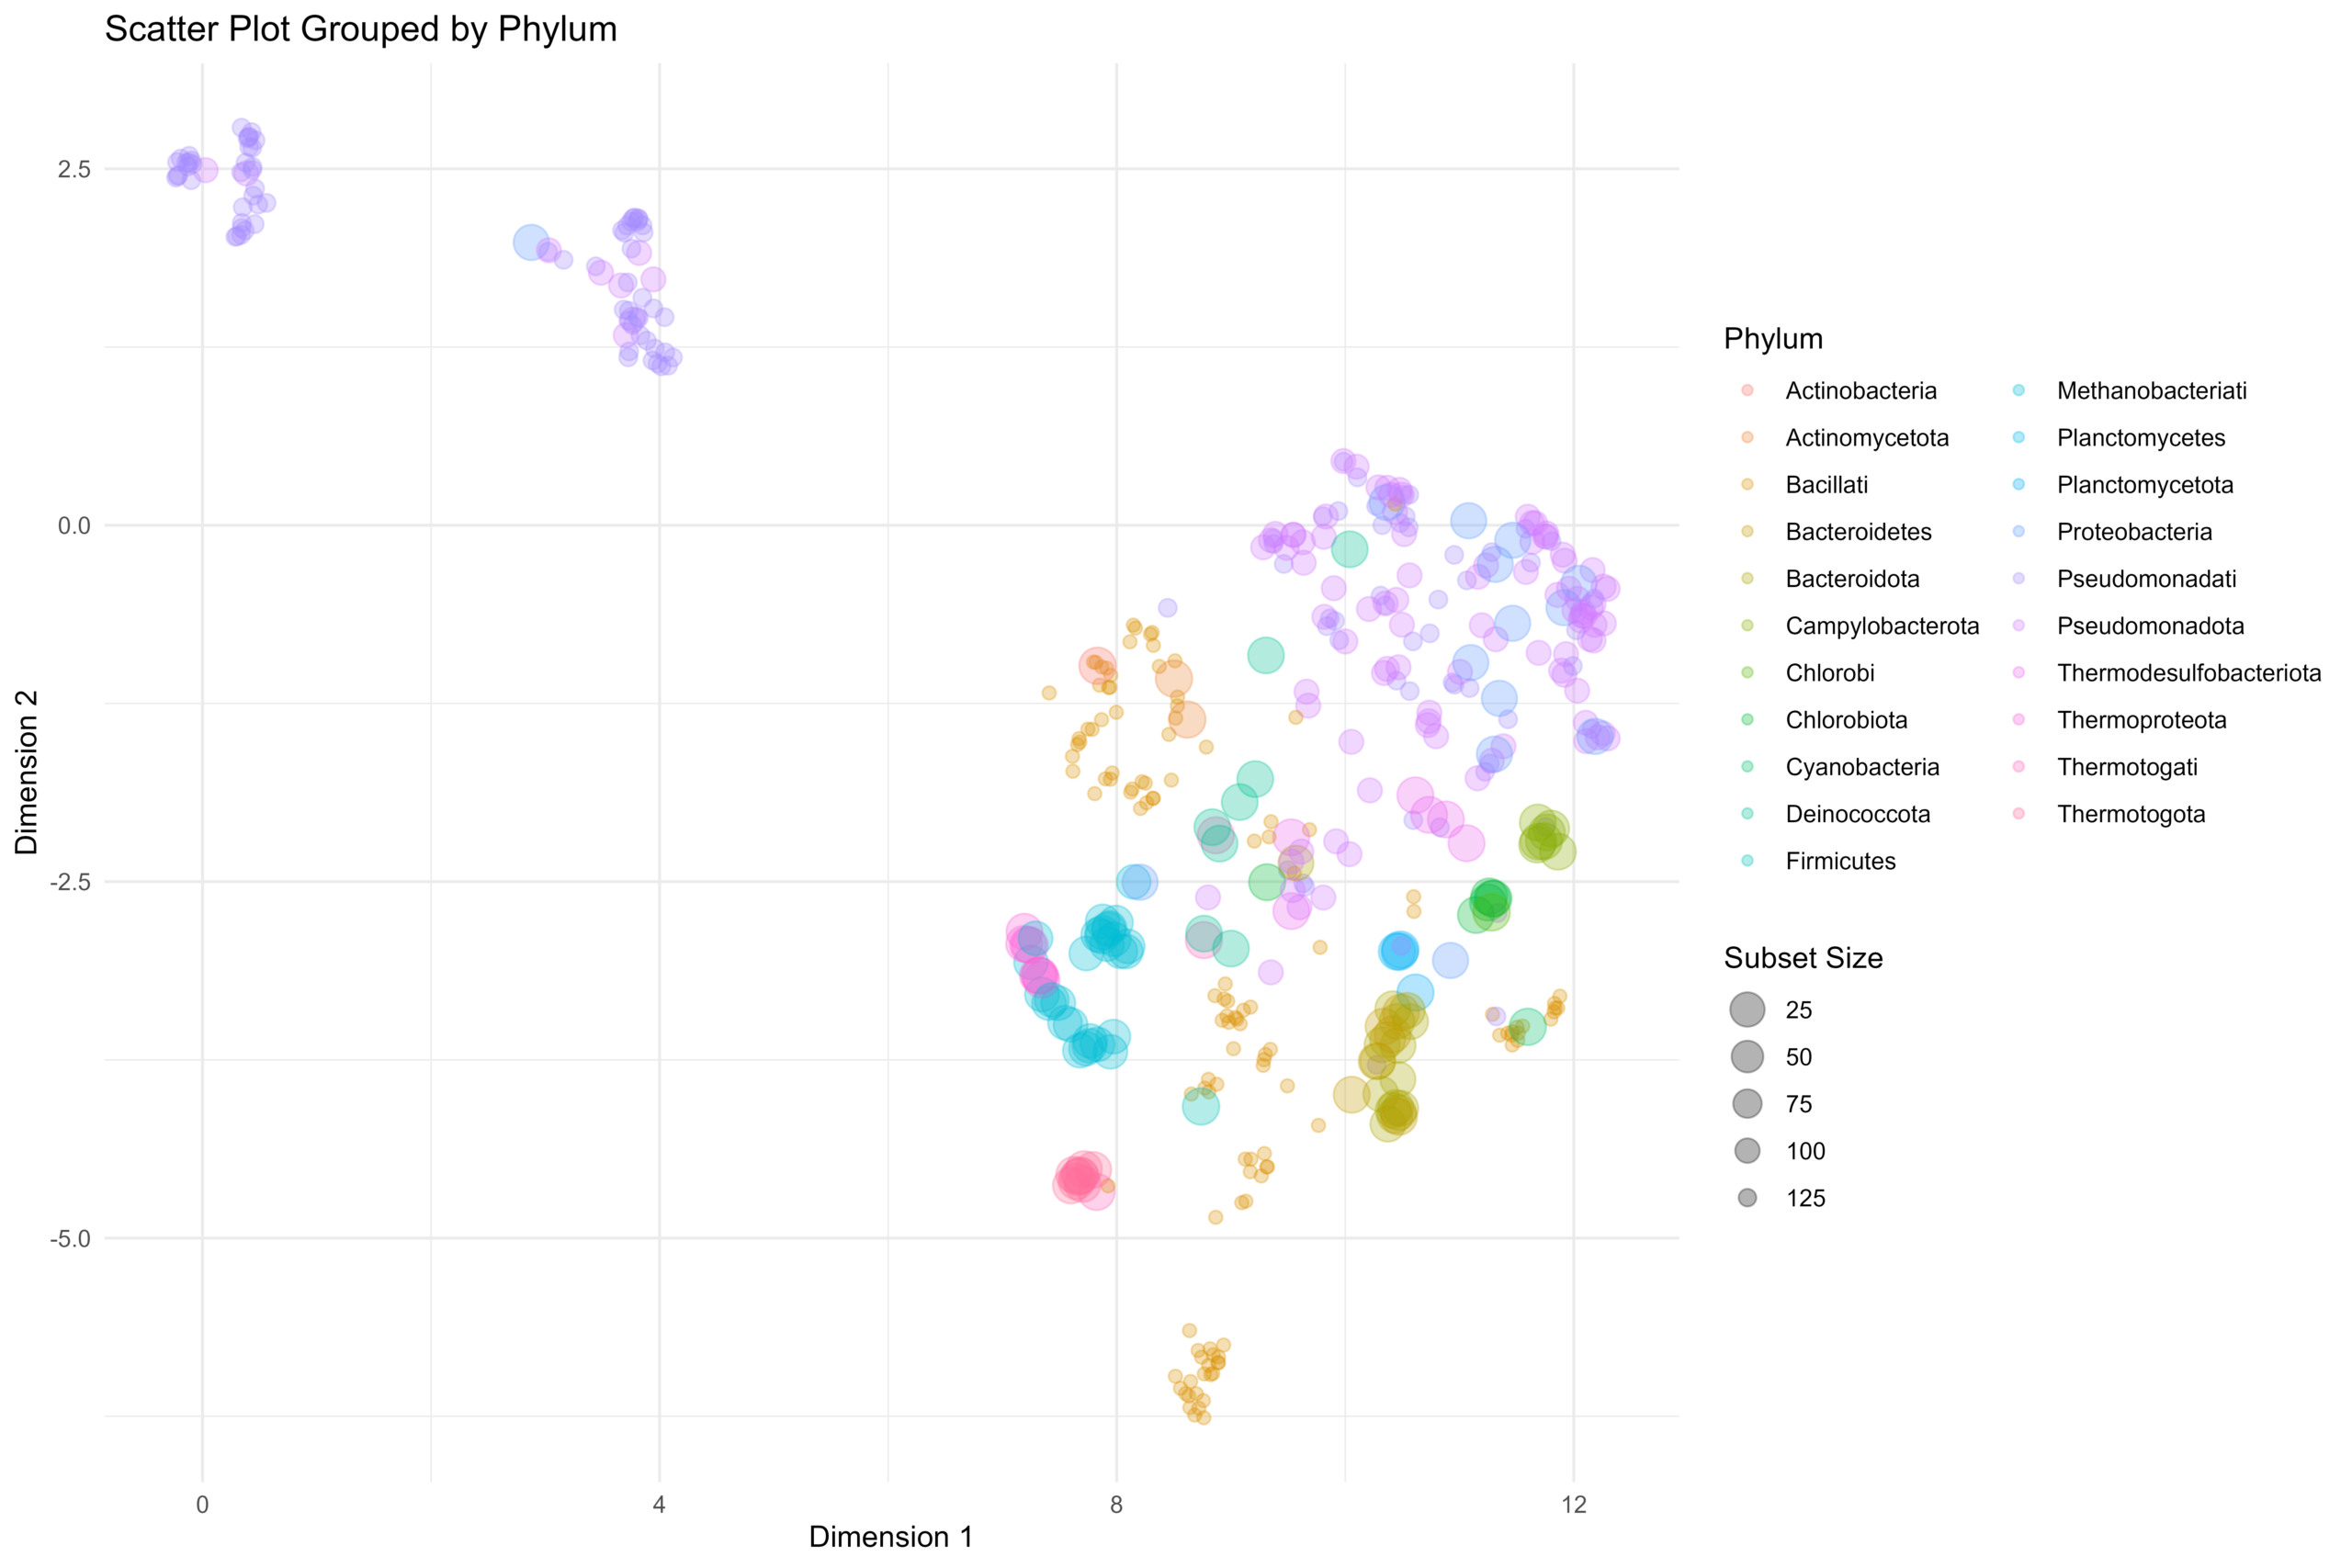
估计阅读时长: 18 分钟在前面的一篇《基因组功能注释(EC Number)的向量化嵌入》博客文章中,针对所注释得到的微生物基因组代谢信息,进行基于TF-IDF的向量化嵌入之后。为了可视化向量化嵌入的效果,通过UMAP进行降维,然后基于降维的结果进行散点图可视化。通过散点图可视化可以发现向量化的嵌入结果可以比较好的将不同物种分类来源的微生物基因组区分开来。除了针对降维后的数据进行散点图可视化,我们还可以直接针对向量化嵌入后的原始嵌入矩阵进行聚类,完成聚类结果的可视化。在这里我们主要是基于嵌入的原始结果进行二叉树聚类可视化。
估计阅读时长: 20 分钟最近的工作中我需要按照之前的这篇博客文章《基因组功能注释(EC Number)的向量化嵌入》中所描述的流程,将好几十万个微生物基因组的功能蛋白进行酶编号的比对注释,然后基于注释结果进行向量化嵌入然后进行数据可视化。通过R#脚本对这些微生物基因组的蛋白fasta序列的提取操作,最终得到了一个大约是58GB的蛋白序列。然后将这个比较大型的蛋白序列比对到自己所收集到的ec number注释的蛋白序列参考数据库之上。
估计阅读时长: < 1 分钟UPGMA(Unweighted Pair Group Method with Arithmetic Mean,非加权配对组平均法)是一种经典的基于距离矩阵构建系统发育树的聚类算法。其核心思想是假设进化速率恒定(分子钟假说),通过迭代合并距离最近的两个类群(或序列)来构建树。UPGMA算法具有原理简单,计算速度快,易于理解和实现。对于符合分子钟假说(即所有分支进化速率相同)的数据,能给出正确的拓扑结构这些优点。但是其“进化速率恒定”的假设在现实中常常不成立。如果数据存在明显的速率差异(即存在长枝),UPGMA可能会构建出错误的树(拓扑结构错误)。因此,它更适用于进化速率相对均匀的近缘物种或基因的比较。
估计阅读时长: 11 分钟在将生物序列(如基因组或蛋白质序列)或文本数据转换为数值向量形式时,TF-IDF(Term Frequency-Inverse Document Frequency)和N-gram One-hot(又称Bag-of-n-grams)是两种经典且基础的文档嵌入算法。它们各自侧重于不同的特征提取方式,常被用于自然语言处理和生物信息学领域。
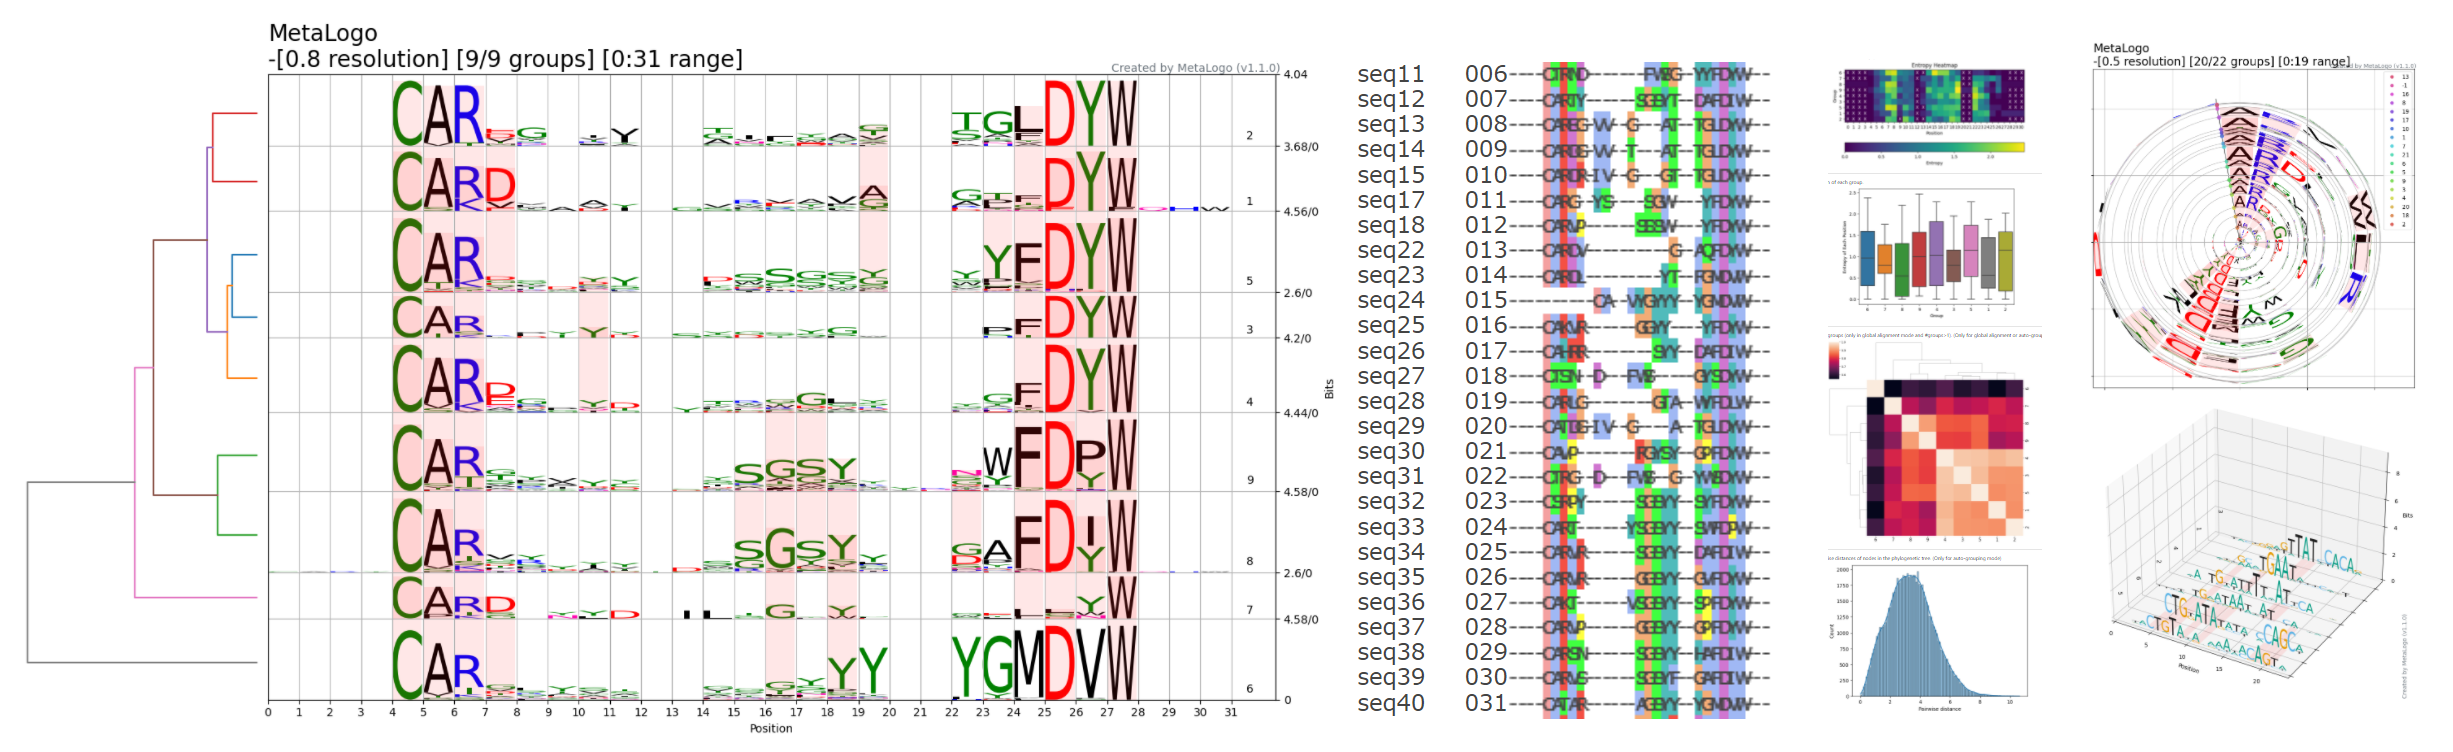
估计阅读时长: 22 分钟MSA(多序列比对)在生物信息学中的核心目标是:通过把多条同源序列“对齐”,来突出它们之间的相似与差异,从而帮助我们:识别保守区/功能位点、推断进化关系(系统发生)、预测或解释蛋白质/核酸结构、发现共进化与功能模块,以及为后续分析(如模体搜索、结构建模、从头设计等)提供基础。基于多序列比对分析,我们可以通过这种算法,把一堆表面看上去“乱糟糟”的序列,整理成一个可以“逐位点比较”的框架。基于我们所得到的这个框架基础,我们可以进行下游的后续分析,例如: 识别哪些部分是“不能动”的(功能/结构核心); 推断它们是如何“进化而来”的(系统发生); 推测它们在空间中“长什么样”(结构预测与建模); 找出哪些部分“一起变化”(共进化与功能耦合); 并把这些信息封装成模型(HMM、profile)用于大规模搜索与注释。

代谢组学那堆名词我上次查资料时也手抄过一页,QC 样本、保留时间、m/z 这些混在一张表里,来回对照着看特别费劲。你这篇把英文缩写和中文解释排在一起,省了我不少翻文献的功夫,尤其是代谢物鉴定那几段。
文中提出的"能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢?"让我想到一个需要先厘清的问题:把Family层级的分类当作细胞分群标签时,功能相似性与亲缘关系可能会混在一起,图上的聚集未必能直接解释为代谢功能接近。如果借用单细胞分析中的降维流程,是否可以同时标注物种分类和基因组注释完整度,看看分离主要对应哪一种差异?尤其是这里用的是EC注释的TF-IDF矩阵,缺少某项注释究竟代表功能缺失还是未被识别,也可能影响对分群结果的判断。
这个角度之前没想到,零分布原理及其在生物信息学中的应用 确实值得深入了解。刚好之前看过,可以对照着看看。
Greetings! I stumbled upon this really useful site and figured I'd thanks for you post at here.
This content speaks to hearts