
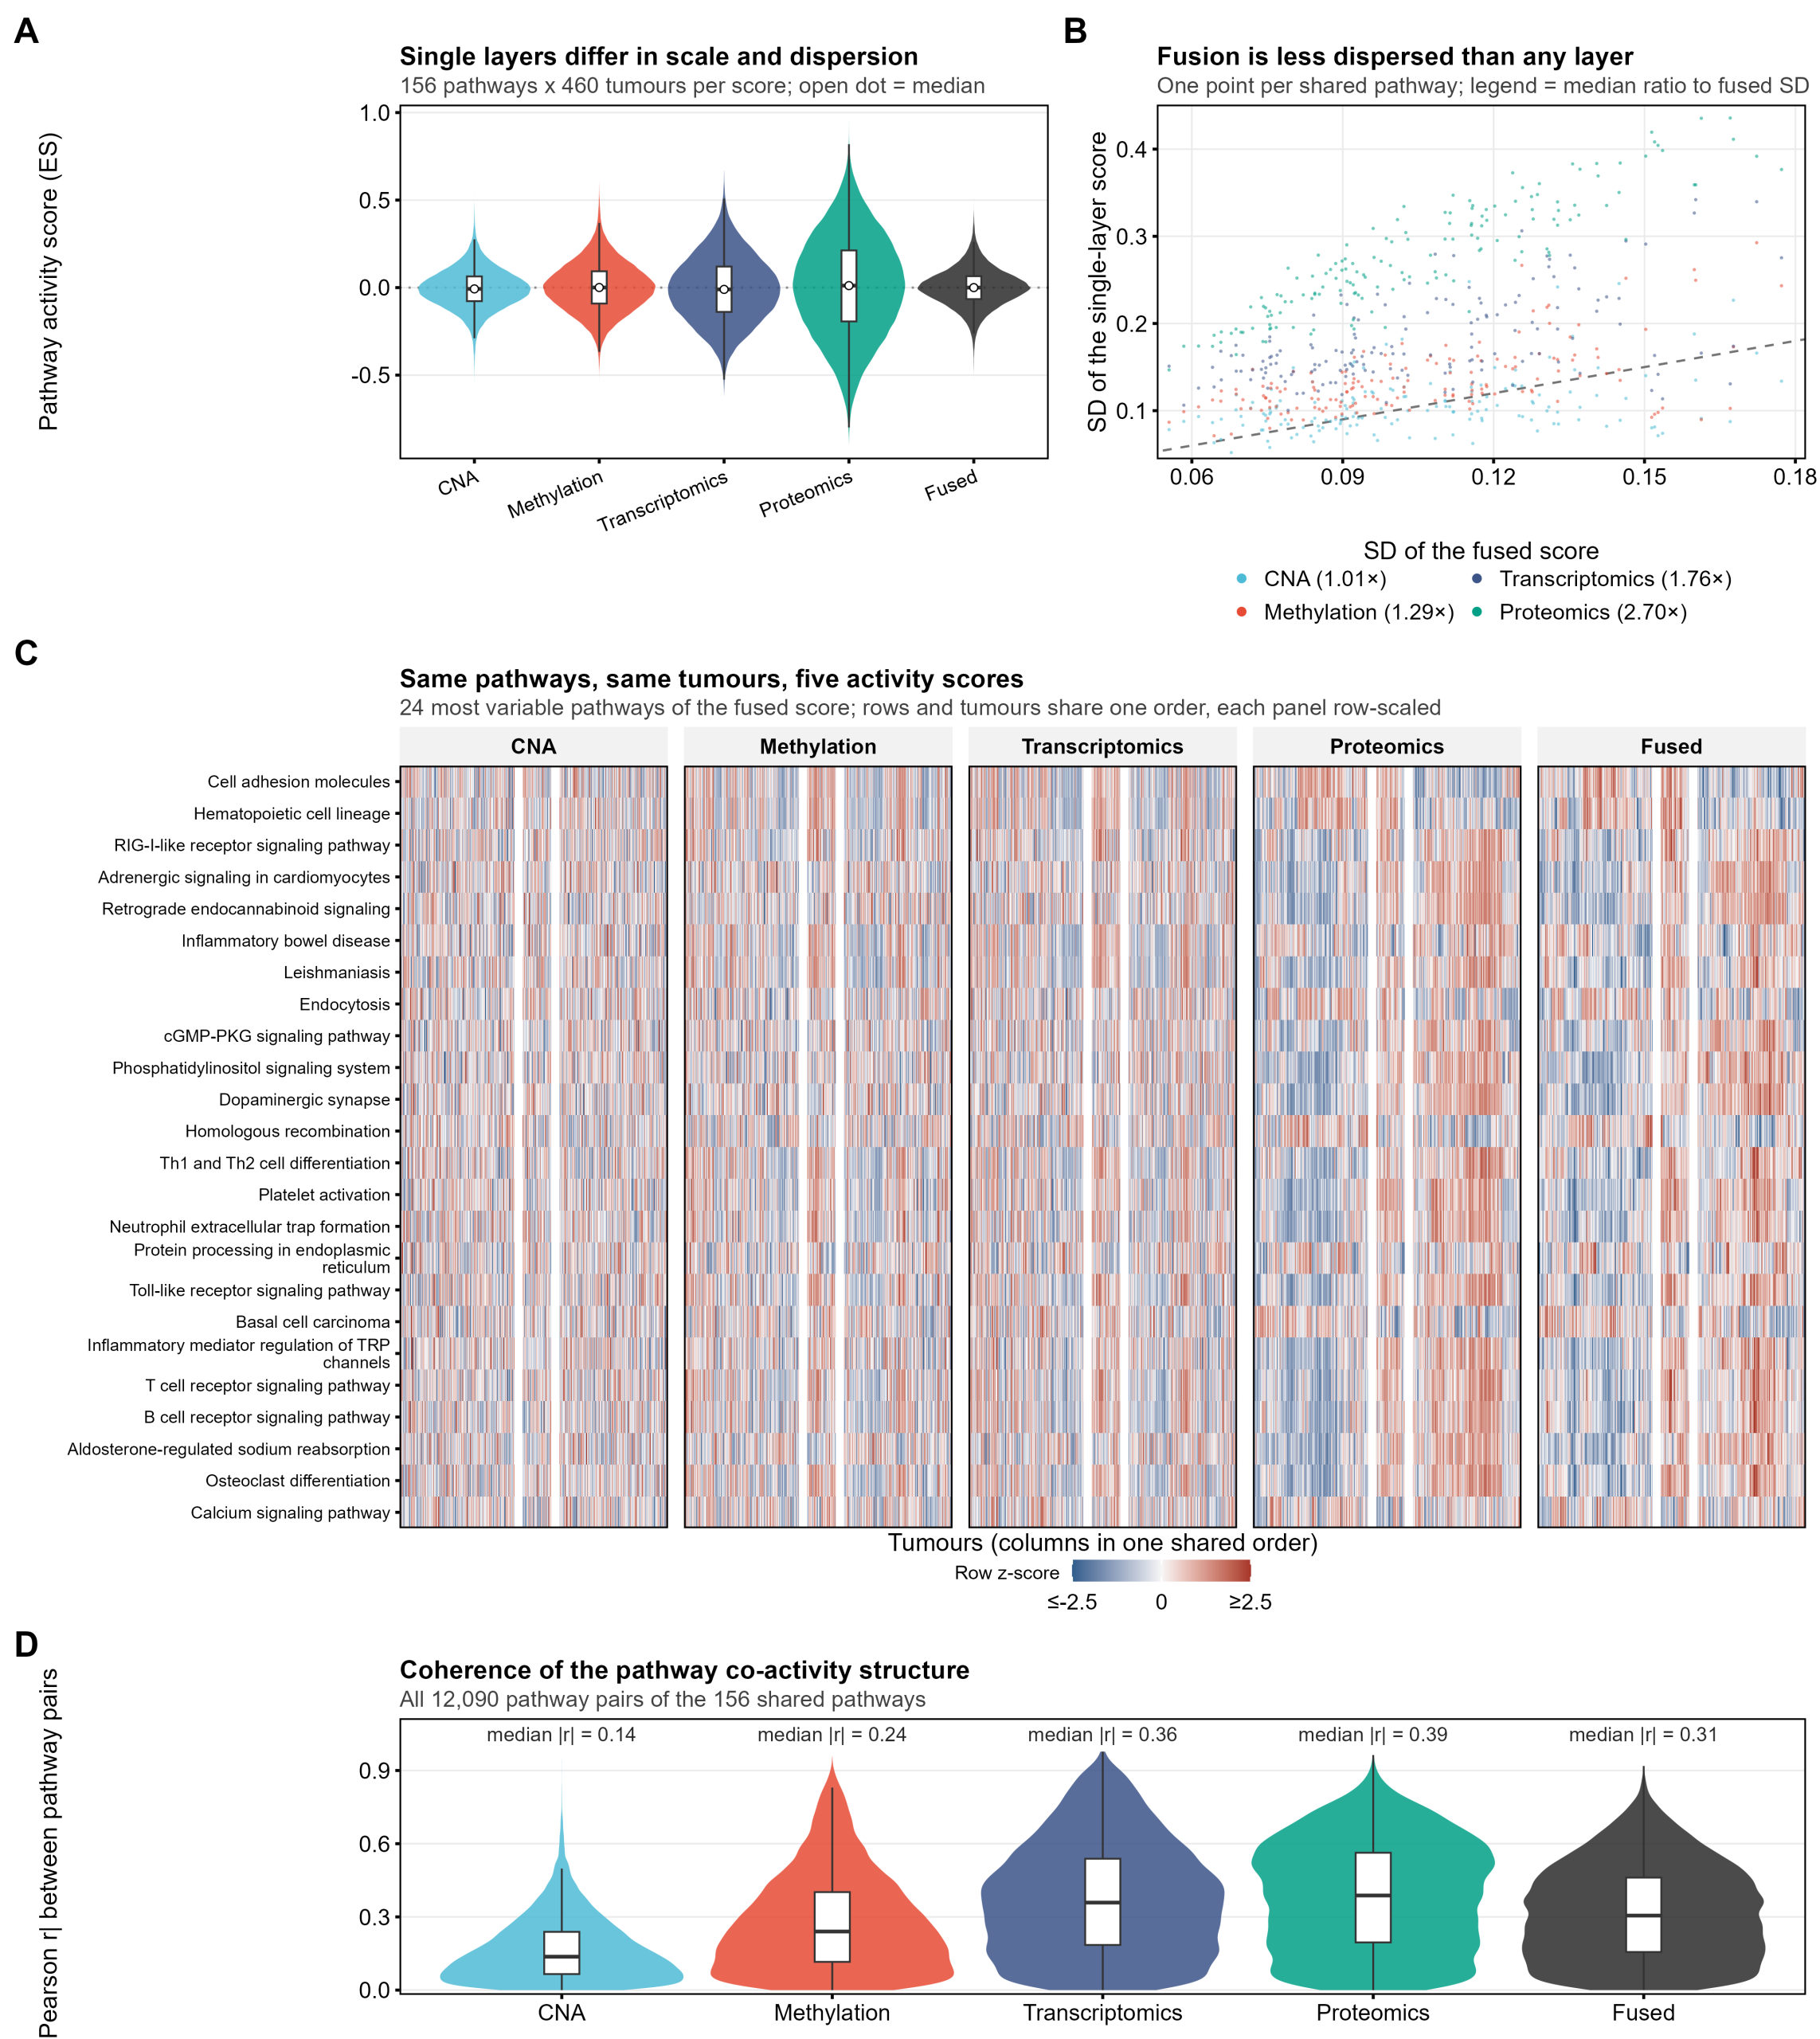
估计阅读时长: 14 分钟460 个乳腺癌、四个组学层、335 条 KEGG 通路。融合分数到底比"逐层算完再平均"强在哪?这篇文章把该泼的冷水泼完,再讲清楚它真正的价值。 面向:生物信息 / 计算生物学方向的研究生 | 预计阅读 30 分钟 数据:TCGA-BRCA(PanCanAtlas 处理版) | 配套:上篇讲数学,本篇讲实证 目录 先看数据:460 个肿瘤怎么变成四个矩阵 疾病背景:乳腺癌根本不是一种病 […]
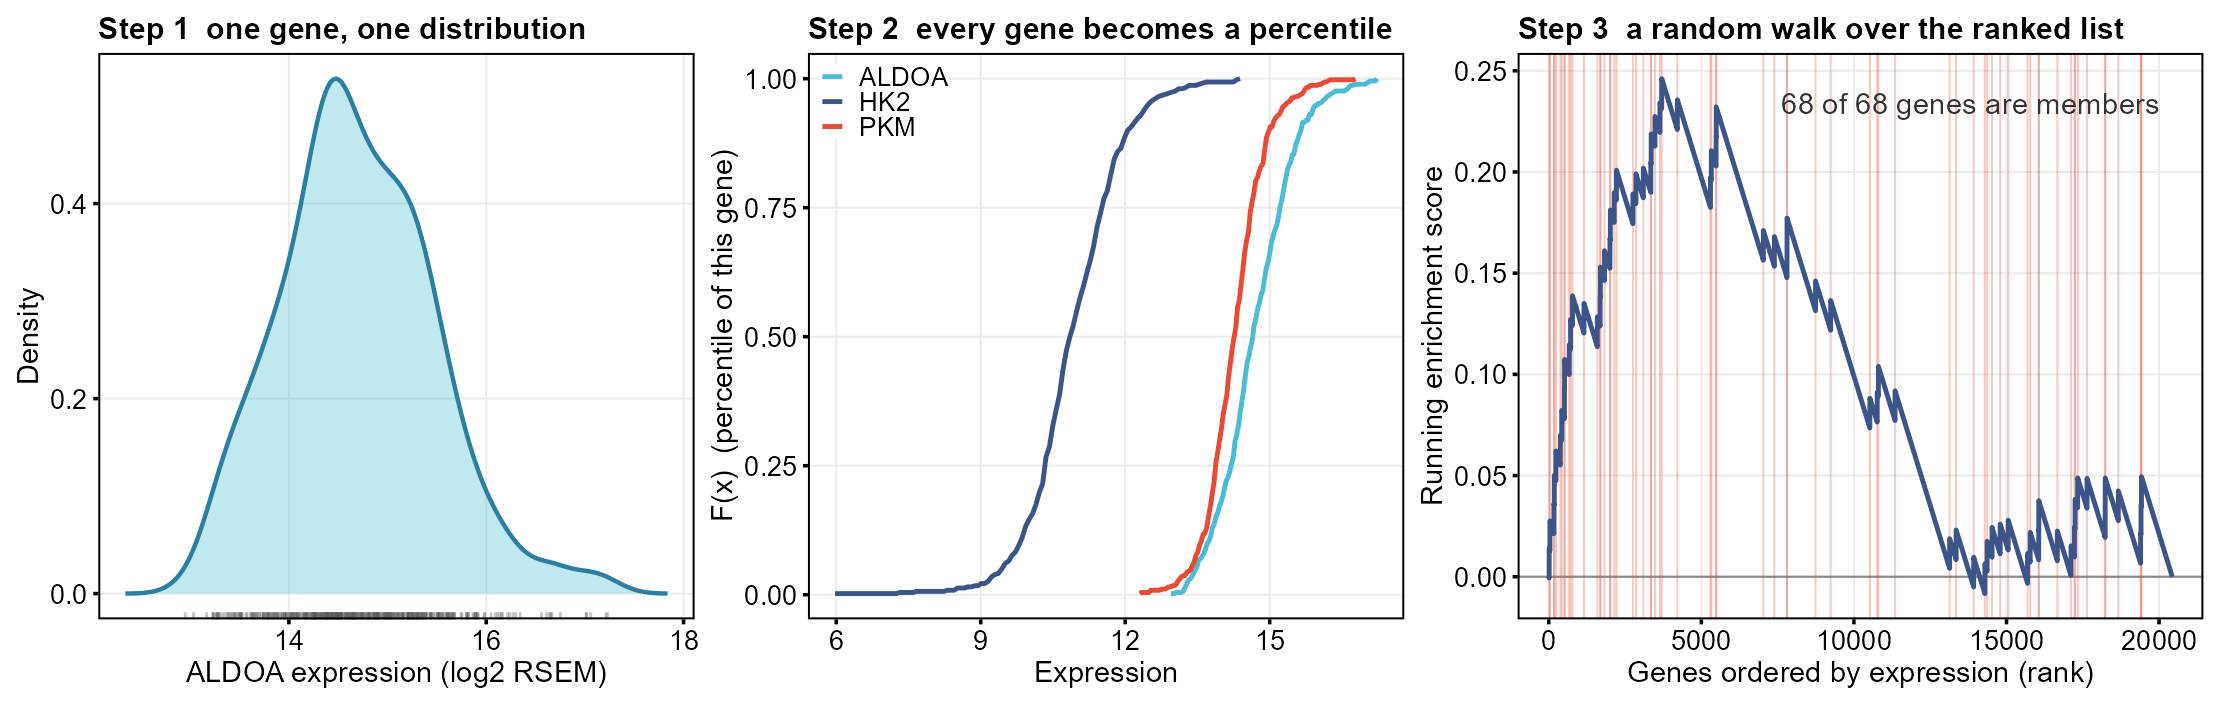
估计阅读时长: 27 分钟单样本的通路打分怎么做?四个组学层又怎么揉成一个数?这篇文章从 KDE 讲到加权融合,全程配伪代码,顺便把 mogsva.R 和它吐出来的十张表拆开讲一遍,尽量让公式看起来不像天书。 面向:生物信息 / 计算生物学方向的研究生 | 预计阅读 25 分钟 目录 一个让审稿人皱眉的问题 GSVA 第一步:给每个基因配一把自己的尺子 GSVA 第二步:把表达量换成"分位数" […]
估计阅读时长: 20 分钟用 GCModeller 做泛基因组分析(二):801 个大肠杆菌基因组实战 面向读者:具有一定 R 语言编程基础的生物信息学初学者、实验室里的微生物研究者。 本篇是系列的实战篇:从 GenBank 原始注释文件出发,用两条 R# 脚本跑完大肠杆菌的泛基因组分析, 并结合真实运行产出的结果文件逐项解读。算法原理(CD-HIT 聚类、PAV 矩阵、香农信息熵等) 请先阅读系列第一篇《用 […]
估计阅读时长: 16 分钟用 GCModeller 做泛基因组分析(一):算法原理与香农信息熵 面向读者:具有一定 R 语言编程基础的生物信息学初学者、实验室里的微生物研究者。 本篇讲清楚两件事:GCModeller 的泛基因组分析是怎么算的,以及贯穿整个分析体系的"香农信息熵"到底在度量什么。 全文不依赖任何编程知识,算法原理一律用公式和自然语言伪代码讲解。实战操作请看系列第二篇。 1. 什么是泛基因组? 把大肠杆菌的两个菌株的基因组摆在一起看,你会发现一个 surprising 的事实:这两个"同一个物种"的基因组,基因组成可能相差 20% 以上。K-12 […]
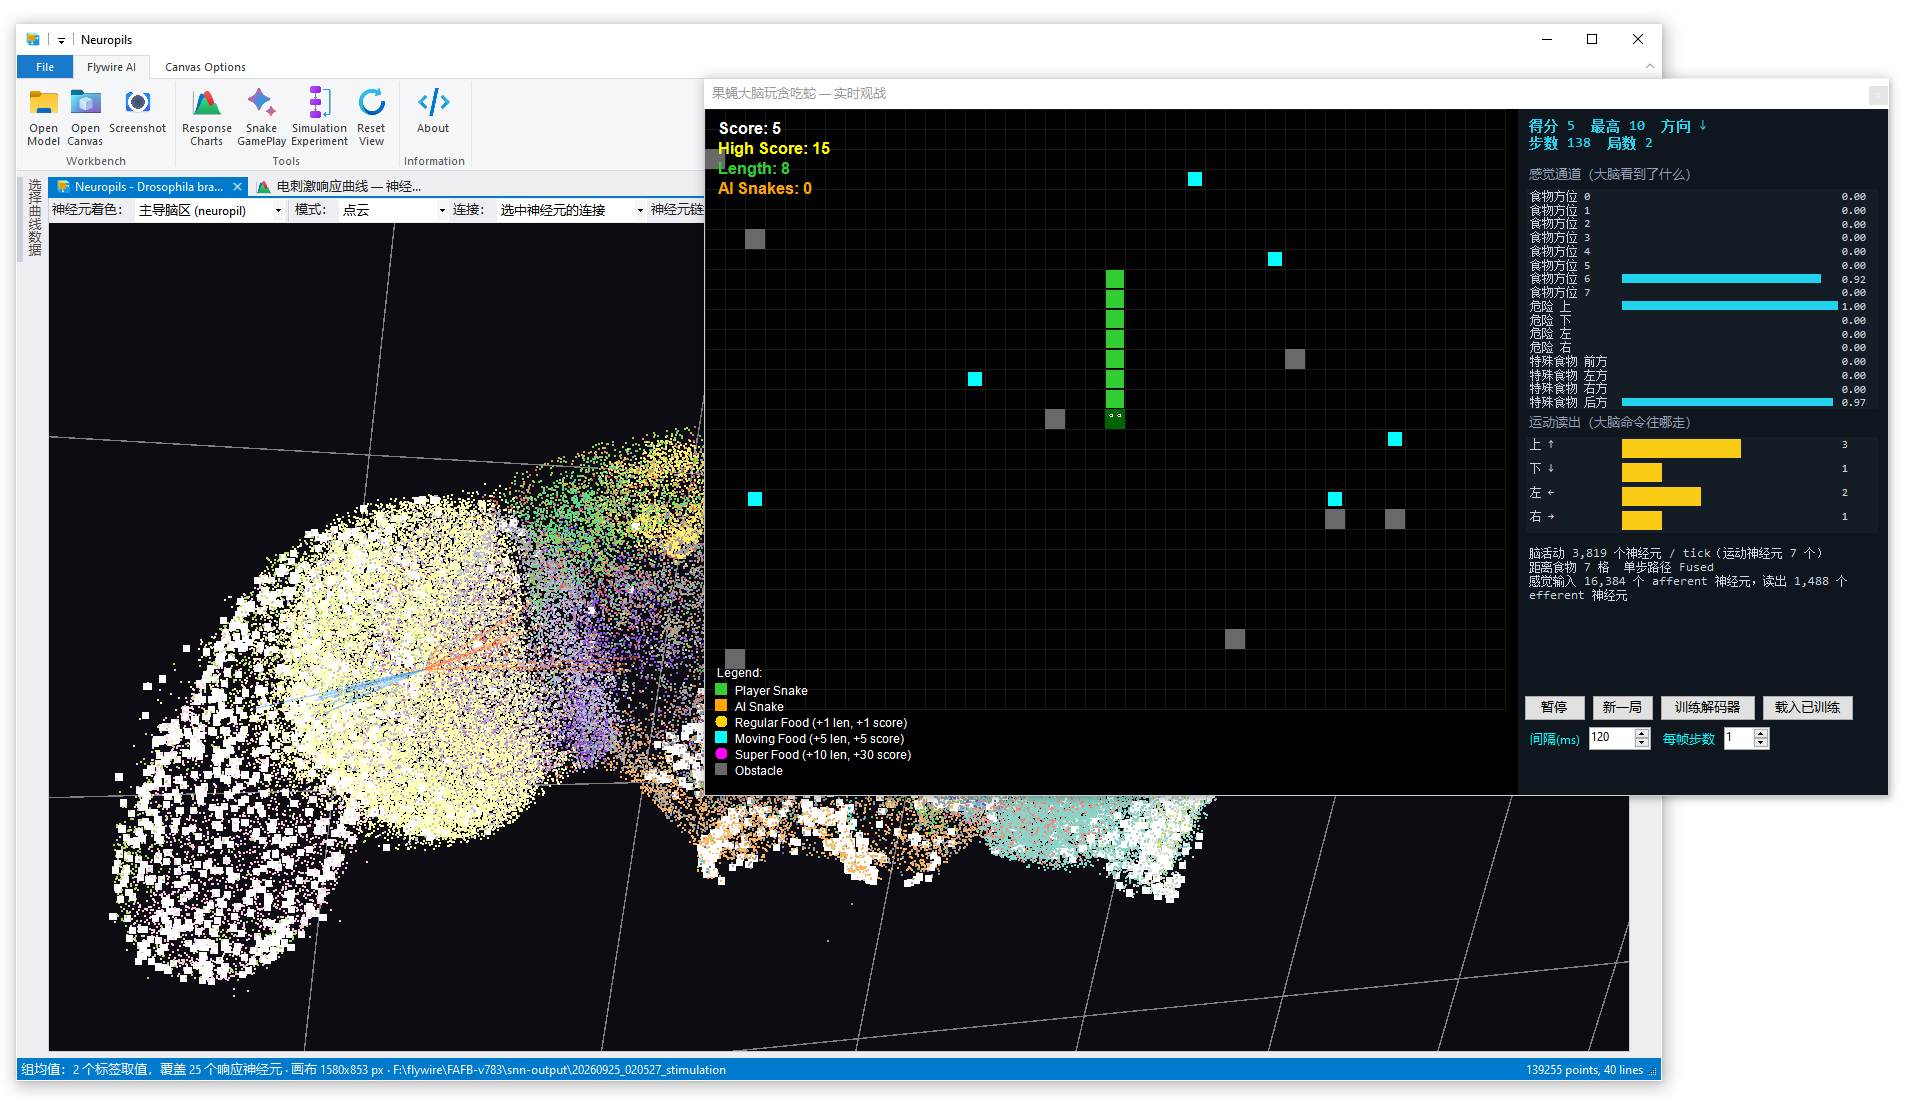
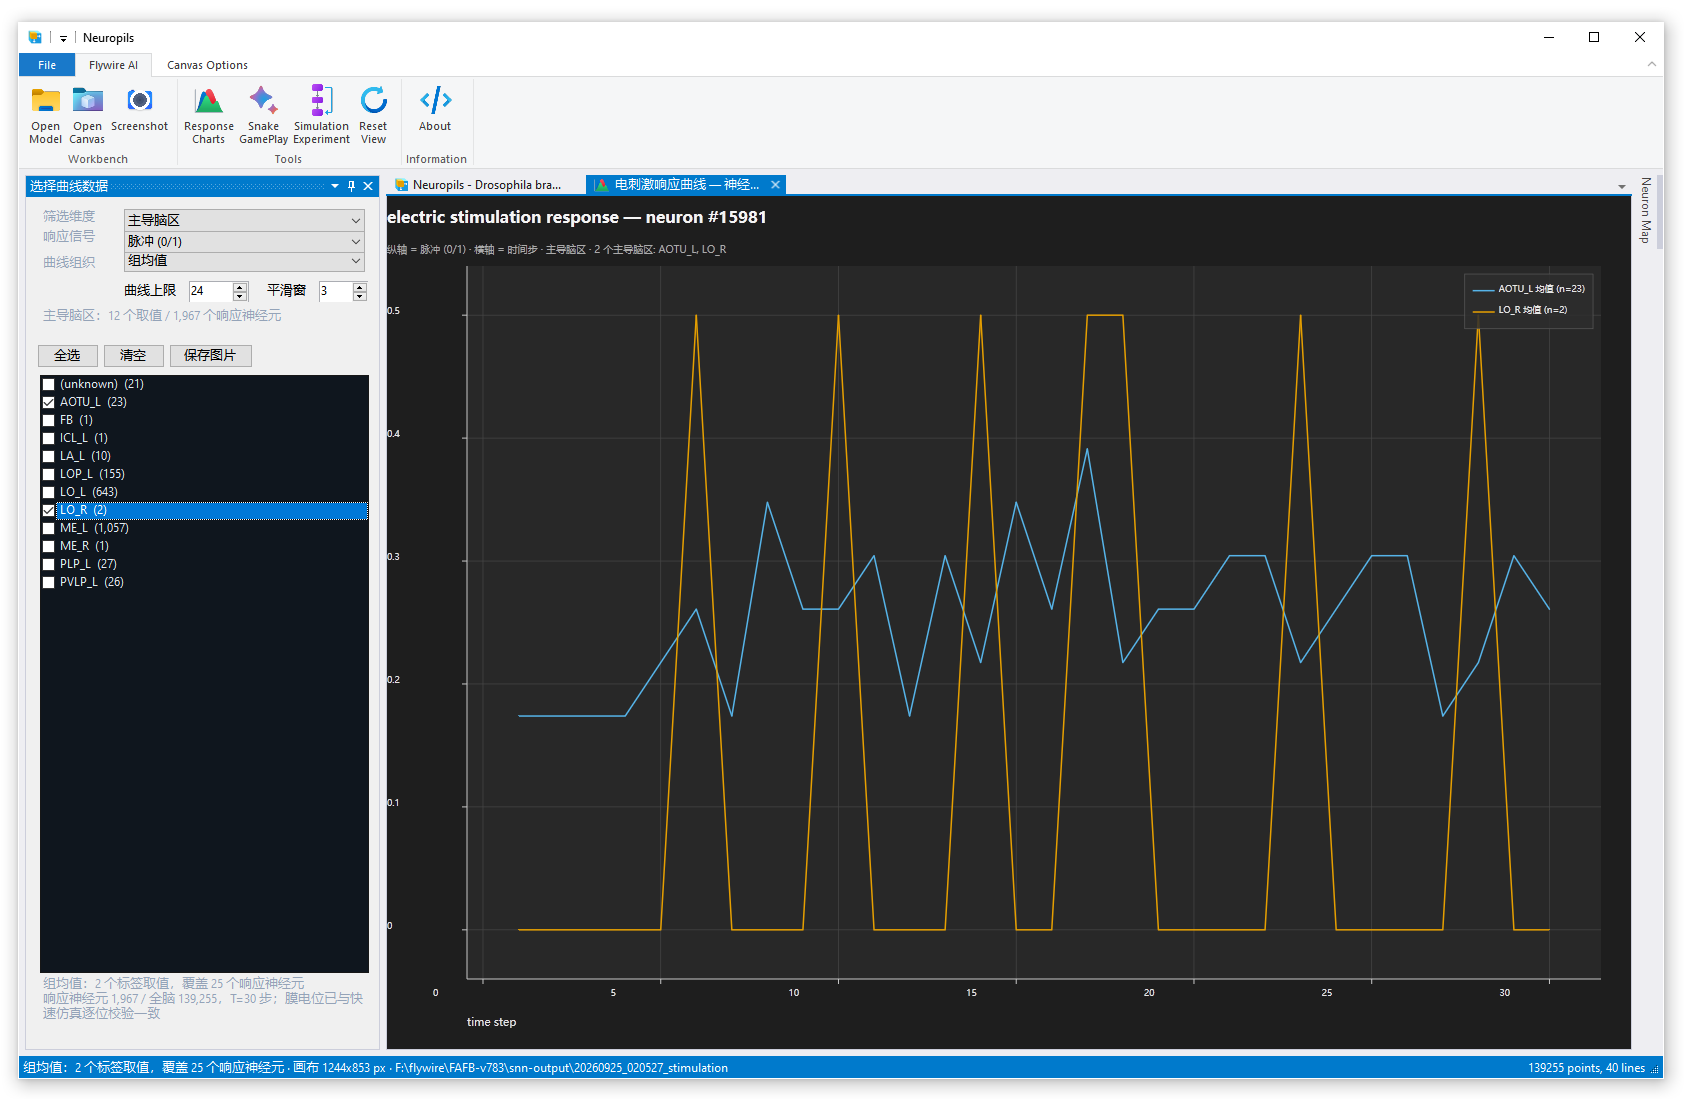
估计阅读时长: 10 分钟Github开源地址:https://github.com/xieguigang/flywire 本文是"果蝇赛博生命"三部曲的第三篇,也是高潮篇。前两篇我们讲清了脉冲神经元的"漏水桶"模型(第一篇),以及 FAFB-v783 连接组这张 5000 万条记录的全脑"通话清单"(第二篇)。今天,我们要做两件事:第一,给这只果蝇通电,看看她大脑里哪片区域在亮;第二,把贪吃蛇游戏接进她的大脑,让她自己玩。 然后——因为这篇文章写得足够长——我们顺便讨论一下人类的数字永生、缸中之脑、《黑客帝国》和《流浪地球 2》。坐稳了。
估计阅读时长: 6 分钟Github开源地址:https://github.com/xieguigang/flywire 本文是"果蝇赛博生命"三部曲的第二篇。上一篇我们讲明白了脉冲神经网络(SNN)的原理:神经元是会漏水的桶,脉冲是它们唯一的语言。但一个悬而未决的问题是——桶和桶之间的水管,到底怎么接? 传统的做法是训练出来的。而我们的做法更"莽":直接把一只真实果蝇的全脑接线图下载下来,照着抄。
估计阅读时长: 6 分钟Github开源地址:https://github.com/xieguigang/sciBASIC 本文是"果蝇赛博生命"三部曲的第一篇。我们不讲果蝇,也不讲贪吃蛇,只讲一件事:计算机是如何模仿你的大脑在"想事情"的。 放心,全文不需要任何机器学习背景,需要的只有高中数学,和一个愿意被比喻轰炸的开放心态。
估计阅读时长: 5 分钟基因组 为了能够实现上面所描述的这种基于EC Number的不同层级的加权嵌入,我们在原来的基因组嵌入工具上添加了一个hierarchical选项,用于支持切换为层级嵌入的操作: Imports Microsoft.VisualBasic.Data.Framework Imports Microsoft.VisualBasic.Data.NLP Imports SMRUCC.genomics.Interops.NCBI.Extensions.Pipeline Public Class GenomeMetabolicEmbedding ReadOnly vec As New […]
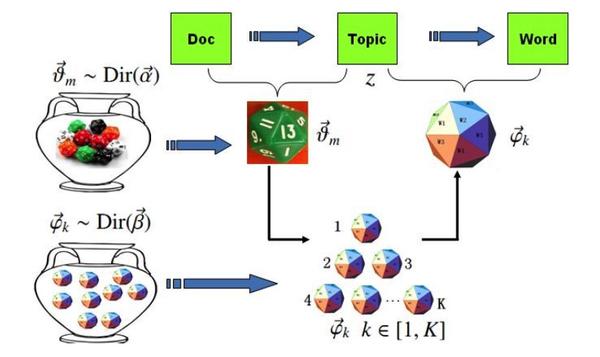
估计阅读时长: 20 分钟LDA(Latent Dirichlet Allocation,潜在狄利克雷分配)是一种用于发现文档集合中潜在主题的生成式概率模型。它假设文档是由多个主题混合而成的,而每个主题又是通过一定的概率分布选择词语生成的。LDA模型包含词、主题和文档三层结构,通过概率生成过程模拟文档的形成。Gibbs LDA 的核心在于使用吉布斯采样方法来推断这些隐藏的主题分布。

代谢组学那堆名词我上次查资料时也手抄过一页,QC 样本、保留时间、m/z 这些混在一张表里,来回对照着看特别费劲。你这篇把英文缩写和中文解释排在一起,省了我不少翻文献的功夫,尤其是代谢物鉴定那几段。
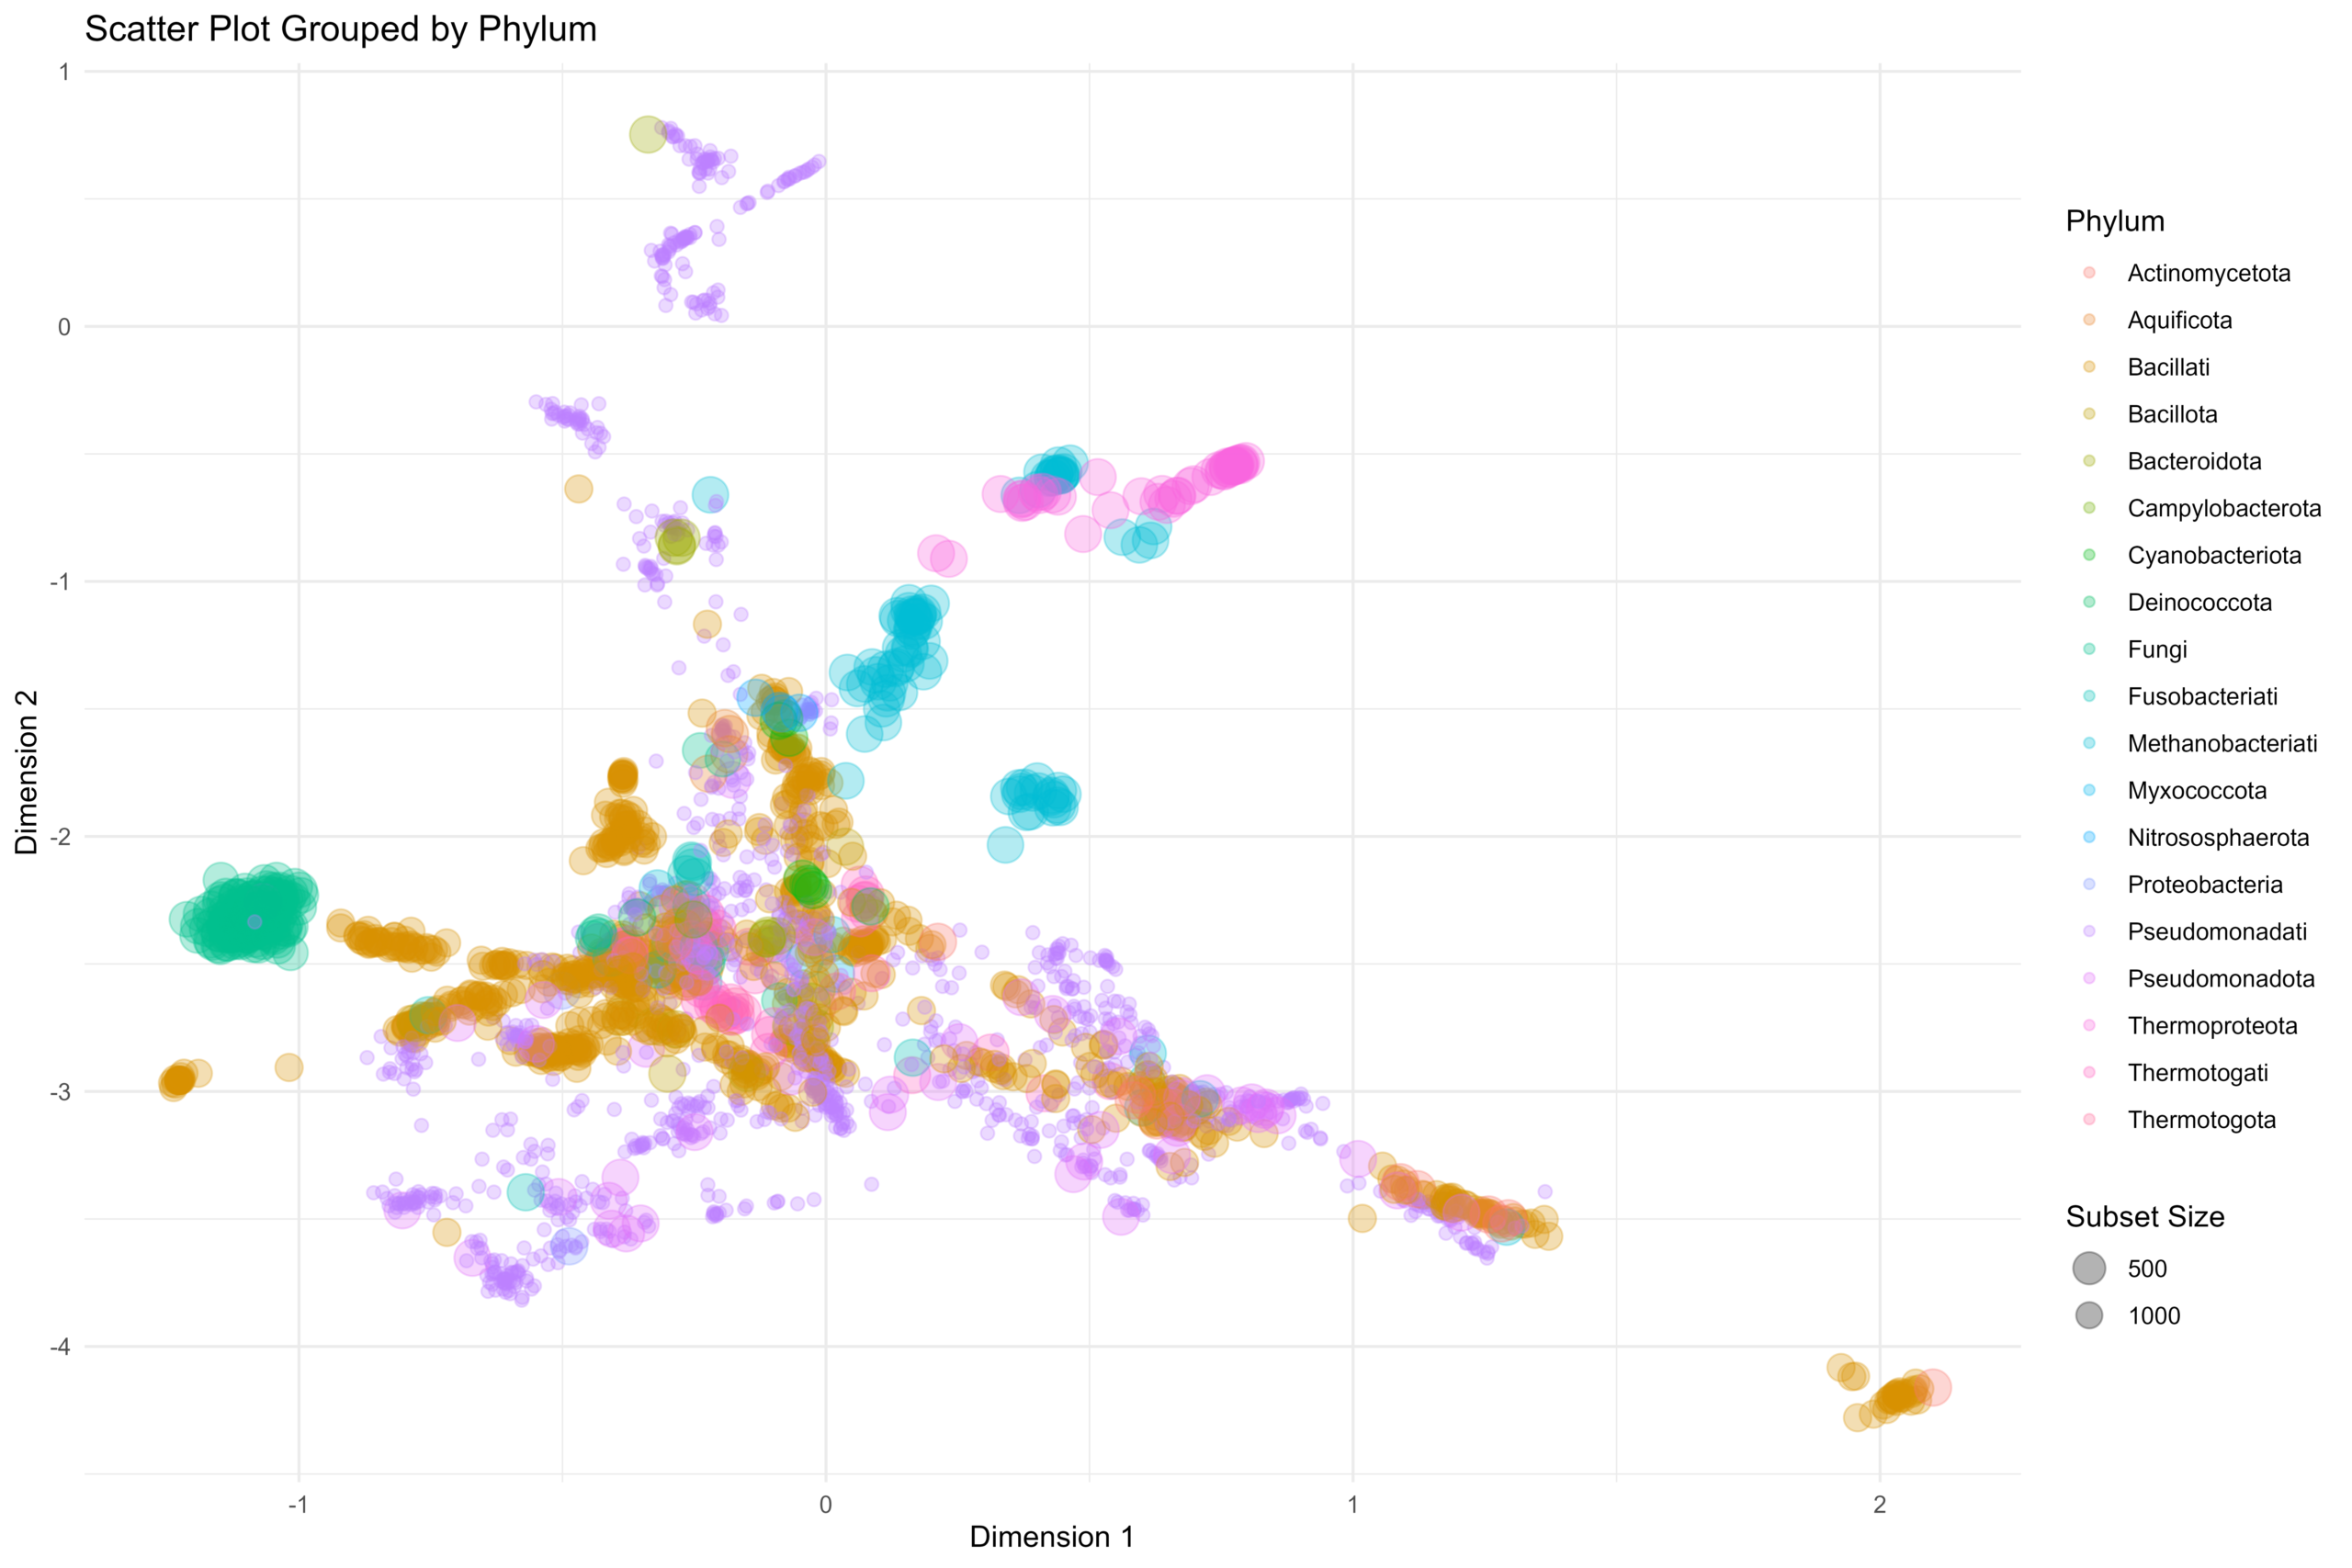
文中提出的"能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢?"让我想到一个需要先厘清的问题:把Family层级的分类当作细胞分群标签时,功能相似性与亲缘关系可能会混在一起,图上的聚集未必能直接解释为代谢功能接近。如果借用单细胞分析中的降维流程,是否可以同时标注物种分类和基因组注释完整度,看看分离主要对应哪一种差异?尤其是这里用的是EC注释的TF-IDF矩阵,缺少某项注释究竟代表功能缺失还是未被识别,也可能影响对分群结果的判断。
这个角度之前没想到,零分布原理及其在生物信息学中的应用 确实值得深入了解。刚好之前看过,可以对照着看看。
Greetings! I stumbled upon this really useful site and figured I'd thanks for you post at here.
This content speaks to hearts