
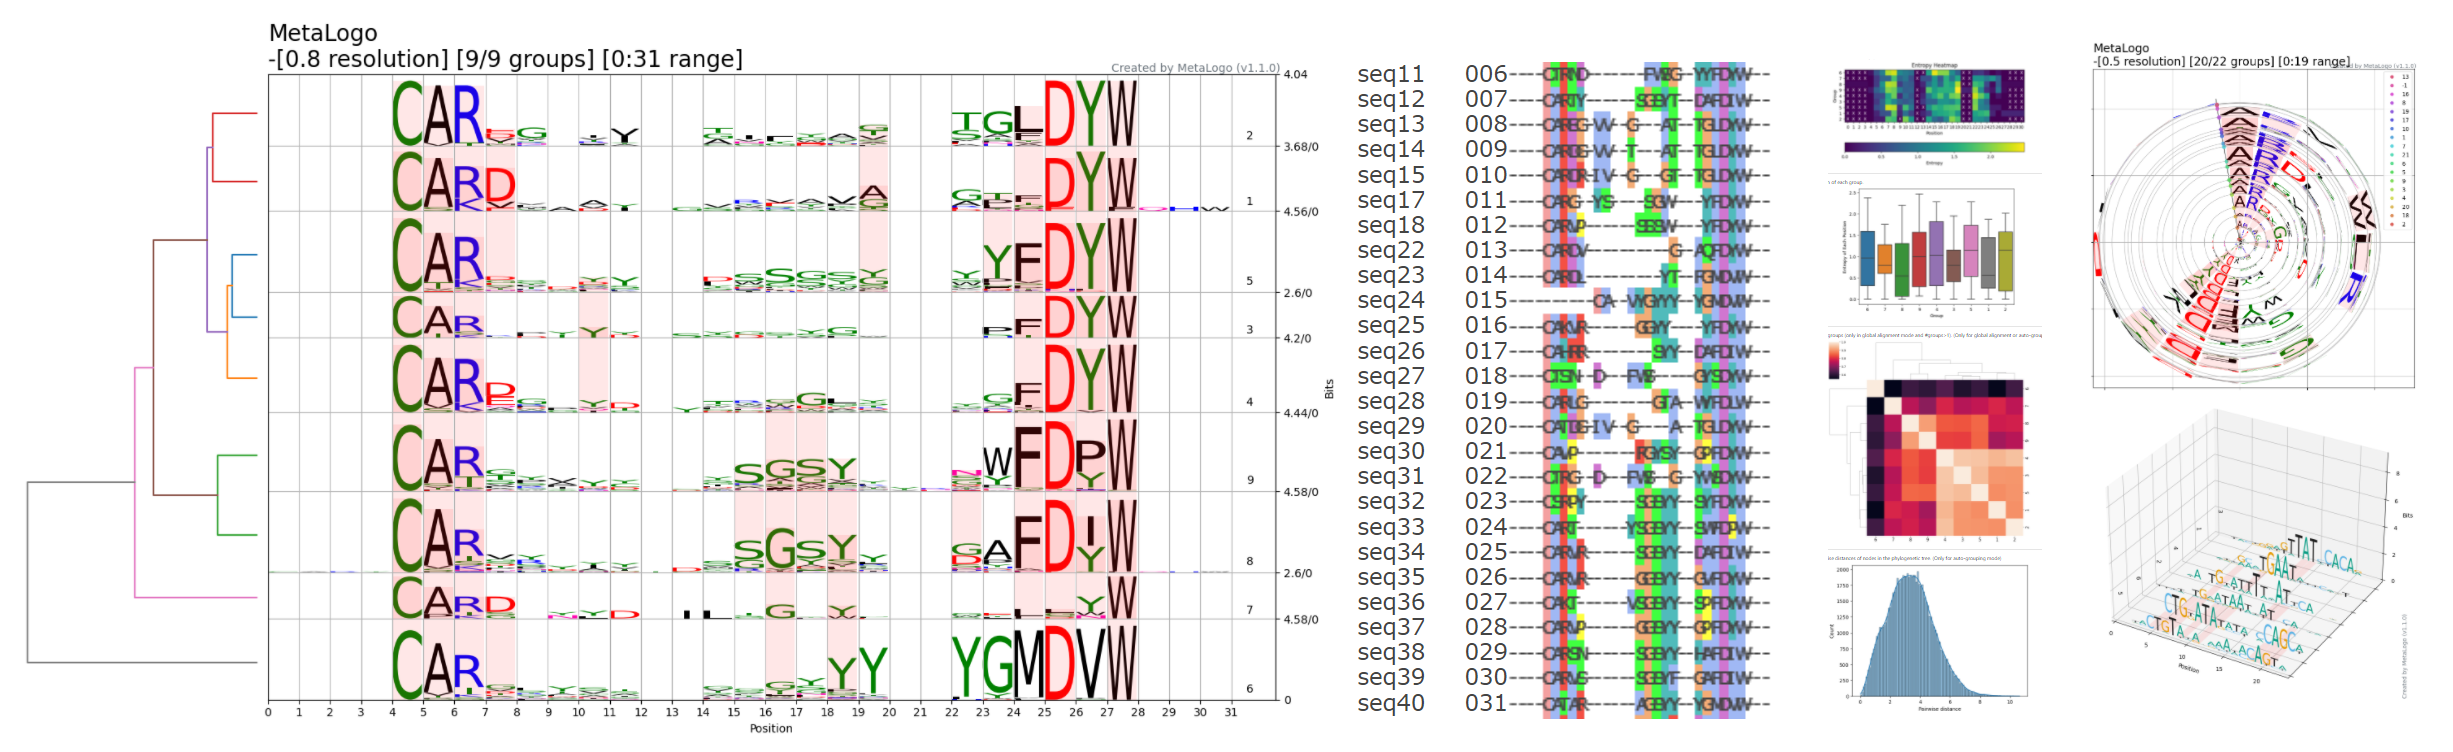
估计阅读时长: 23 分钟Sequence Logo 是一种可视化 DNA 或蛋白质序列保守性的图形表示方法。每个位置(列)上的字母堆叠高度代表该位点的信息含量(以 bits 为单位),而每个字母的高度则与其在该位点出现的频率成正比。高信息量的位置字母堆得高,低信息量的位置则矮甚至接近零。Sequence Logo的绘制遵循信息熵原理,我们可以很直观的通过某一个位置的总高低来了解该处位置的信息含量有多少,高信息量的位置,字母堆的高,一般会出现某一个字符特别高,表明该处非常保守。 位置权重矩阵(Position Weight Matrix, PWM)是描述基因组调控因子结合位点序列模式的核心模型。它通过统计在结合位点序列中每个位置上各核苷酸(或氨基酸)出现的频率,来量化该位置对不同碱基的偏好程度。PWM通常以矩阵形式表示,行对应核苷酸(A、C、G、T/U),列对应序列中的位置,矩阵元素即为该位置该核苷酸相对于背景的权重得分。这一模型简洁且易于计算,因此在转录因子结合位点(TFBS)等调控元件的识别和表征中被广泛采用。
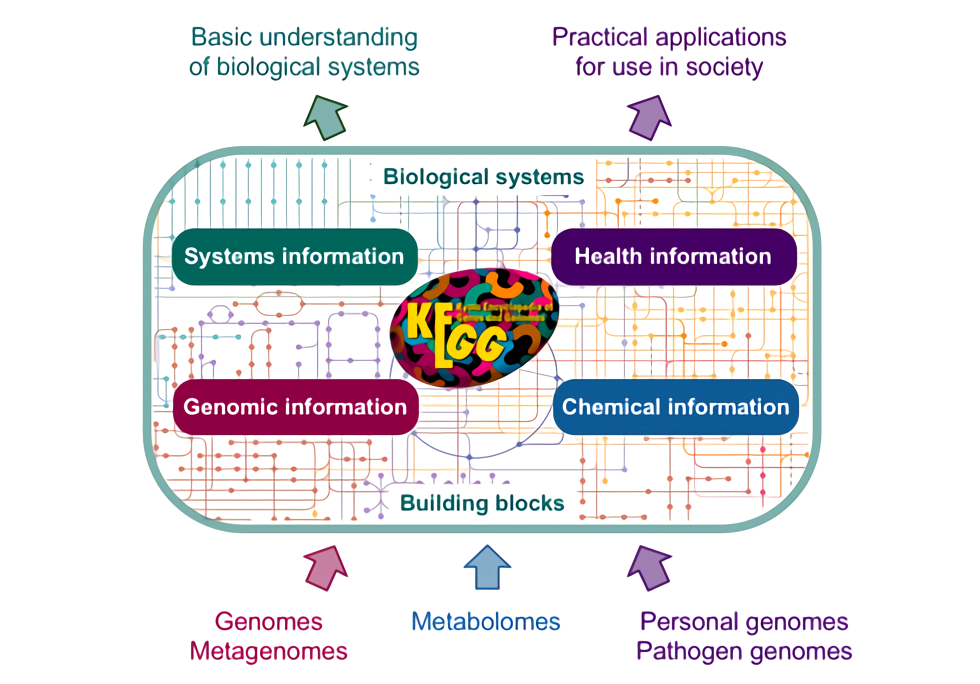
估计阅读时长: 34 分钟在前面写了一篇文章来介绍我们可以如何通过KEGG的BHR评分来注释直系同源。在KEGG数据库的同源注释算法中,BHR的核心思想是“双向最佳命中”。它比简单的单向BLAST搜索(例如,只看你的基因A在数据库里的最佳匹配是基因B)更为严格和可靠。在基因注释中,这种方法可以有效减少因基因家族扩张、结构域保守等原因导致的假阳性注释,从而更准确地识别直系同源基因,而直系同源基因通常具有相同的功能。在今天重新翻看了下KAAS的帮助文档之后,发现KAAS系统中更新了下面的Assignment score计算公式: We define a score for each ortholog group in order to assign the best […]
估计阅读时长: 5 分钟将复杂的生物学过程拆解为单元化学反应,是进行定量模拟的基石。转录是基因表达调控的关键环节,决定了细胞在特定时间、特定环境下合成哪些蛋白质,对生命活动至关重要。最近的工作中需要将原本非常粗糙的虚拟细胞转录事件模型拆解为更加细分化的多步骤生物化学过程,以适应针对细胞群落生长的建模计算。下面为我将原核生物的转录过程拆解为一系列可以用化学式表示的单元步骤的结果。 在介绍这些分步骤之前,我们会需要首先来定义一下模型中会用到的各种“化学物质”(分子和复合物): RNAP: RNA聚合酶全酶(包含核心酶和σ因子)。 DNA: 基因组DNA双链。 DNA_P: 包含启动子区域的DNA。 DNA_T: 包含终止子区域的DNA。 NTP: 核糖核苷三磷酸(ATP, UTP, GTP, CTP的统称)。 PPi: […]
估计阅读时长: 27 分钟宏基因组测序直接从环境样本获取所有生物的遗传物质,产生的海量短读序列(reads)需要被快速准确地分类到不同物种或功能类别。然而,宏基因组数据具有复杂性高、物种多样且未知序列多等特点,这给分类算法带来了巨大挑战。传统的序列比对方法虽然准确,但在面对庞大的参考数据库时计算开销巨大,难以满足实时分析的需求。因此,研究者开发了多种基于k-mer(长度为k的子序列)的快速分类方法,其中布隆过滤器(Bloom Filter)作为一种高效的概率数据结构,在针对测序reads做物种上的快速分类这项工作中起到了一些关键作用。
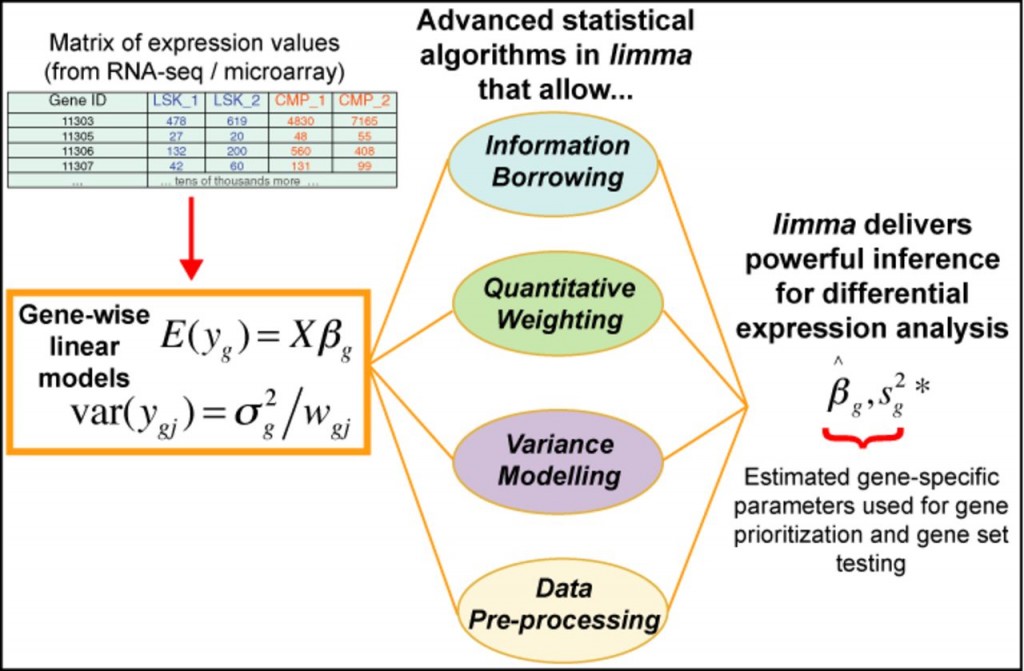
估计阅读时长: 22 分钟limma(Linear Models for Microarray Data)是一个基于R语言的Bioconductor包,最初用于微阵列数据的差异表达分析,现已扩展支持RNA-seq数据。其核心思想是利用线性模型(Linear Models)对基因表达数据进行建模,并结合经验贝叶斯(Empirical Bayes)方法在小样本情况下增强统计推断的稳健性。

估计阅读时长: 30 分钟零分布(null distribution)是指在假设零假设(null hypothesis)成立的情况下,某个统计量随机取值的概率分布。在统计假设检验中,我们通常提出一个零假设(例如“两组数据没有显著差异”或“观察到的模式仅由随机因素造成”),然后根据观测数据计算一个检验统计量。零分布描述了这个统计量在零假设为真时的分布情况。通过将实际观测到的统计量与零分布进行比较,我们可以计算出P-value:即在零假设下,出现等于或更极端观测结果的概率。如果P-value很小(例如低于预设的显著性水平α),我们就认为零假设不太可能成立,从而拒绝零假设,认为观测结果是统计显著的。
估计阅读时长: 14 分钟宏基因组测序所处理的对象是直接对环境样本中的所有DNA进行测序。达到无需培养即可揭示微生物群落的组成和功能潜力的目的。在数据处理中,一个核心任务是从海量短读序列中估算物种丰度(即每个物种在样本中的相对含量)和基因丰度(即每个基因或功能单元的相对含量)。传统的基于序列比对的方法计算成本高昂,而基于k-mer的方法通过利用固定长度的子序列(k-mer)信息,能够在不依赖完整比对的情况下快速估算丰度。 k-mer是指长度为k的连续子序列,例如在k=2的时候,DNA序列“ATCG”包含的2-mers有“AT”、“TC”、“CG”。通过统计读序列中k-mer的出现频率,并将其与参考数据库中的k-mer频率进行比较,我们可以推断出样本中各物种或基因的丰度。这种方法具有计算速度快、内存效率高的优势,并且无需对每个读进行精确比对,因此在处理大规模宏基因组数据时非常实用。
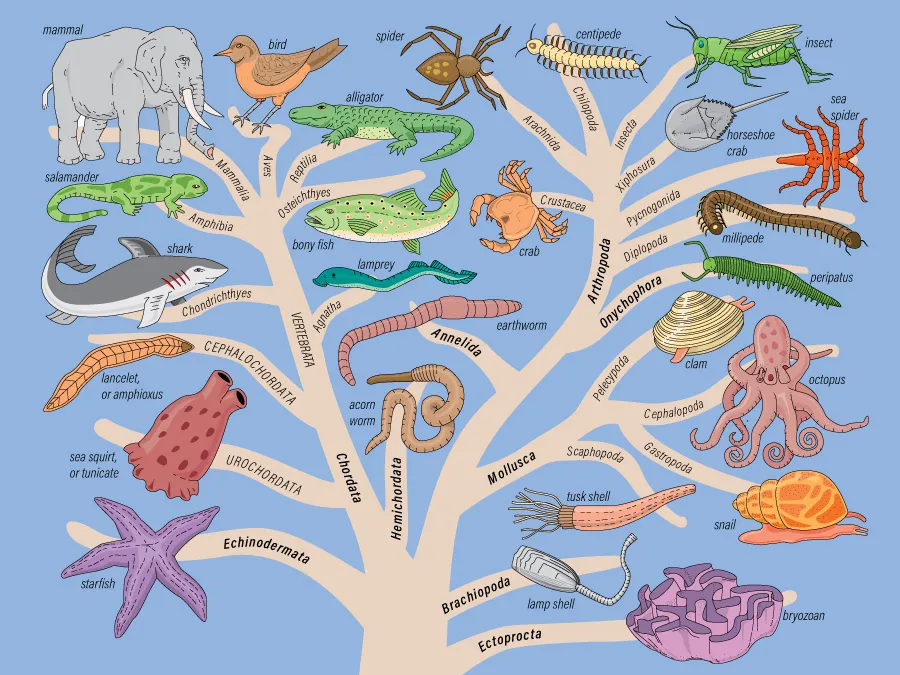
估计阅读时长: 13 分钟LCA算法是现代宏基因组学分析的核心技术之一,主要用于解决序列比对结果的分类不确定性问题。例如,我们在处理宏基因组测序reads的物种来源分类注释工作的时候,经常会思考一个问题:在宏基因组分析中,一个测序read通常与多个参考序列产生比对结果,这些结果可能指向不同的分类单元。那这条reads最可能的物种分类来源位置是怎样的,怎样可以通过一个算法,基于一系列的物种匹配结果来推断出一个合适的物种来源,既避免过度分类,又保证分类的准确性。
估计阅读时长: 2 分钟宏基因组学(Metagenomics)通过直接测序环境样本中的全部DNA,从而避免了传统培养方法的局限,使我们能够研究不可培养微生物的多样性。然而,当样本来自宿主相关环境(如人类或小鼠的肠道、土壤等)时,测序数据中不可避免地包含大量宿主自身的DNA序列。这些宿主序列会占据测序读数,增加分析成本,并可能干扰对微生物群落组成的准确推断。因此,在宏基因组数据分析中,去除宿主序列(Host Sequence Removal)是至关重要的预处理步骤。去除宿主序列的算法多种多样,其中基于k-mer的方法因其高效和可扩展性而备受关注。
估计阅读时长: 6 分钟微生物全基因组代谢网络(Genome-scale metabolic model, GEM)模型的发展历史可追溯至20世纪90年代。1994年,Varma和Palsson在《Applied and Environmental Microbiology》期刊上发表了开创性论文,题为"Stoichiometric flux balance models quantitatively predict growth and metabolic by-product […]

代谢组学那堆名词我上次查资料时也手抄过一页,QC 样本、保留时间、m/z 这些混在一张表里,来回对照着看特别费劲。你这篇把英文缩写和中文解释排在一起,省了我不少翻文献的功夫,尤其是代谢物鉴定那几段。
文中提出的"能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢?"让我想到一个需要先厘清的问题:把Family层级的分类当作细胞分群标签时,功能相似性与亲缘关系可能会混在一起,图上的聚集未必能直接解释为代谢功能接近。如果借用单细胞分析中的降维流程,是否可以同时标注物种分类和基因组注释完整度,看看分离主要对应哪一种差异?尤其是这里用的是EC注释的TF-IDF矩阵,缺少某项注释究竟代表功能缺失还是未被识别,也可能影响对分群结果的判断。
这个角度之前没想到,零分布原理及其在生物信息学中的应用 确实值得深入了解。刚好之前看过,可以对照着看看。
Greetings! I stumbled upon this really useful site and figured I'd thanks for you post at here.
This content speaks to hearts