
估计阅读时长: 6 分钟微生物全基因组代谢网络(Genome-scale metabolic model, GEM)模型的发展历史可追溯至20世纪90年代。1994年,Varma和Palsson在《Applied and Environmental Microbiology》期刊上发表了开创性论文,题为"Stoichiometric flux balance models quantitatively predict growth and metabolic by-product […]
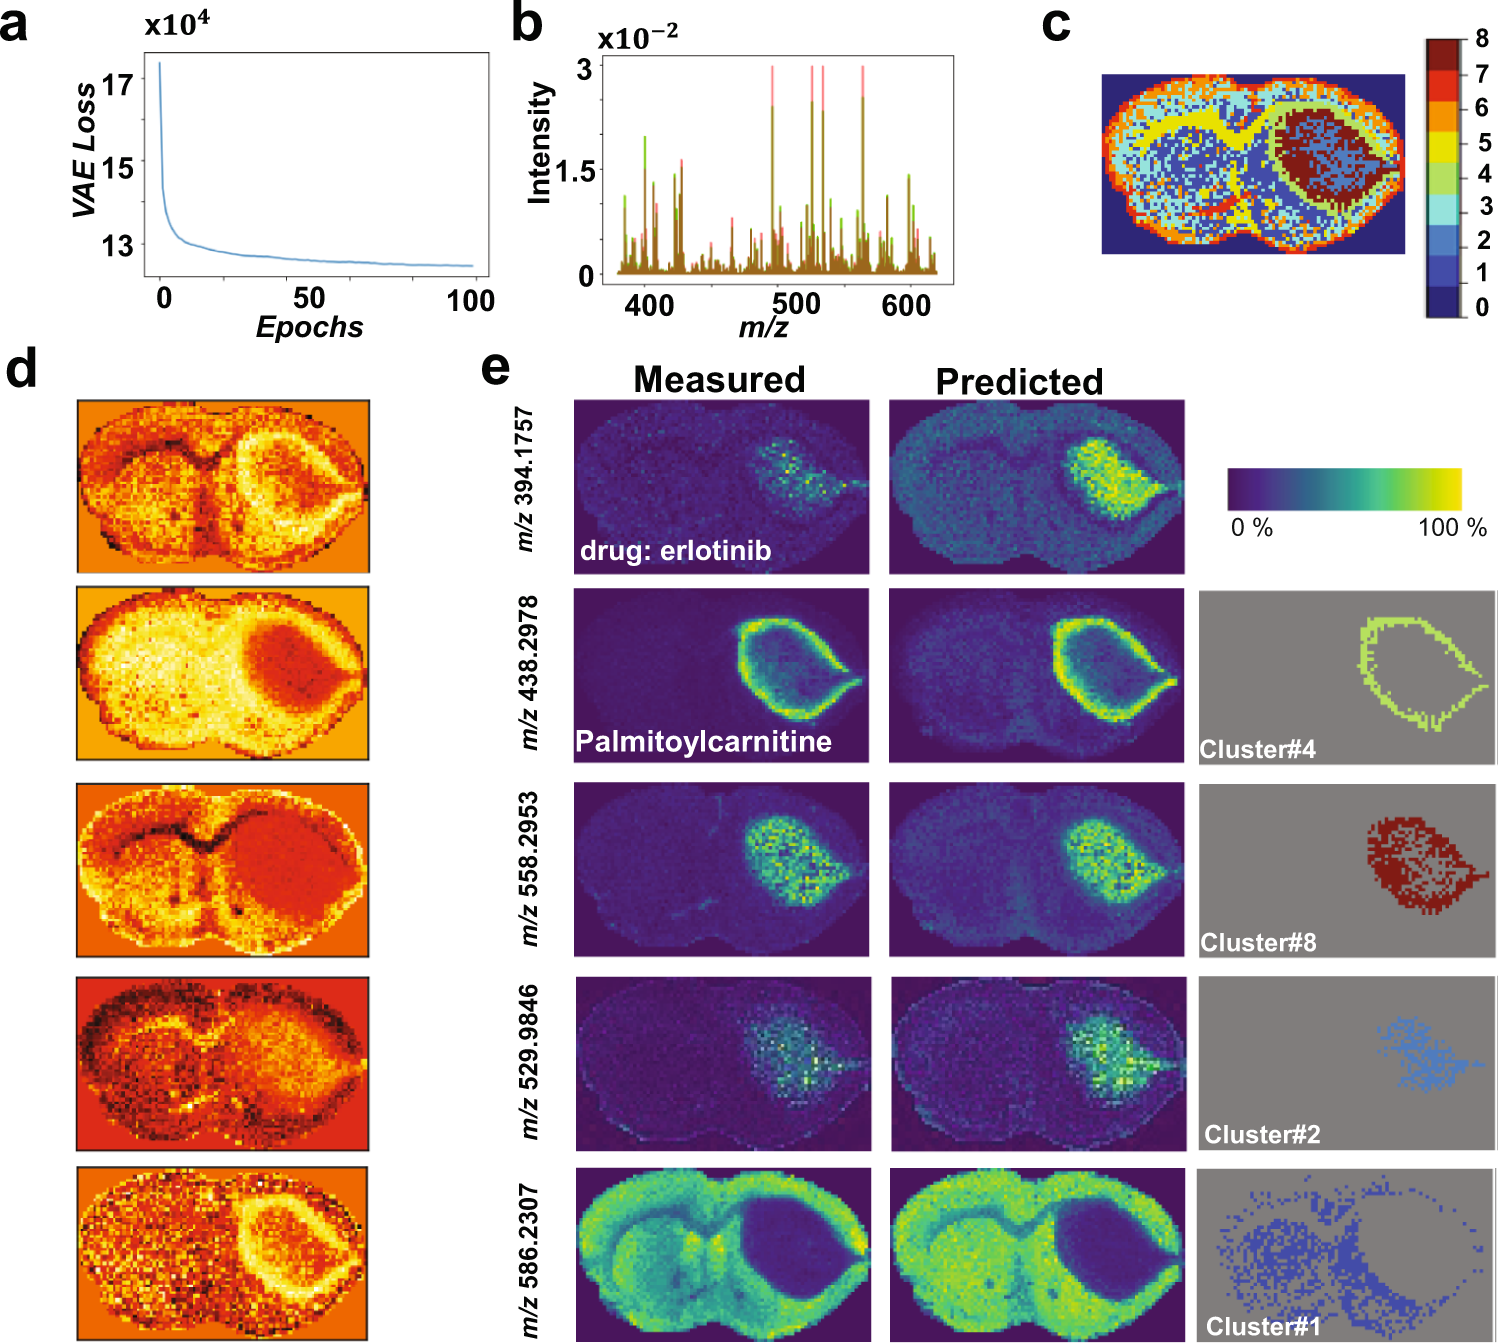
估计阅读时长: 4 分钟基于UMAP工具进行简单的自动化组织分区操作 在这里我们假设已经可以正常的将空间代谢数据导入至MZKit工作站软件之中。假若需要借助于MZKit工作站软件进行切片组织样本的自动化分区操作,相关的功能可以在【MSI Analysis】菜单栏中寻找到。在这里我们打开【Show Map Layer】按钮,选择【UMAP and clustering】功能。 基于降维的组织自动化分区原理 因为降维操作一般是一种特征提取操作,所以经过降维之后,在高维度空间上无法显现的特征,在低维度会呈现出来。在高维度空间散落的相近的数据点,在经过特征提取之后,低维度上会产生相似的特征信息,相互聚集在一簇。这样子我们就可以在低维度空间上通过一些聚类算法讲这些特征进行聚类,最后将聚类特征结果标记到各个散点上的对应的原始成像空间上,我们就可以看见组织分区的结果了。 Abdelmoula, W.M., Lopez, B.GC., Randall, E.C. et […]

估计阅读时长: 24 分钟假若现在有两条Fasta序列放在你面前,现在需要你进行这两条Fasta序列的相似度计算分析。如果对于我而言,大学刚毕业刚入门生物信息学的时候,可能只能够想到通过blast比对的方式进行序列相似性计算分析。基于blast比对方式可以找到生物学意义上的序列相似性结果,但是计算的效率会比较低。假设现在让你使用这些序列进行机器学习建模分析,或者基于传统数学意义上的基于相似度的无监督聚类分析的时候,面对这些长度上长短不一的生物序列数据,可能会比较蒙圈,因为传统的数学分析方法都要求我们分析的目标至少应该是等长的向量数据。 AttachmentsSort by:DefaultDateName Fasta-A • 544 KB • 1046 click 29.06.2023visualize • 44 KB • 957 […]
估计阅读时长: 7 分钟一般而言,进行全基因组的转录表达调控网络的建立,我们需要基于两个数据结果来完成: 目标基因的转录调控位点信息(Motif搜索结果,构成网络之中的节点) 转录调控位点相应的转录调控因子(Motif位点相关的转录调控因子,构成网络之中的边连接) AttachmentsSort by:DefaultDateName Xor • 271 KB • 1126 click 11.06.2022An integrated multi-omics approach […]
估计阅读时长: 10 分钟https://gcmodeller.org/ 流平衡分析(flux balance analysis)是一种可以用来构建和模拟分析基因组级别的代谢网络的数学方法。流平衡分析是系统生物学(system biology)的一个重要的分析手段。不同于以湿实验的代谢通量分析(metabolic flux analysis, MFA),FBA是用数学方法对代谢网络里的代谢流进行拟合分析。 AttachmentsSort by:DefaultDateName Electron micrographs of Synechococcus • 4 […]
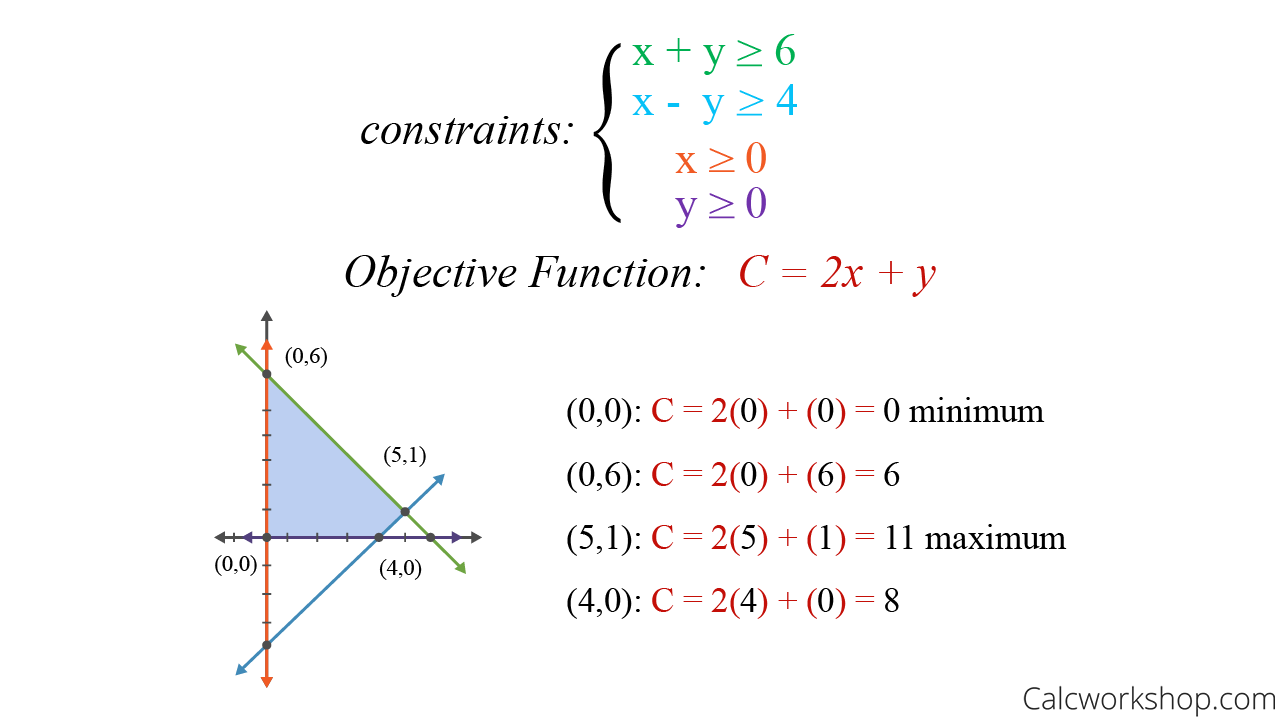
估计阅读时长: 30 分钟https://github.com/xieguigang/sciBASIC/ 线性规划(Linear programming,简称LP)方法起源于20世纪40年代,由美国数学家乔治·丹齐格(George Dantzig)提出,并设计了著名的“单纯形法”。这种优化算法是运筹学中研究较早、发展较快、应用广泛、方法较成熟的一个重要分支,它是辅助人们进行科学管理的一种数学方法。研究线性约束条件下线性目标函数的极值问题的数学理论和方法。通俗点的来讲,就是我们基于这一种数学优化技术,用于在一组线性约束条件下,求解线性目标函数的最大值或最小值(就是在“有限资源”和“一定规则”下,找到“最佳方案”的一种方法)。 AttachmentsSort by:DefaultDateName linear-programming-example • 21 KB • 1195 click 11.08.2021chi-graph-white-long • 24 […]
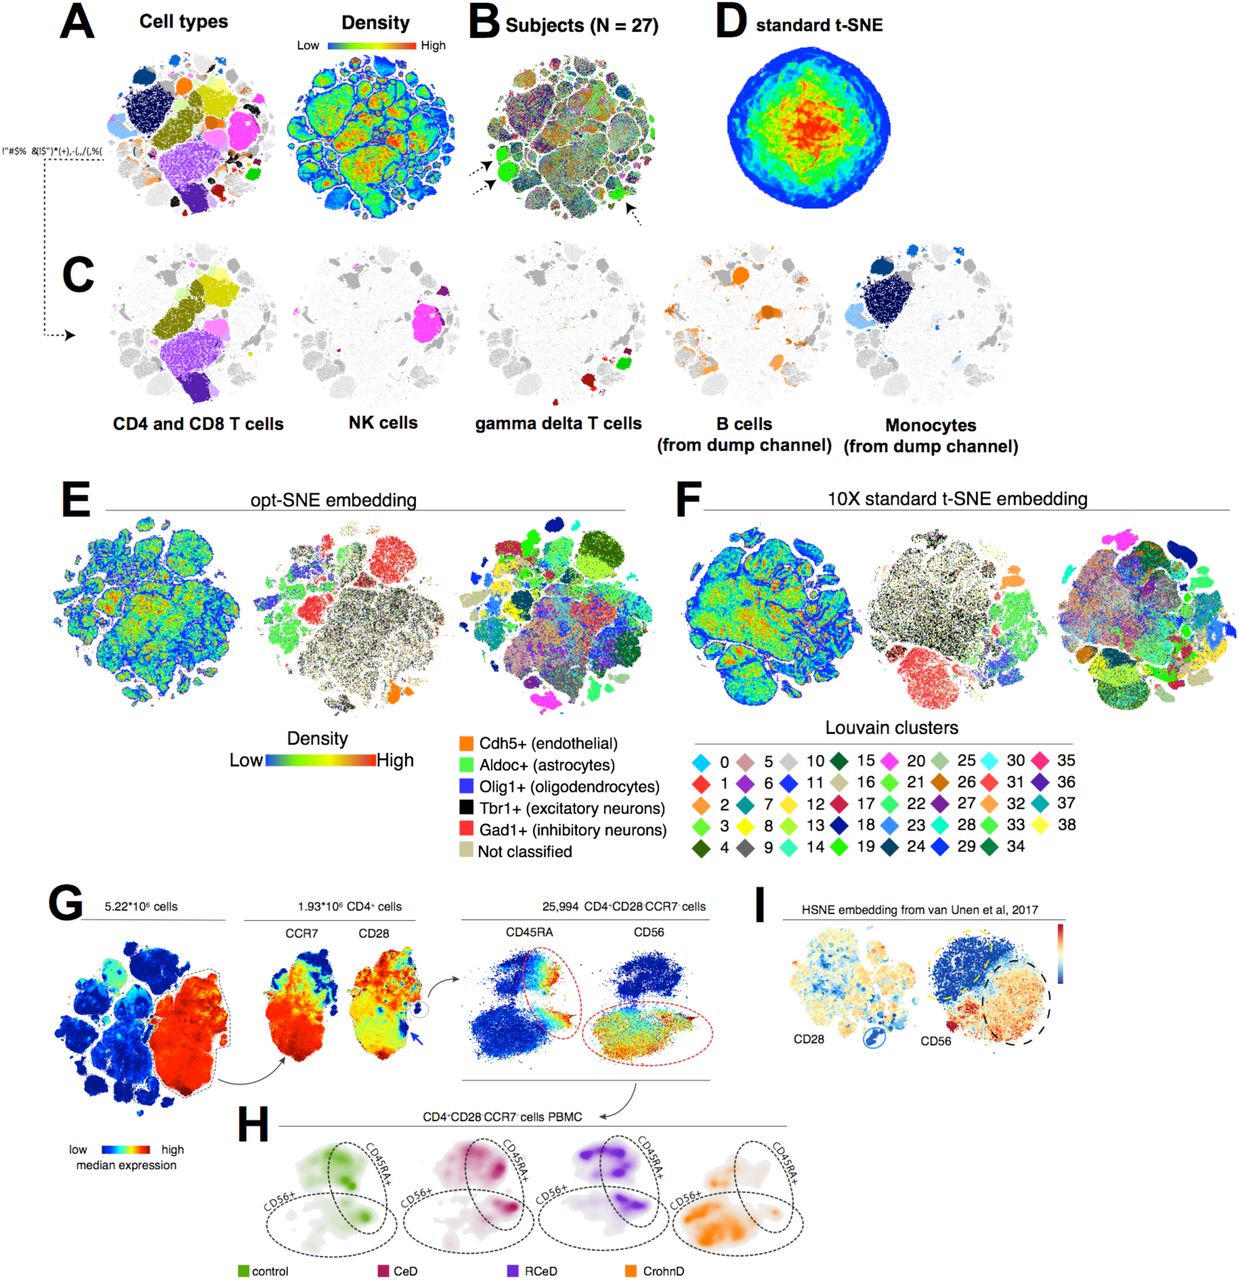
估计阅读时长: 11 分钟PhenoGraph提供了与UMAP类似的算法过程进行单细胞组学数据的细胞分型处理操作。与UMAP方法相比,PhenoGraph并不会产生数据降维效果,仅仅产生数据点Cluster信息。如果需要将数据进行可视化,还需要借助于t-SNE算法将PhenoGraph的分型结果数据投影到一个二维平面上完成。 AttachmentsSort by:DefaultDateName Phenograph-image4 • 199 KB • 1053 click 09.08.2021Automated Optimal Parameters for T-Distributed Stochastic […]
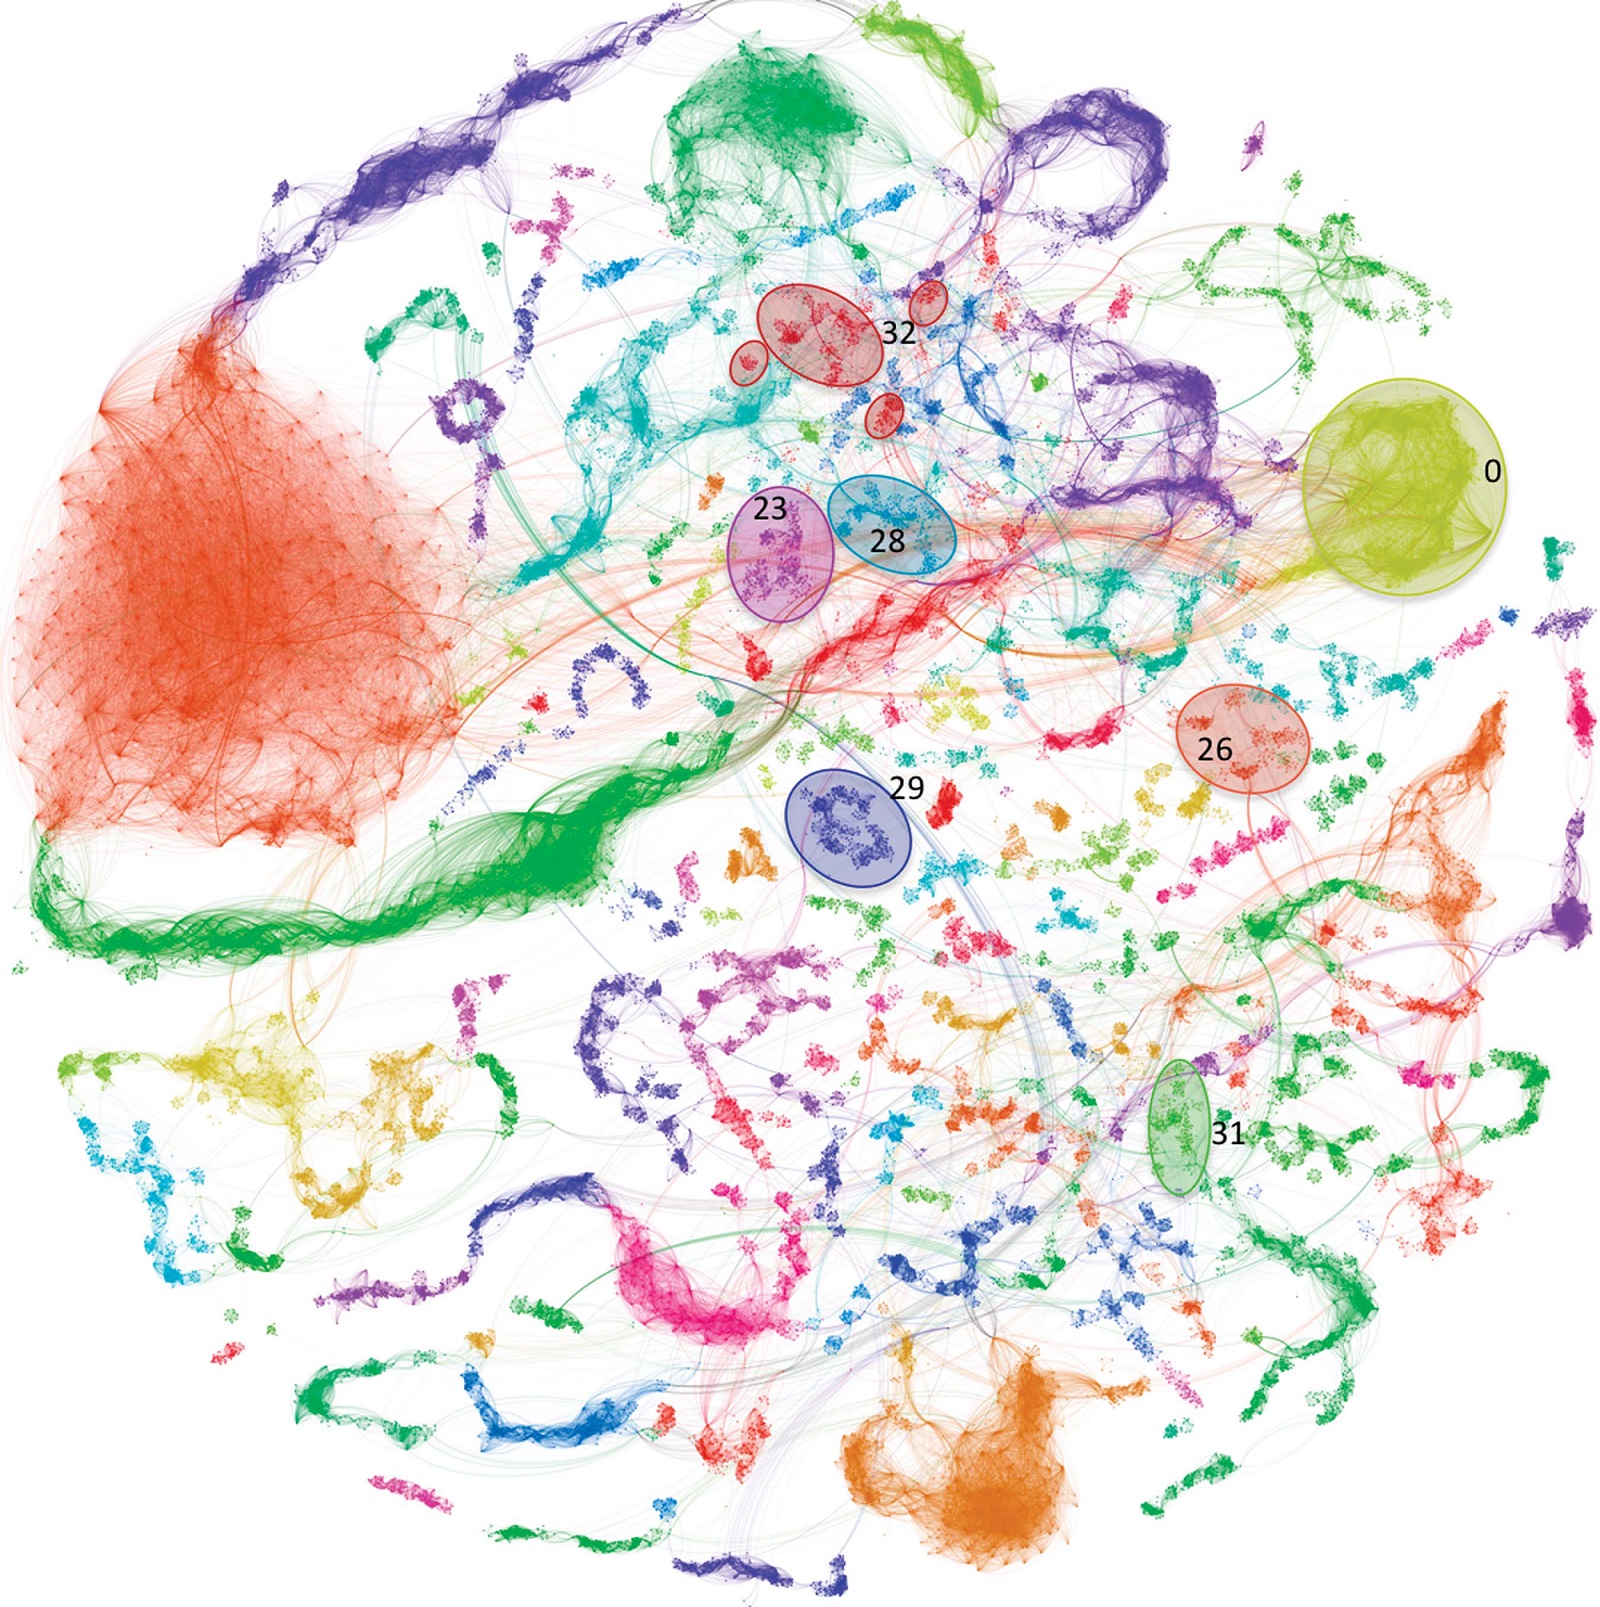
估计阅读时长: 11 分钟https://github.com/xieguigang/sciBASIC Louvain算法是基于模块度的网络节点集群发现算法。该算法在效率和效果上都表现较好,并且能够发现层次性的网络节点集群结构,其优化目标是最大化整个网络集群模块的模块度(Modularity)。 AttachmentsSort by:DefaultDateName graph • 1 MB • 1150 click 07.08.2021Metavirome network • 788 KB […]
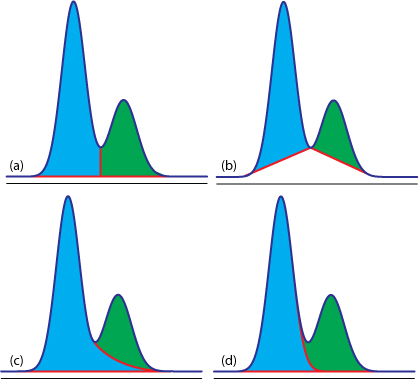
估计阅读时长: 8 分钟https://github.com/xieguigang/sciBASIC/tree/master/Data_science/Mathematica/SignalProcessing 进行峰识别是在代谢组学原始数据分析之中进行定量分析的很重要的一环。在代谢组学之中,定量分析分为靶向定量,以及非靶向定量计算这两大部分。 AttachmentsSort by:DefaultDateName Figure12.36 • 49 KB • 1134 click 10.07.2021view_signal • 56 KB • […]
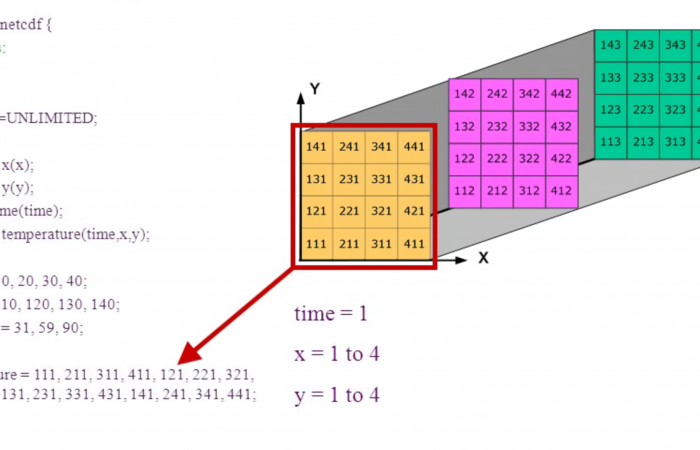
估计阅读时长: 15 分钟https://github.com/xieguigang/Darwinism NetCDF文件格式(Network Common Data Format)是一种以network byteorder进行编码的CDF数据文件格式。其广泛应用于大气科学、水文、海洋学、环境模拟、地球物理等诸多数据科学计算分析领域内的数据存储。 AttachmentsSort by:DefaultDateName netcdf • 1 MB • 1360 click 19.06.2021view-cdf-in-notepad […]

This content speaks to hearts
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 对于基于ec number来生成层级数据,我们直接使用《酶EC编号结构解析》文章末尾所展示的层级数据生成函数来实现。 […]
[…] 在前面的一篇《基因组功能注释(EC Number)的向量化嵌入》博客文章中,针对所注释得到的微生物基因组代谢信息,进行基于TF-IDF的向量化嵌入之后。为了可视化向量化嵌入的效果,通过UMAP进行降维,然后基于降维的结果进行散点图可视化。通过散点图可视化可以发现向量化的嵌入结果可以比较好的将不同物种分类来源的微生物基因组区分开来。 […]