
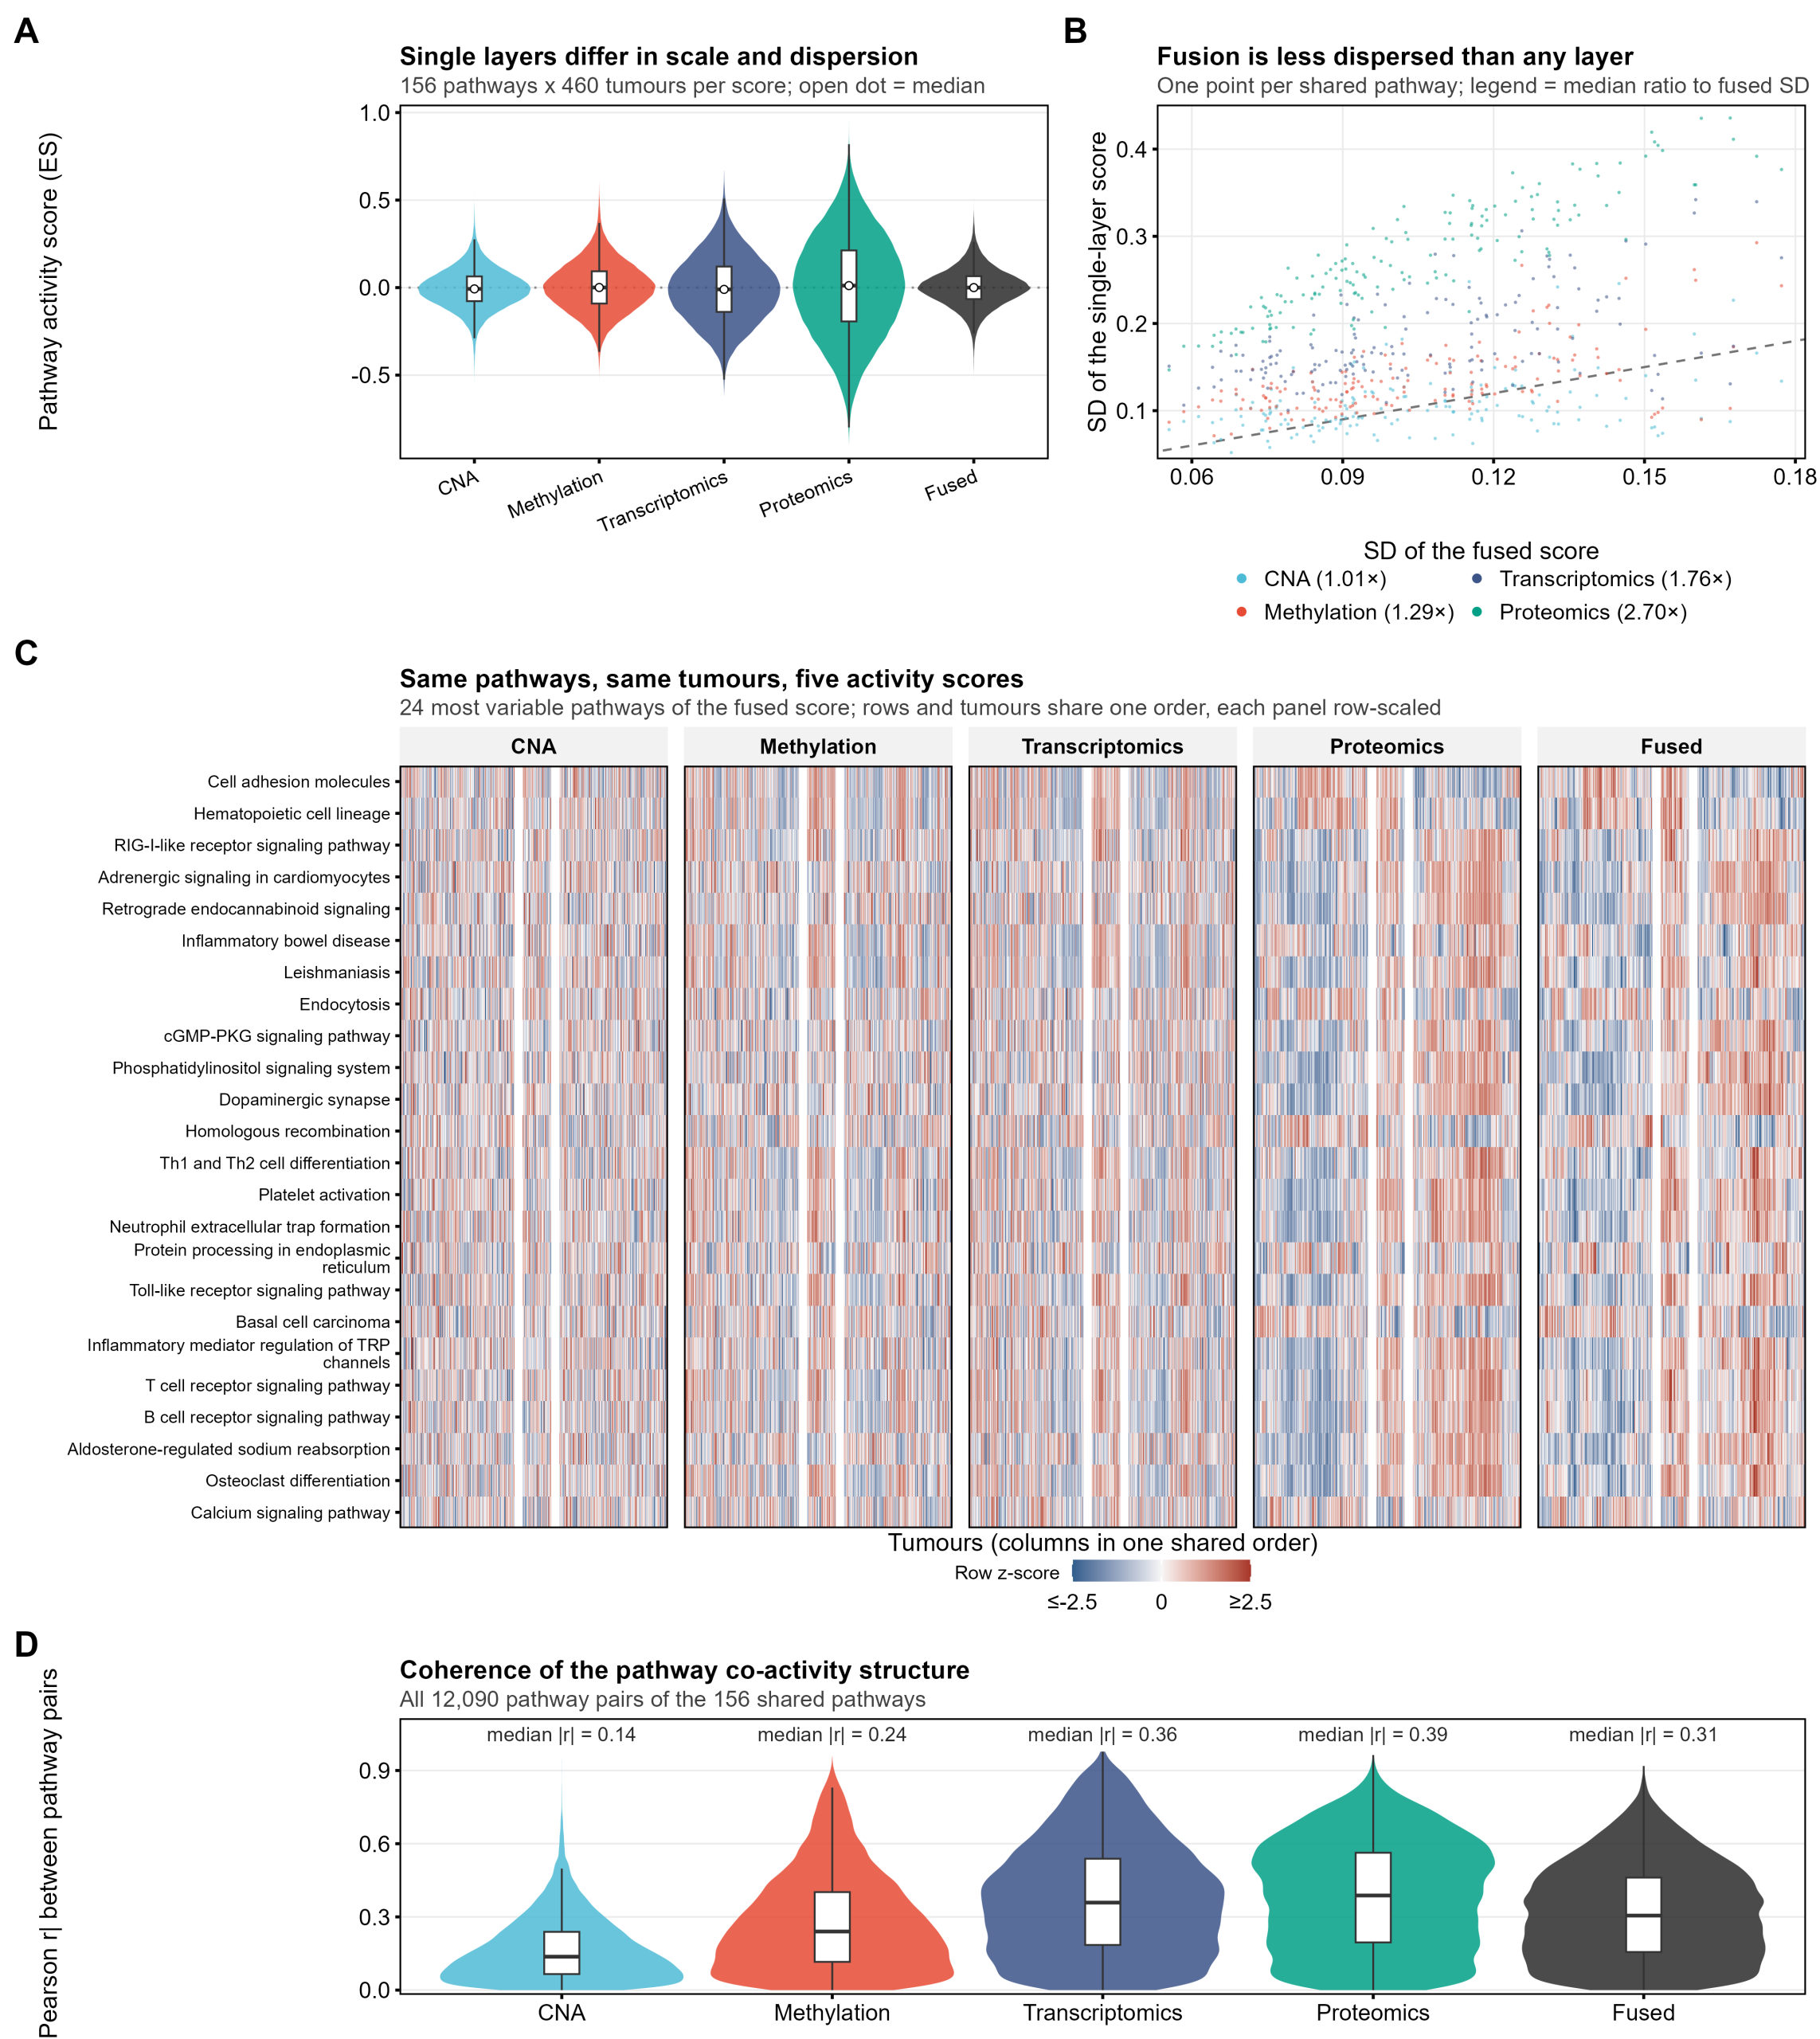
估计阅读时长: 14 分钟460 个乳腺癌、四个组学层、335 条 KEGG 通路。融合分数到底比"逐层算完再平均"强在哪?这篇文章把该泼的冷水泼完,再讲清楚它真正的价值。 面向:生物信息 / 计算生物学方向的研究生 | 预计阅读 30 分钟 数据:TCGA-BRCA(PanCanAtlas 处理版) | 配套:上篇讲数学,本篇讲实证 目录 先看数据:460 个肿瘤怎么变成四个矩阵 疾病背景:乳腺癌根本不是一种病 […]
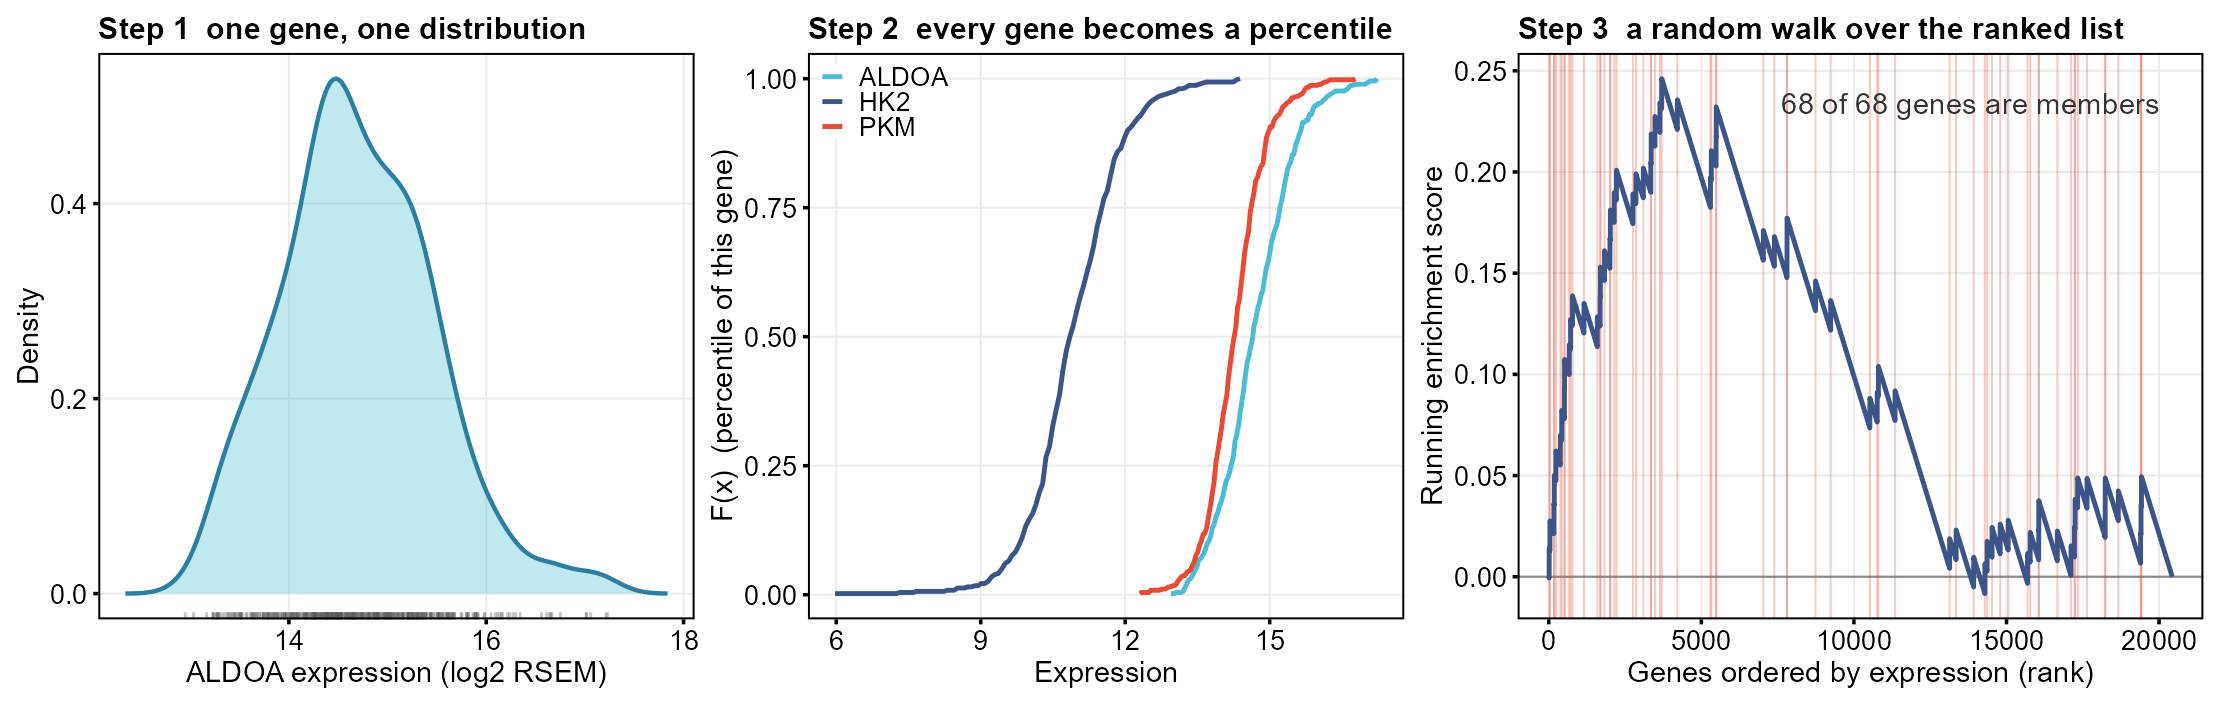
估计阅读时长: 27 分钟单样本的通路打分怎么做?四个组学层又怎么揉成一个数?这篇文章从 KDE 讲到加权融合,全程配伪代码,顺便把 mogsva.R 和它吐出来的十张表拆开讲一遍,尽量让公式看起来不像天书。 面向:生物信息 / 计算生物学方向的研究生 | 预计阅读 25 分钟 目录 一个让审稿人皱眉的问题 GSVA 第一步:给每个基因配一把自己的尺子 GSVA 第二步:把表达量换成"分位数" […]
估计阅读时长: 20 分钟用 GCModeller 做泛基因组分析(二):801 个大肠杆菌基因组实战 面向读者:具有一定 R 语言编程基础的生物信息学初学者、实验室里的微生物研究者。 本篇是系列的实战篇:从 GenBank 原始注释文件出发,用两条 R# 脚本跑完大肠杆菌的泛基因组分析, 并结合真实运行产出的结果文件逐项解读。算法原理(CD-HIT 聚类、PAV 矩阵、香农信息熵等) 请先阅读系列第一篇《用 […]
估计阅读时长: 5 分钟基因组 为了能够实现上面所描述的这种基于EC Number的不同层级的加权嵌入,我们在原来的基因组嵌入工具上添加了一个hierarchical选项,用于支持切换为层级嵌入的操作: Imports Microsoft.VisualBasic.Data.Framework Imports Microsoft.VisualBasic.Data.NLP Imports SMRUCC.genomics.Interops.NCBI.Extensions.Pipeline Public Class GenomeMetabolicEmbedding ReadOnly vec As New […]
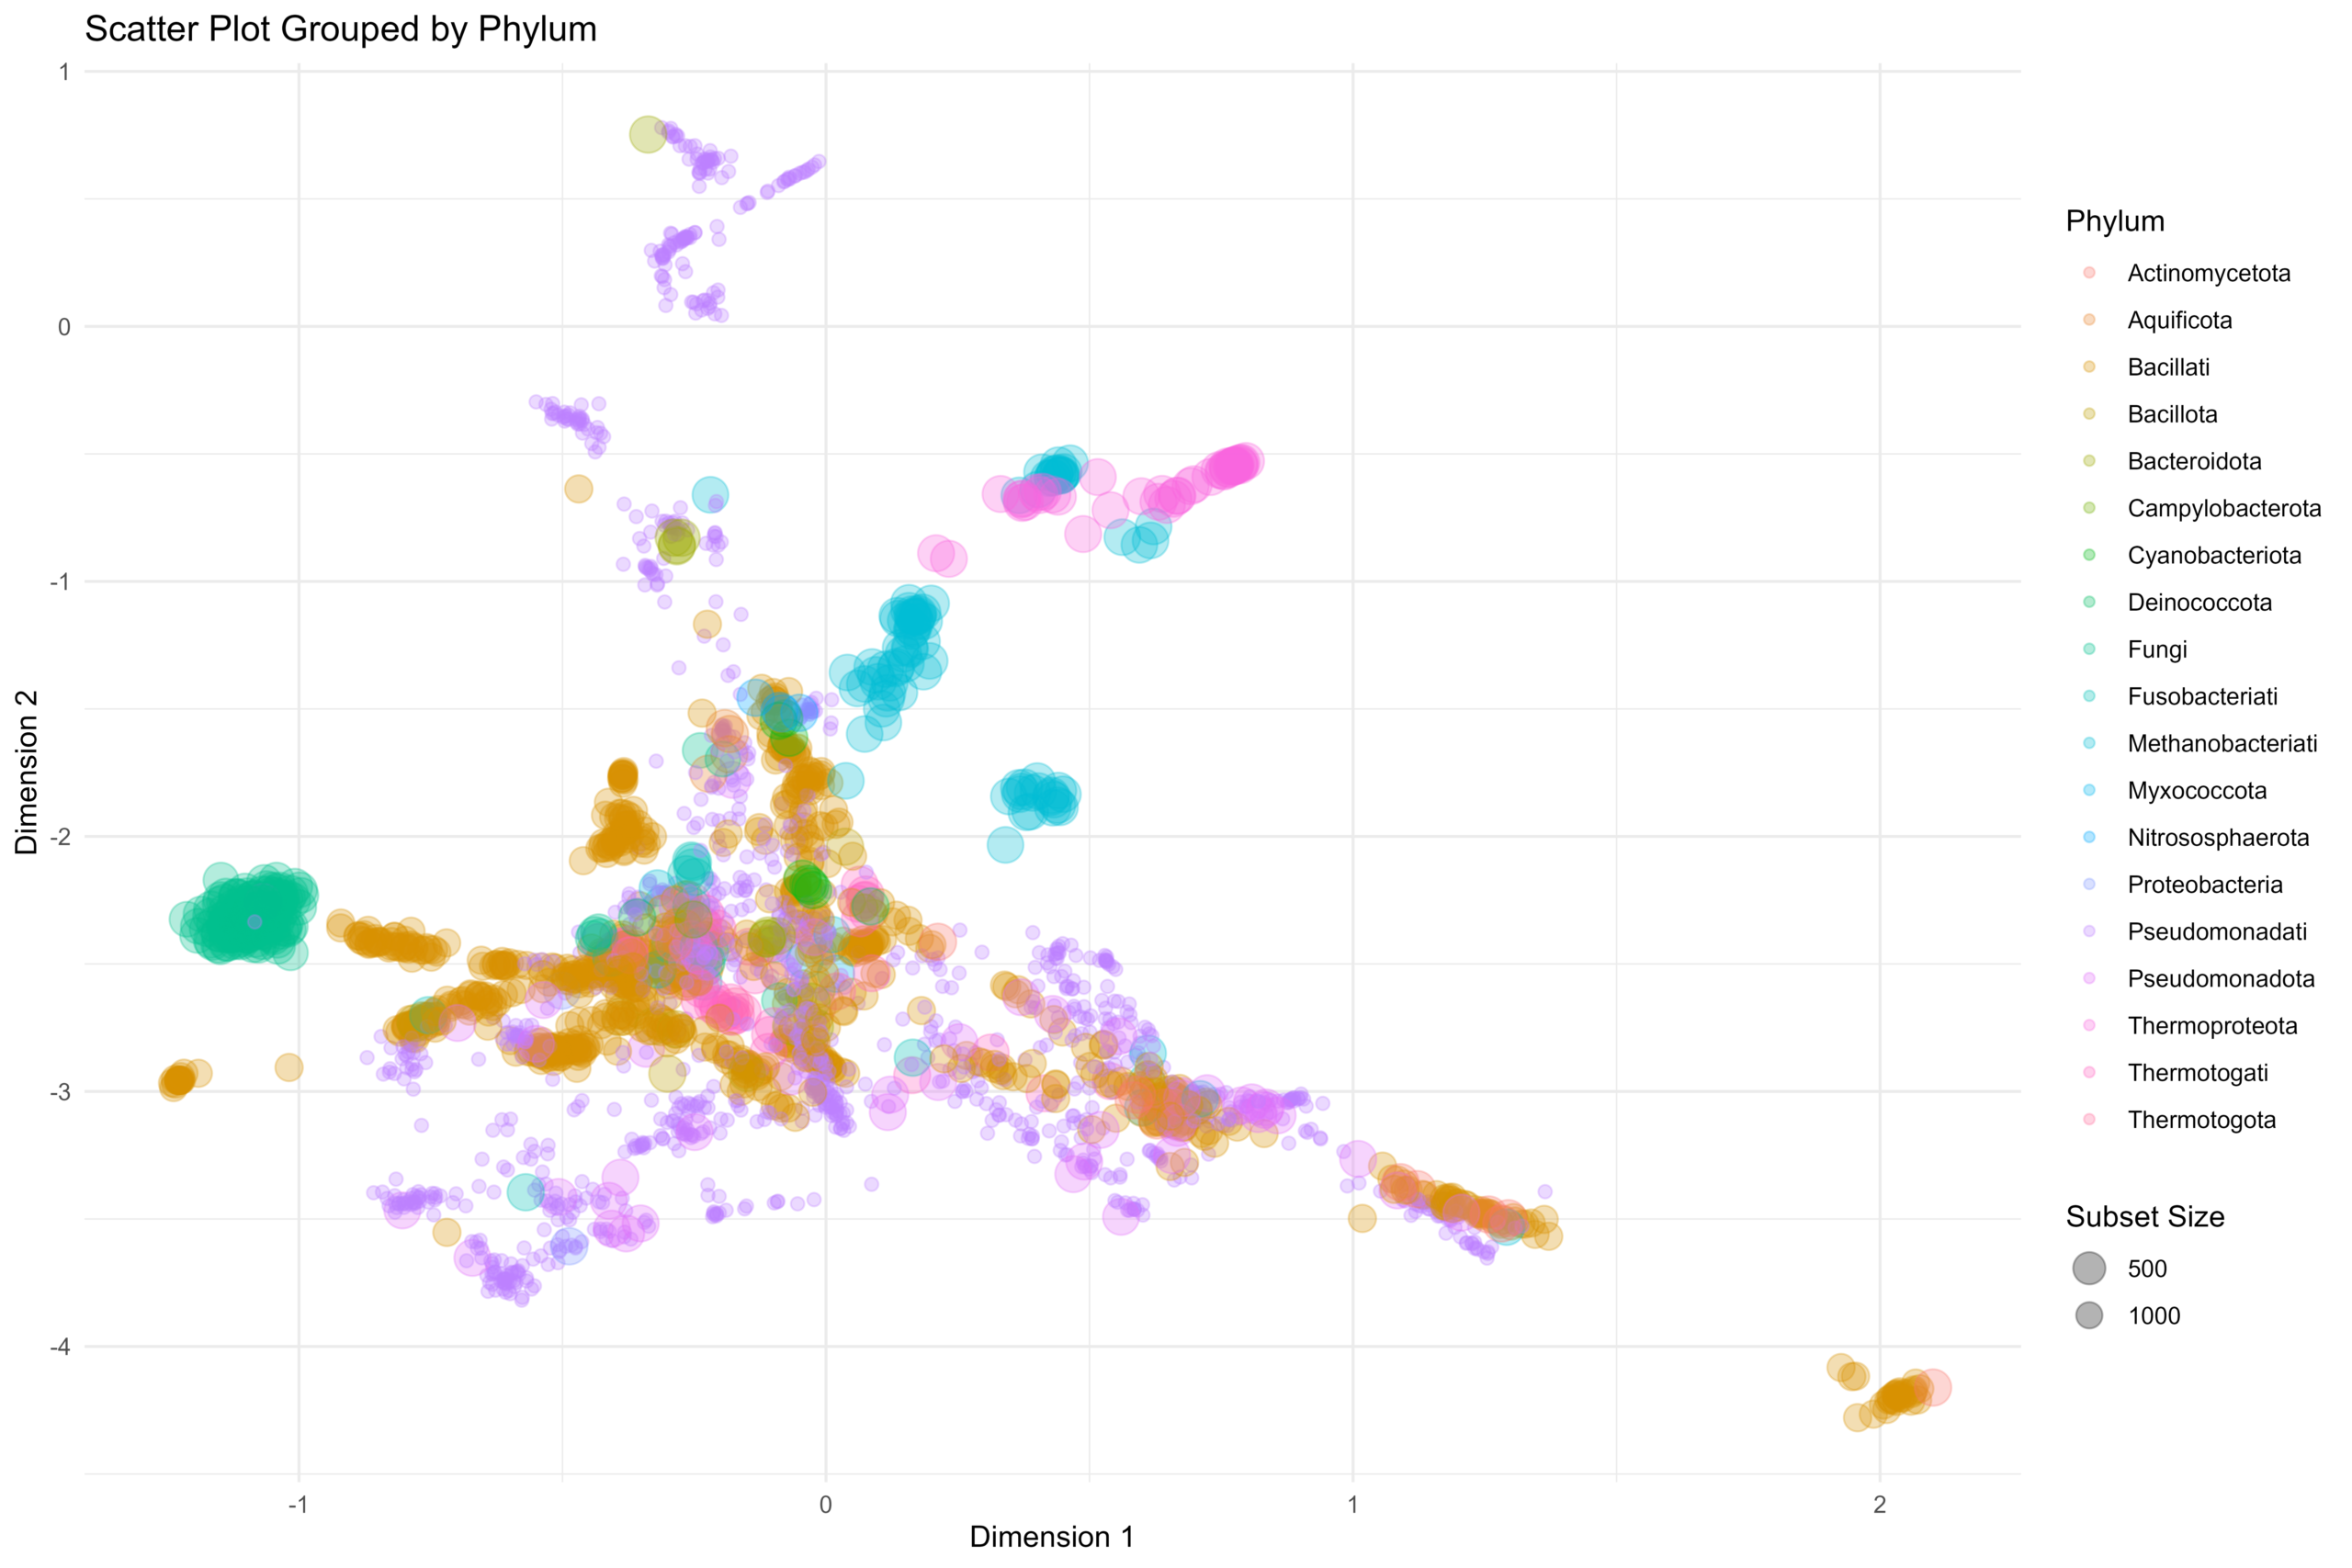
估计阅读时长: 20 分钟最近的工作中我需要按照之前的这篇博客文章《基因组功能注释(EC Number)的向量化嵌入》中所描述的流程,将好几十万个微生物基因组的功能蛋白进行酶编号的比对注释,然后基于注释结果进行向量化嵌入然后进行数据可视化。通过R#脚本对这些微生物基因组的蛋白fasta序列的提取操作,最终得到了一个大约是58GB的蛋白序列。然后将这个比较大型的蛋白序列比对到自己所收集到的ec number注释的蛋白序列参考数据库之上。
估计阅读时长: 16 分钟KEGG 里面目前并没有“现成的每个 KO 一条代表性序列 FASTA”这种官方序列数据库,假若我们需要基于KEGG数据库中的KO信息的注释,那我们一般会需要自己从 KEGG GENES 里面把每个 KO 对应的基因/蛋白序列抓出来,再按 KO 编号组织成 fasta 集合构建出对应的数据库。基于所建立好的KEGG基因序列数据库,我们就可以实现下面的一些基因注释工作: 在全基因组规模代谢网络重建工作中,进行我们的目标基因组中的代谢网络中的酶节点的直系同源推断,从而将我们的目标基因组中的基因映射到具体的KEGG代谢网络上的节点位置,从而重建出代谢网络模型(使用带有KO编号的蛋白序列做比对注释) 假若我们在进行宏基因组的基因丰度的计算,则可以基于所建立的KEGG基因序列数据库作为参考库,进行宏基因组测序数据中的KO基因丰度的计算(使用带有KO编号的基因序列做比对注释)
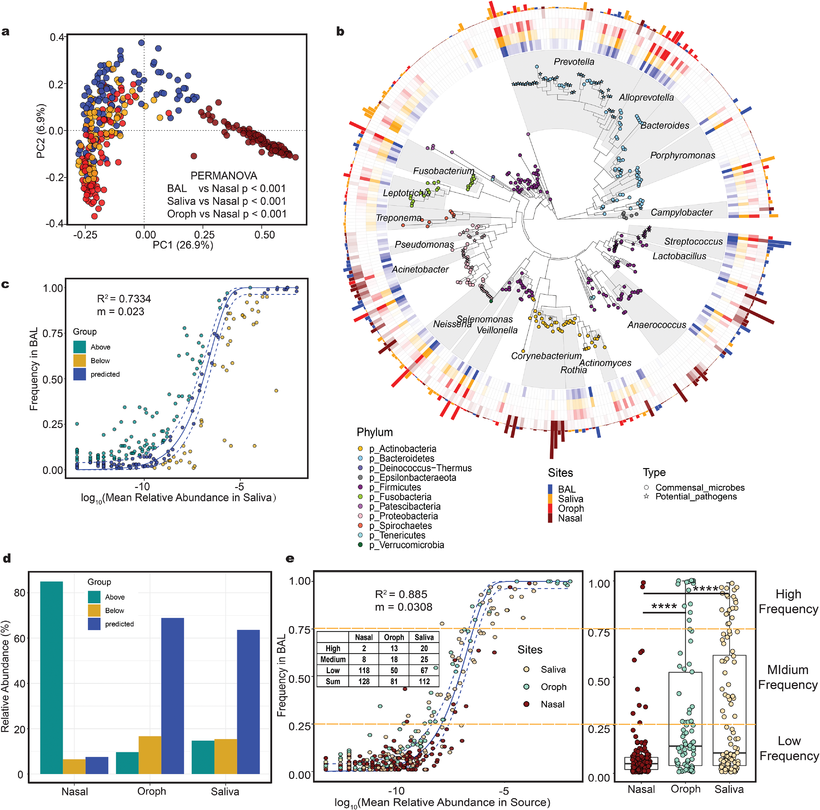
估计阅读时长: < 1 分钟环境中的微生物往往以复杂群落的形式存在,不同物种之间通过代谢相互作用形成协同或竞争关系,共同完成生物地球化学循环、维持生态系统功能。近年来,随着高通量基因组测序技术的发展,研究者可以从环境样本中获取海量微生物基因组数据,为构建基因组尺度代谢模型(Genome-scale metabolic models, GEMs)提供了基础。GEMs将微生物的全基因组注释与生化反应网络相结合,可以用于模拟微生物在特定环境条件下的代谢能力,预测其生长和代谢产物。在单菌株层面,GEMs已被广泛用于解析微生物对环境变化的代谢适应机制、指导代谢工程设计以及预测药物靶点等。在群落层面,通过将多个GEMs耦合,可以研究微生物之间的相互作用,例如通过代谢物交换实现的协同或竞争关系。
估计阅读时长: 5 分钟将复杂的生物学过程拆解为单元化学反应,是进行定量模拟的基石。转录是基因表达调控的关键环节,决定了细胞在特定时间、特定环境下合成哪些蛋白质,对生命活动至关重要。最近的工作中需要将原本非常粗糙的虚拟细胞转录事件模型拆解为更加细分化的多步骤生物化学过程,以适应针对细胞群落生长的建模计算。下面为我将原核生物的转录过程拆解为一系列可以用化学式表示的单元步骤的结果。 在介绍这些分步骤之前,我们会需要首先来定义一下模型中会用到的各种“化学物质”(分子和复合物): RNAP: RNA聚合酶全酶(包含核心酶和σ因子)。 DNA: 基因组DNA双链。 DNA_P: 包含启动子区域的DNA。 DNA_T: 包含终止子区域的DNA。 NTP: 核糖核苷三磷酸(ATP, UTP, GTP, CTP的统称)。 PPi: […]
估计阅读时长: 27 分钟宏基因组测序直接从环境样本获取所有生物的遗传物质,产生的海量短读序列(reads)需要被快速准确地分类到不同物种或功能类别。然而,宏基因组数据具有复杂性高、物种多样且未知序列多等特点,这给分类算法带来了巨大挑战。传统的序列比对方法虽然准确,但在面对庞大的参考数据库时计算开销巨大,难以满足实时分析的需求。因此,研究者开发了多种基于k-mer(长度为k的子序列)的快速分类方法,其中布隆过滤器(Bloom Filter)作为一种高效的概率数据结构,在针对测序reads做物种上的快速分类这项工作中起到了一些关键作用。
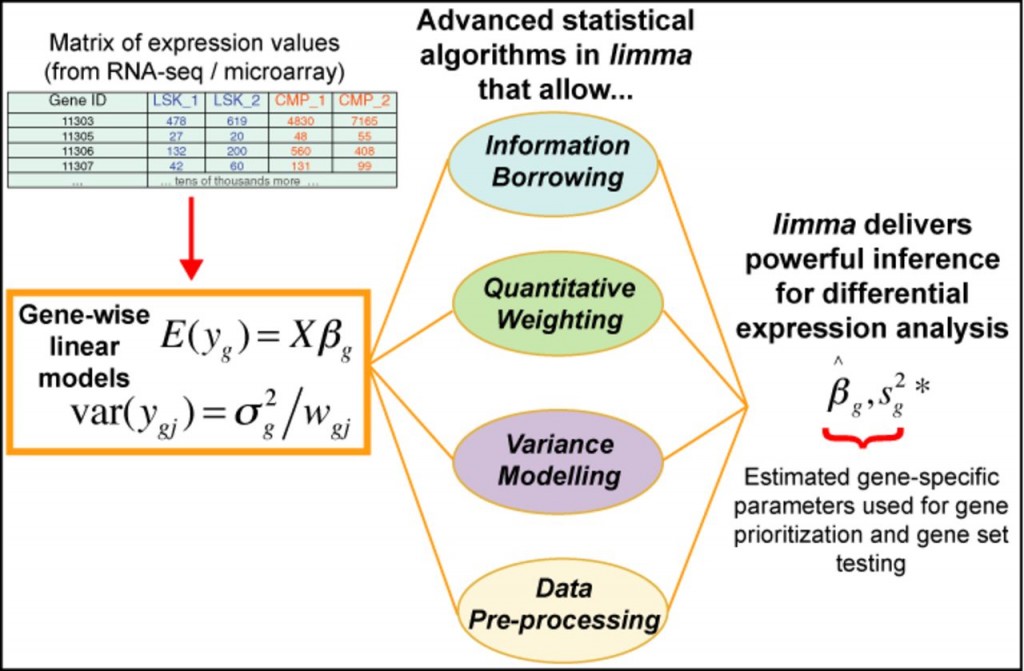
估计阅读时长: 22 分钟limma(Linear Models for Microarray Data)是一个基于R语言的Bioconductor包,最初用于微阵列数据的差异表达分析,现已扩展支持RNA-seq数据。其核心思想是利用线性模型(Linear Models)对基因表达数据进行建模,并结合经验贝叶斯(Empirical Bayes)方法在小样本情况下增强统计推断的稳健性。

代谢组学那堆名词我上次查资料时也手抄过一页,QC 样本、保留时间、m/z 这些混在一张表里,来回对照着看特别费劲。你这篇把英文缩写和中文解释排在一起,省了我不少翻文献的功夫,尤其是代谢物鉴定那几段。
文中提出的"能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢?"让我想到一个需要先厘清的问题:把Family层级的分类当作细胞分群标签时,功能相似性与亲缘关系可能会混在一起,图上的聚集未必能直接解释为代谢功能接近。如果借用单细胞分析中的降维流程,是否可以同时标注物种分类和基因组注释完整度,看看分离主要对应哪一种差异?尤其是这里用的是EC注释的TF-IDF矩阵,缺少某项注释究竟代表功能缺失还是未被识别,也可能影响对分群结果的判断。
这个角度之前没想到,零分布原理及其在生物信息学中的应用 确实值得深入了解。刚好之前看过,可以对照着看看。
Greetings! I stumbled upon this really useful site and figured I'd thanks for you post at here.
This content speaks to hearts