
估计阅读时长: 15 分钟进行生物化学代谢反应网络的模拟计算,可以分为三种技术路线:基于线性规划做优化的FBA方法,基于常微分方程组求解的动力学模拟方法,以及最近发展的基于图神经网络做模拟计算的深度学习计算方法。在下面的表格中,在这里进行比较和总结了上面所提到的三种计算分析方法各自的计算原理和应用领域: 计算方法 原理 优势 适用场景 通量平衡分析(FBA) 基于约束条件(如化学计量矩阵、酶容量限制)和线性规划,在假设代谢网络处于稳态(即代谢物浓度不变)的前提下,计算代谢通量的分布,通常以最大化特定目标(如生物量生长)进行优化 1. 无需详细的酶动力学参数,特别适合大规模网络研究。2. 计算速度快,可系统性地预测基因敲除或环境扰动下的表型变化。3. 广泛应用于指导代谢工程,优化目标产物合成。 追求快速评估和全局优化:如果你的研究目标是在基因组尺度上快速评估微生物在不同条件下的生长或产物合成潜力,并且难以获取详细的动力学参数,FBA是一个非常实用的起点 动力学模拟 基于质量作用定律等构建常微分方程组(ODEs),描述每个代谢物浓度随时间变化的动力学过程,通过数值方法求解方程组 1. 能够捕捉代谢物浓度和通量的瞬态动态变化,揭示更精细的调控机制2. […]
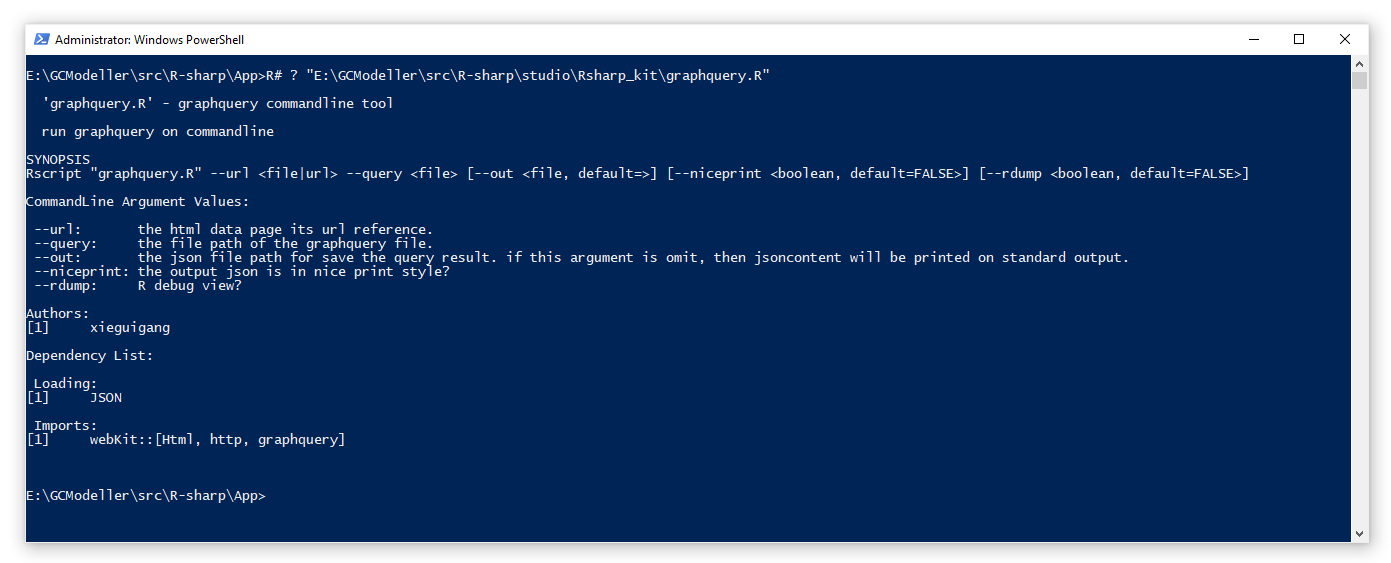
估计阅读时长: 9 分钟前段时间由于工作的需要,会需要从一些网站上抓取数据用来做数据分析。在原来我进行网页爬虫开发的时候,一般会需要专门针对网页格式,使用大量的正则表达式进行内容的解析。由于你也知道,VisualBasic语言所开发的程序为一个编译好的Assembly文件,所以假若所需要爬取的网页格式变化了,我们就需要对代码做修改和重新编译。这个时候就会非常的不方便。 AttachmentsSort by:DefaultDateName ea5d2885-bba5-410f-b02b-0589613412ed • 11 KB • 1191 click 29.05.2021graphquery_Rscript • 35 KB • 1105 […]

This content speaks to hearts
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 对于基于ec number来生成层级数据,我们直接使用《酶EC编号结构解析》文章末尾所展示的层级数据生成函数来实现。 […]
[…] 在前面的一篇《基因组功能注释(EC Number)的向量化嵌入》博客文章中,针对所注释得到的微生物基因组代谢信息,进行基于TF-IDF的向量化嵌入之后。为了可视化向量化嵌入的效果,通过UMAP进行降维,然后基于降维的结果进行散点图可视化。通过散点图可视化可以发现向量化的嵌入结果可以比较好的将不同物种分类来源的微生物基因组区分开来。 […]