
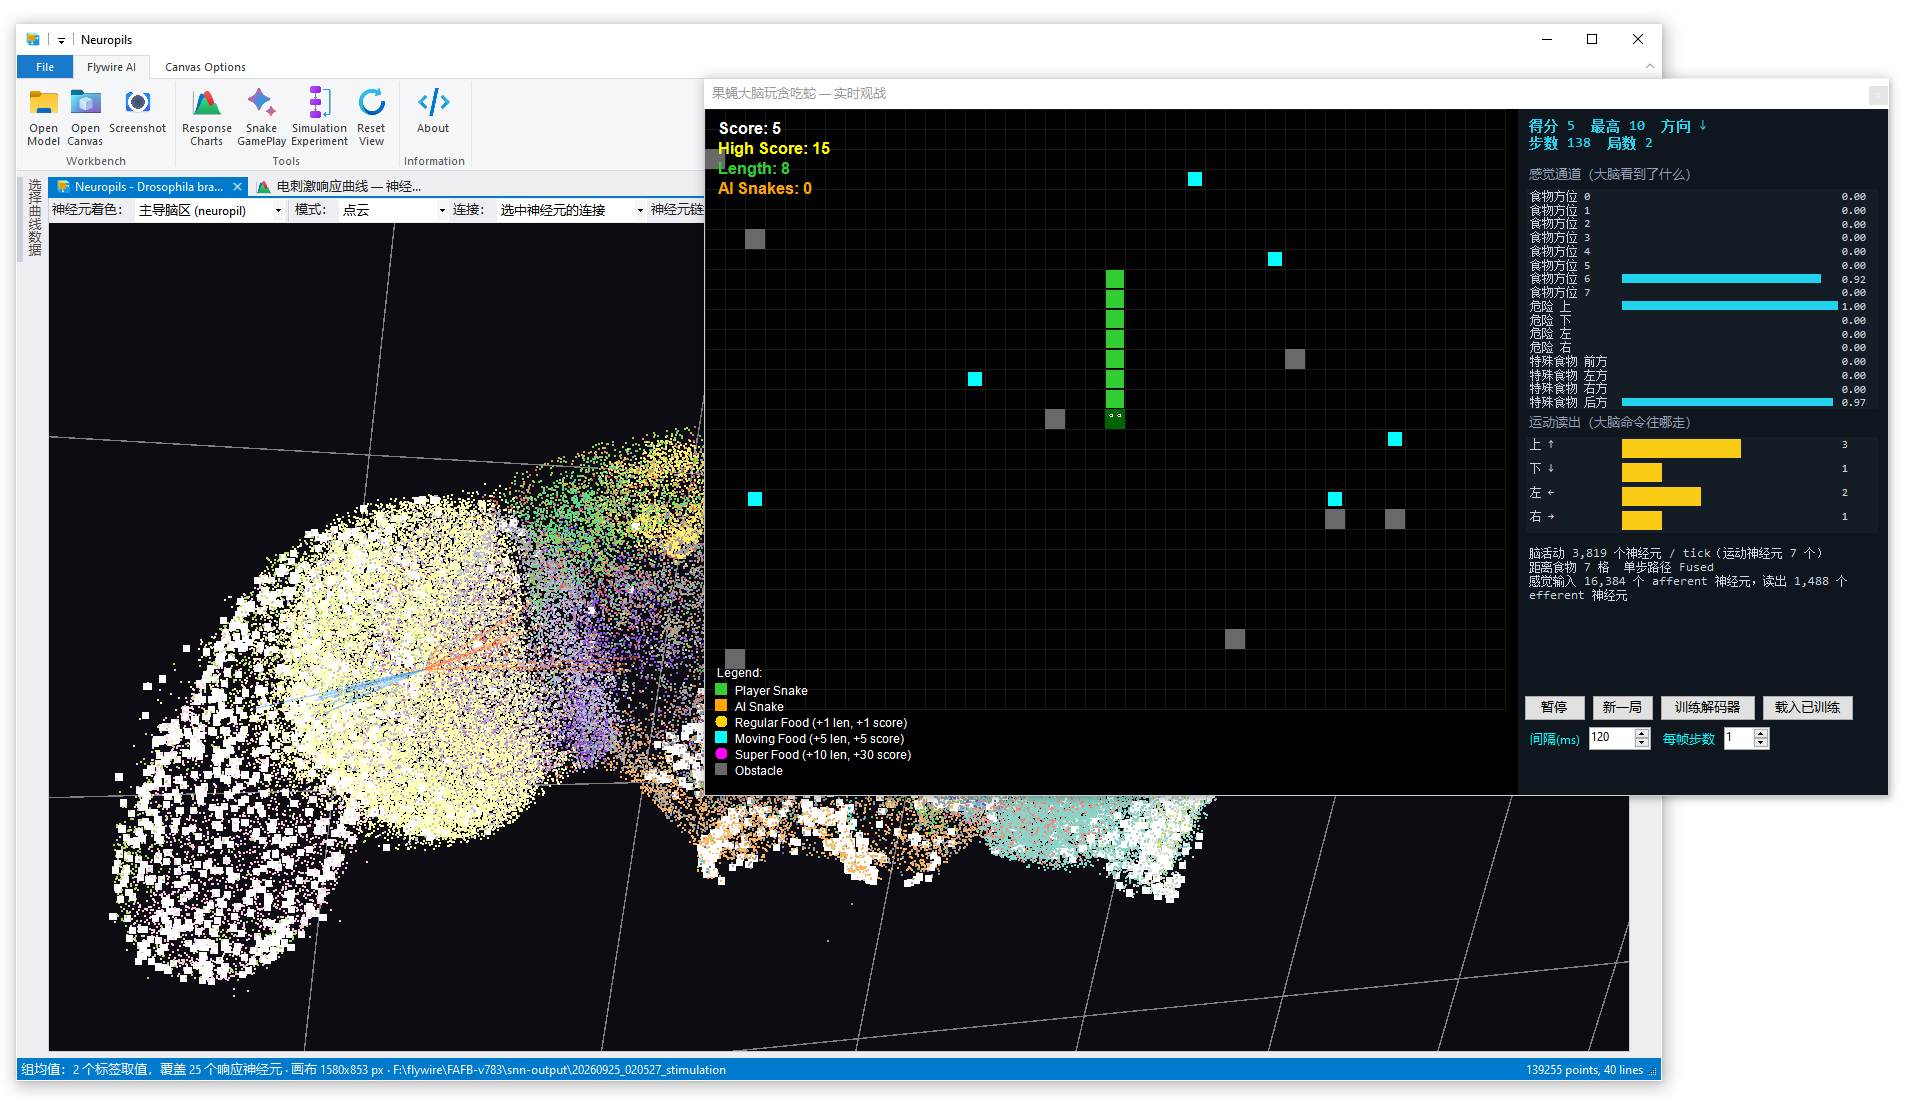
估计阅读时长: 10 分钟Github开源地址:https://github.com/xieguigang/flywire 本文是"果蝇赛博生命"三部曲的第三篇,也是高潮篇。前两篇我们讲清了脉冲神经元的"漏水桶"模型(第一篇),以及 FAFB-v783 连接组这张 5000 万条记录的全脑"通话清单"(第二篇)。今天,我们要做两件事:第一,给这只果蝇通电,看看她大脑里哪片区域在亮;第二,把贪吃蛇游戏接进她的大脑,让她自己玩。 然后——因为这篇文章写得足够长——我们顺便讨论一下人类的数字永生、缸中之脑、《黑客帝国》和《流浪地球 2》。坐稳了。 Attachments SNN-Snake • 208 KB • 0 click […]
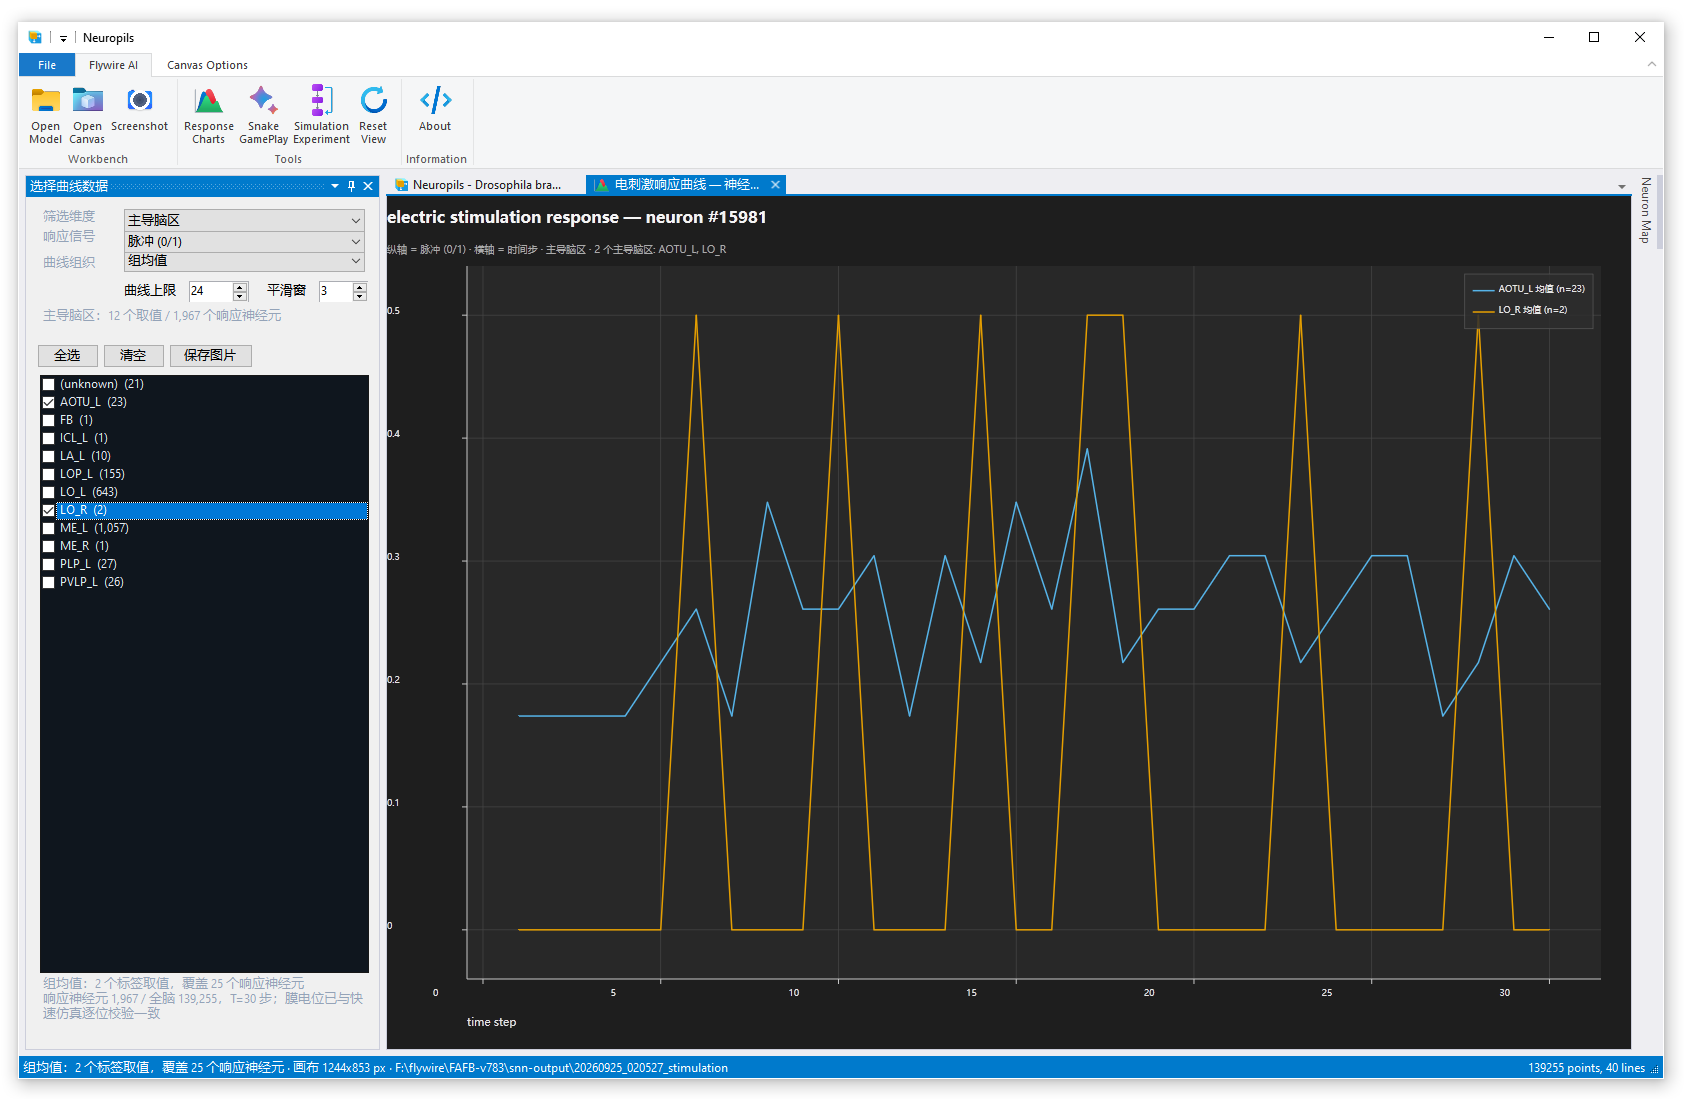
估计阅读时长: 6 分钟Github开源地址:https://github.com/xieguigang/sciBASIC 本文是"果蝇赛博生命"三部曲的第一篇。我们不讲果蝇,也不讲贪吃蛇,只讲一件事:计算机是如何模仿你的大脑在"想事情"的。 放心,全文不需要任何机器学习背景,需要的只有高中数学,和一个愿意被比喻轰炸的开放心态。 AttachmentsSort by:DefaultDateName SNNResponse • 173 KB • 0 click 25.09.2026Capture • 262 KB […]
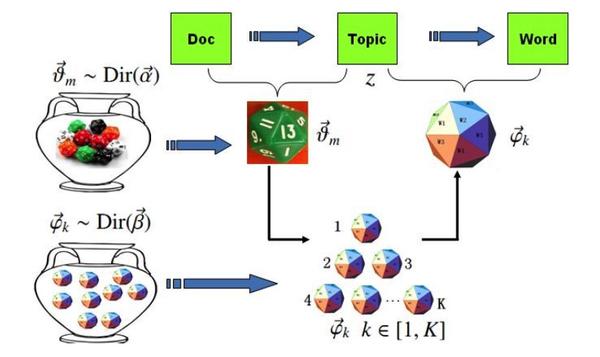
估计阅读时长: 20 分钟LDA(Latent Dirichlet Allocation,潜在狄利克雷分配)是一种用于发现文档集合中潜在主题的生成式概率模型。它假设文档是由多个主题混合而成的,而每个主题又是通过一定的概率分布选择词语生成的。LDA模型包含词、主题和文档三层结构,通过概率生成过程模拟文档的形成。Gibbs LDA 的核心在于使用吉布斯采样方法来推断这些隐藏的主题分布。 Attachments v2-883ac9db7f1cbd7325b2450cd225a897_b • 29 KB • 492 click 23.02.2026

估计阅读时长: 30 分钟零分布(null distribution)是指在假设零假设(null hypothesis)成立的情况下,某个统计量随机取值的概率分布。在统计假设检验中,我们通常提出一个零假设(例如“两组数据没有显著差异”或“观察到的模式仅由随机因素造成”),然后根据观测数据计算一个检验统计量。零分布描述了这个统计量在零假设为真时的分布情况。通过将实际观测到的统计量与零分布进行比较,我们可以计算出P-value:即在零假设下,出现等于或更极端观测结果的概率。如果P-value很小(例如低于预设的显著性水平α),我们就认为零假设不太可能成立,从而拒绝零假设,认为观测结果是统计显著的。 AttachmentsSort by:DefaultDateName image-2 • 66 KB • 678 click 16.12.2025NULL-pvalue • 8 KB […]
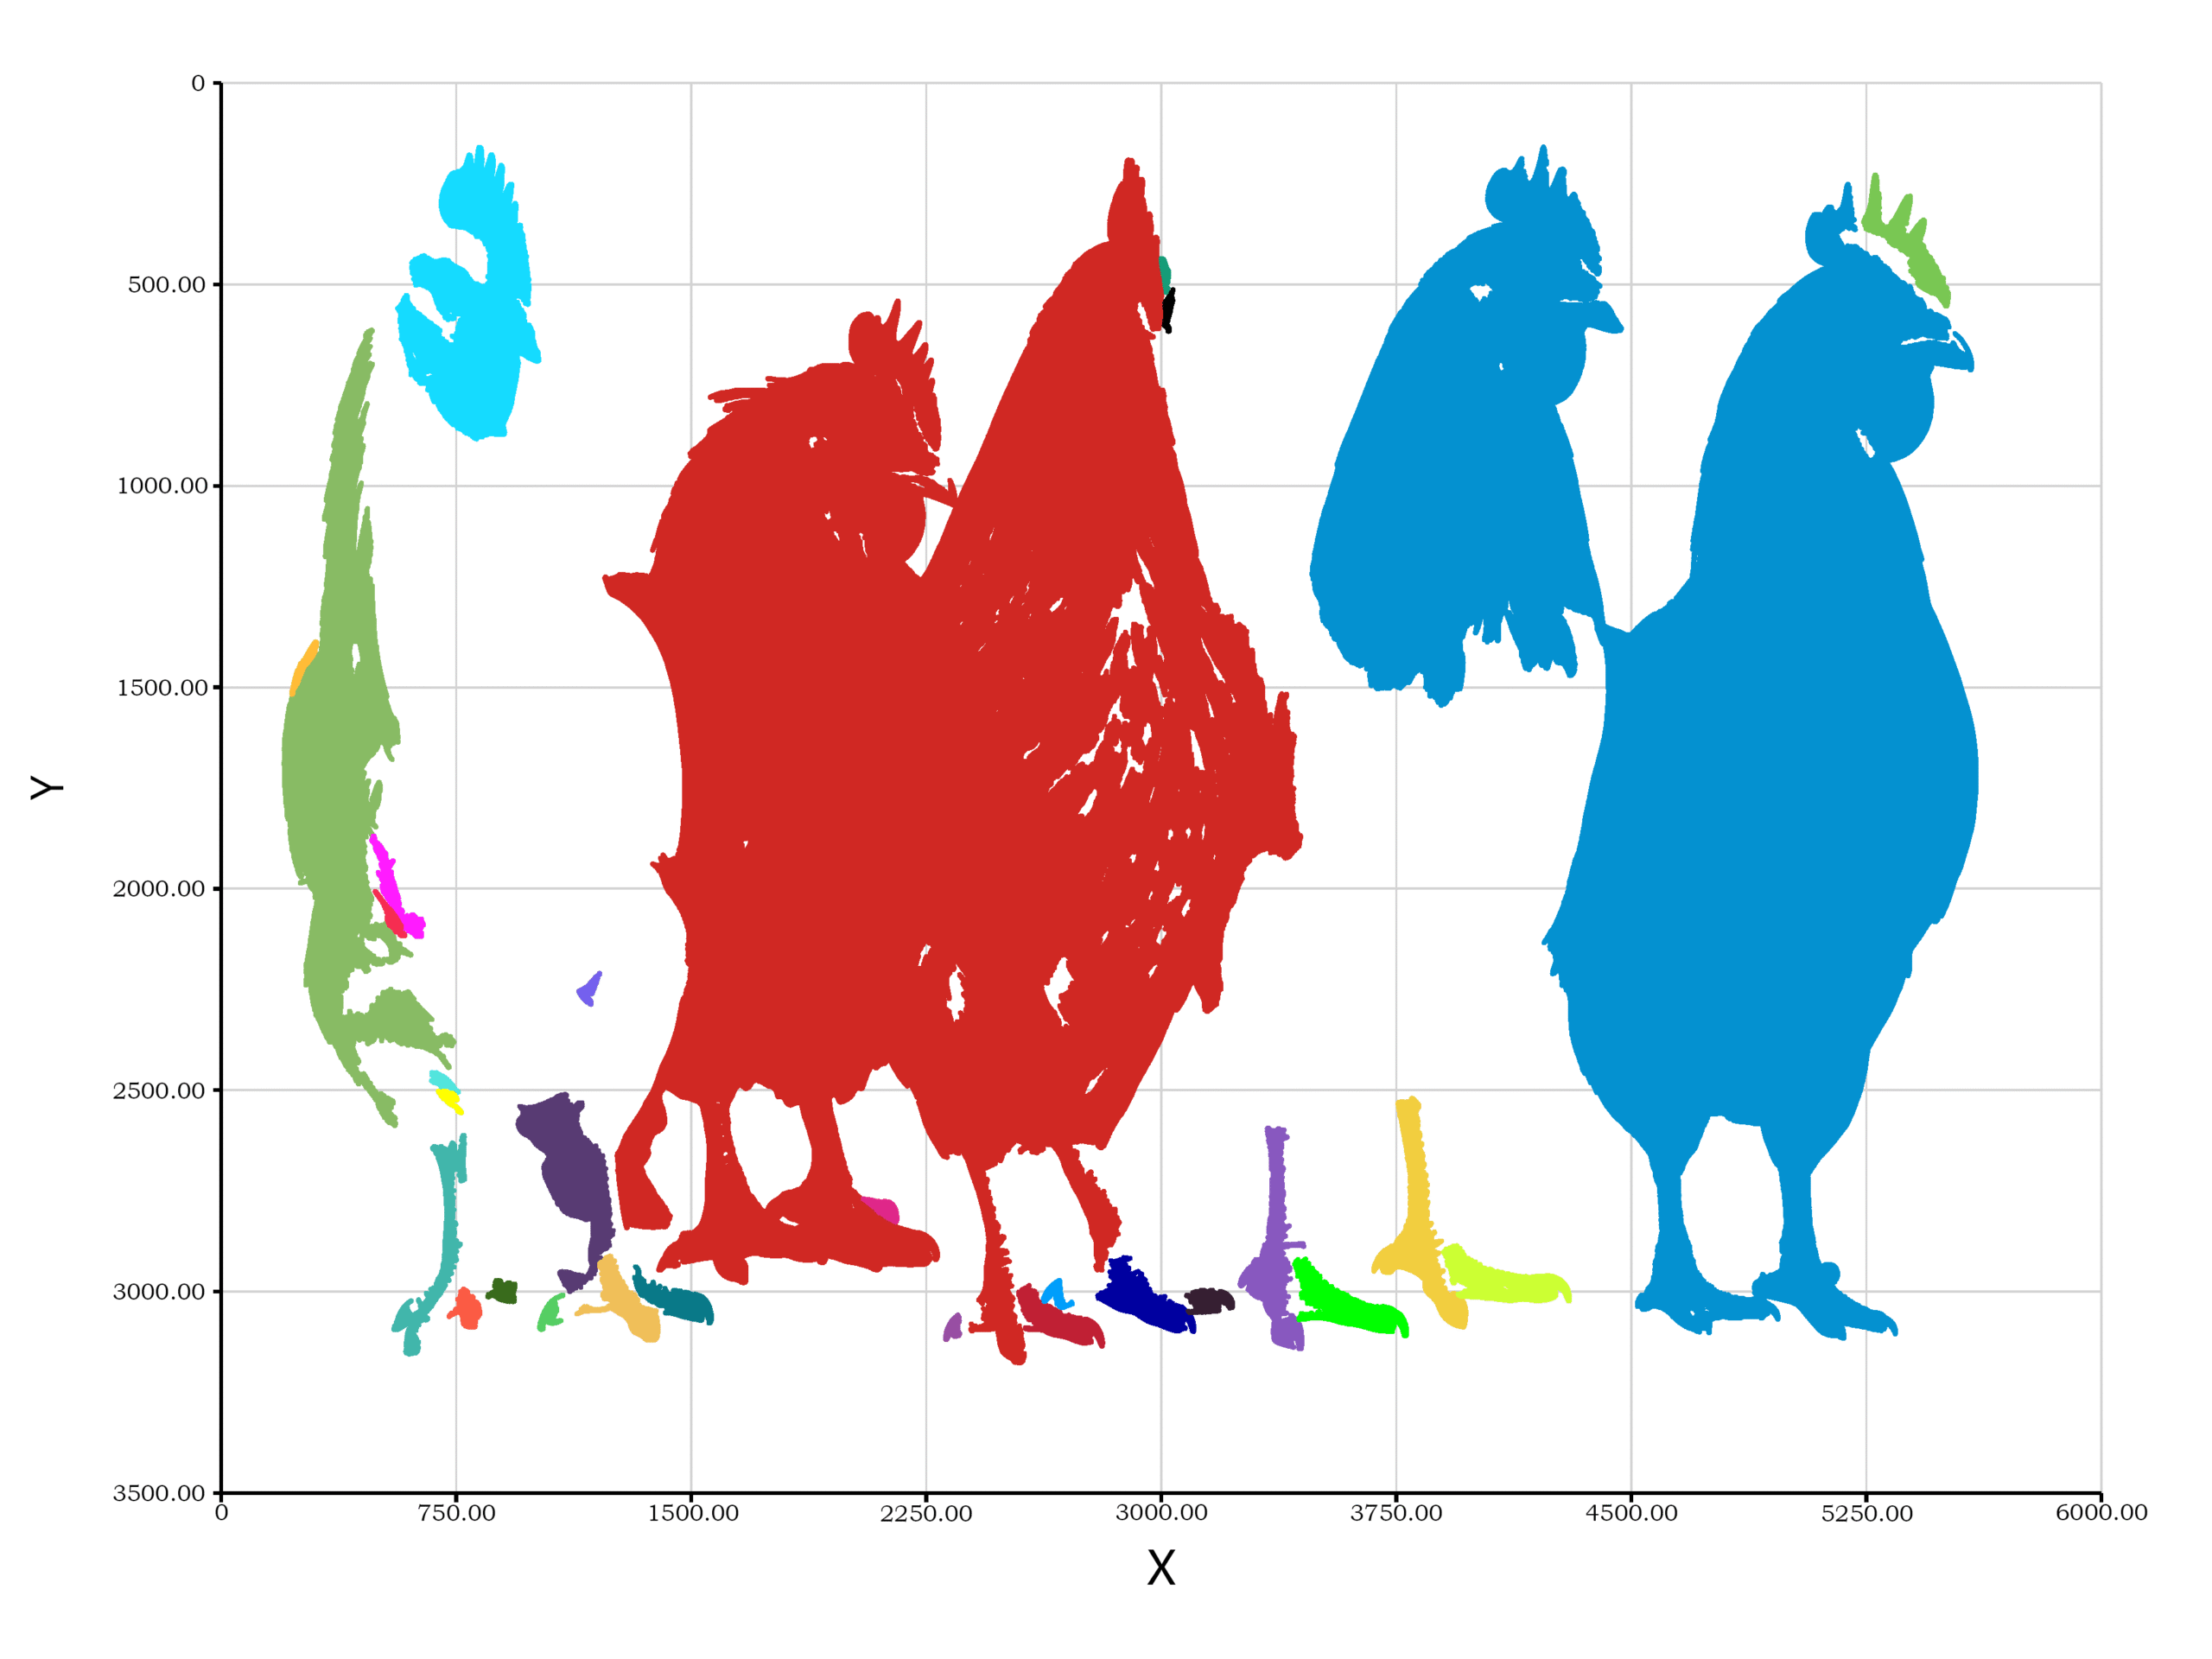
估计阅读时长: 2 分钟Connected Component Labeling(连通组件标记算法)主要用于识别并标记二值图像中相互连接的像素区域(即连通区域)。 imports "geometry2D" from "graphics"; imports "machineVision" from "signalKit"; let raw = readImage("—Pngtree—five chickens […]
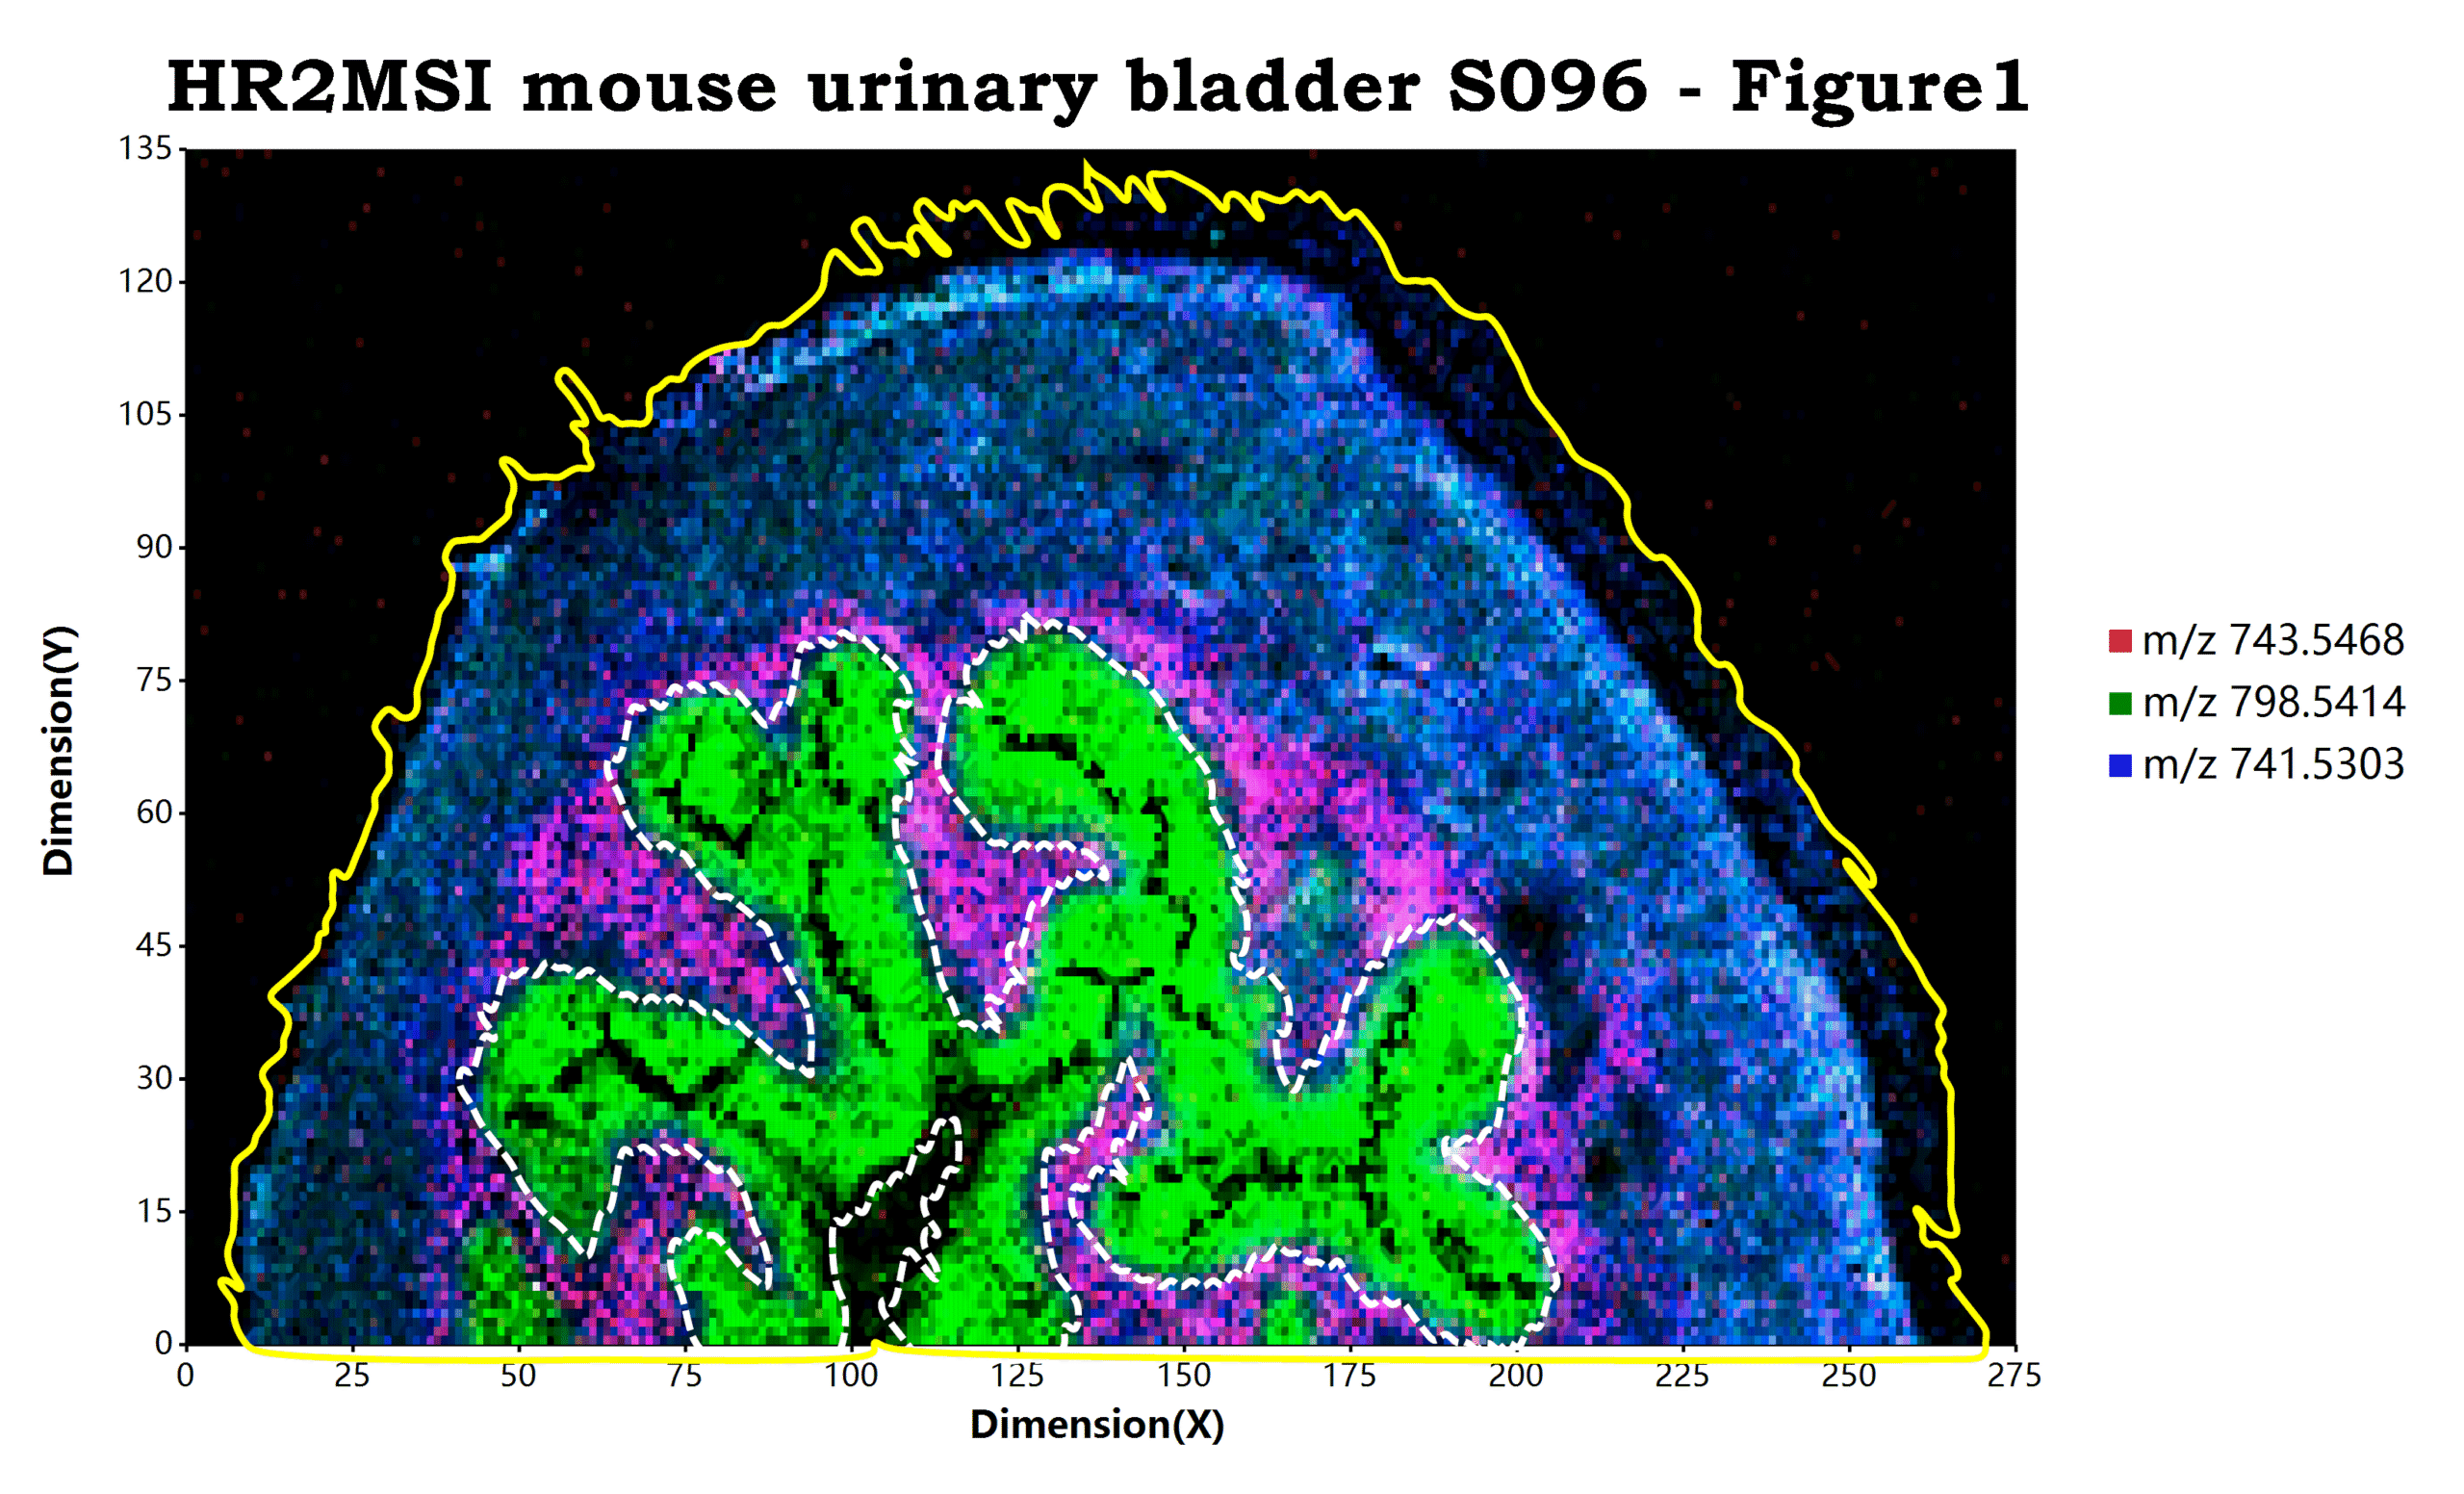
估计阅读时长: 10 分钟目前经过改进和优化之后的基于mzkit代码库底层的msimaging质谱成像软件包在样本可视化上进行了非常多的改进,诸如: 添加样本原始背景叠加 目前进行质谱成像可视化,程序包不仅仅可以使用任意rgb纯色来作为可视化的背景。目前还可以支持直接使用原始数据的背景作为质谱成像的显示背景。进行这个显示的秘诀就在于简单的在脚本中添加一个TIC背景图层:geom_MSIbackground("TIC") ggplot(msi_data, padding = "padding: 200px 600px 200px 250px;") + geom_MSIbackground("TIC") # rendering of […]
估计阅读时长: 12 分钟https://github.com/xieguigang/Microsoft.VisualBasic.Drawing 最近在Linux服务器上面搞数据分析,因为Linux服务器只能够是通过SSH远程登陆上去的,没有图形化界面,所以想查看生成的结果图的话,只能够将图片文件通过FileZilla工具从服务器上下载下来在本地查看。这种方法非常的繁琐,至少相对于在服务器上跑完了程序后直接查看结果这样子的操作要复杂一些。 如果要能够直接在Linux服务器上查看图片,可行的一个方法就是,如果你有服务器的Root权限的话,可以将你的目录通过smb协议共享出来,在windows上挂在为共享文件夹,这样子在Linux服务器上跑完命令后,再回到Windows的Explorer程序上刷新一下。但是这个对于网络地理位置较远的服务器而言,可能网络速度不是很好,对于几十兆的图片结果文件,可能刷新会存在延迟,你可能需要刷新好几次才会更新Windows上的图片缩略图;并且通过smb开放共享文件夹你还需要记住smb的第二套账号密码,如果账号密码过于简单,那么你的Linux服务器上的数据安全性就会存在问题。 另一个方案就是通过SSH-FS方案,通过你的ssh账号将远程Linux服务器挂载为本地硬盘,来查看服务器上生成的图片文件。但是这个也和上面的方案一样会受限于网络传输速度的影响。 看来,我们只能够在Linux的终端上想办法来进行图片文件的查看了。 AttachmentsSort by:DefaultDateName Capture • 268 KB • 1009 click 26.07.2025853127 • […]
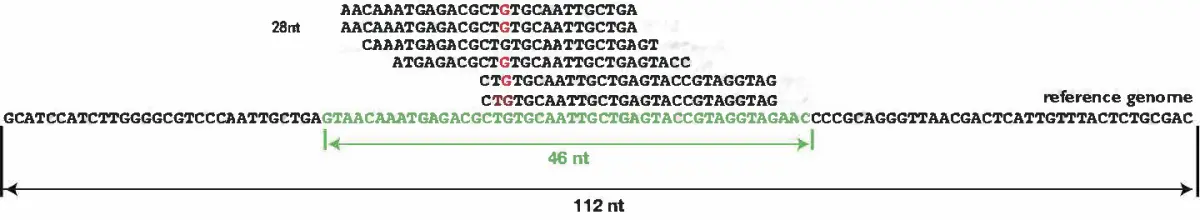
估计阅读时长: 11 分钟给定一组n个字符串数组,找到包含给定集合中每个字符串的最小字符串作为子字符串。我们可以假设这个字符串数组中没有字符串是另一个字符串的子字符串。那么基于上面的描述,我们就可以得到下面所示的问题求解目标: let arr[] = ["catg", "ctaagt", "gcta", "ttca", "atgcatc"] // output: gctaagttcatgcatc 上面的问题描述实际上是一个最短超字符串问题(shortest common superstring) AttachmentsSort […]
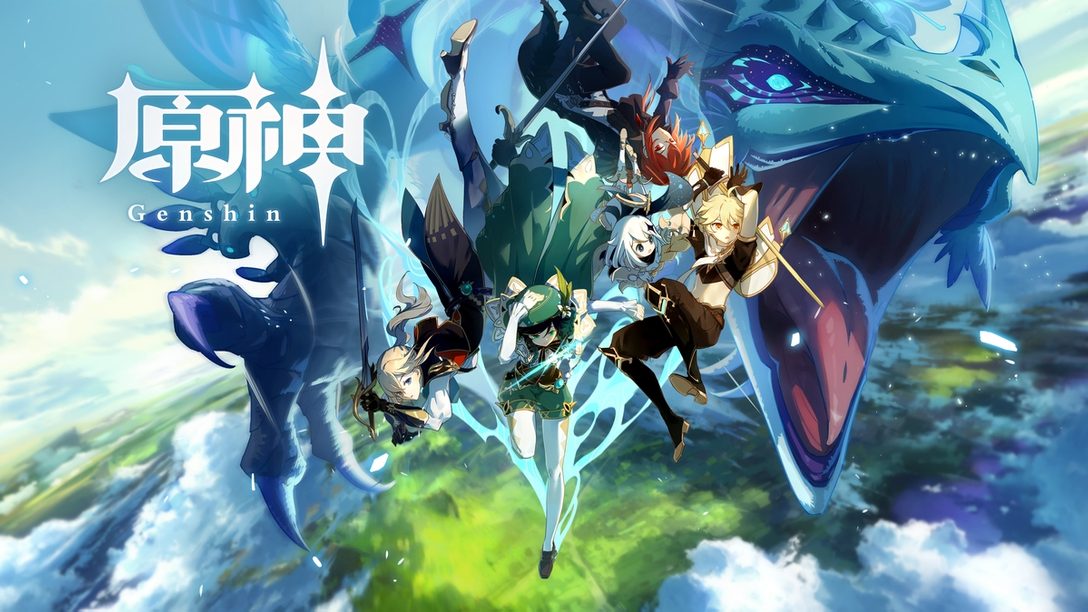
估计阅读时长: 5 分钟https://github.com/xieguigang/scale_colour_genshin 在用R绘图时,颜色设置是美化过程中不可缺少的一步。在实际绘图时,一般不会一一手动寻找合适的颜色,而是通过一些R包、网站提供好的,美观的颜色组合,即调色板(palette),可供使用。在这里介绍一种通过提取图片主题色的方法来为我们自动生成画图所用的颜色板数据。 AttachmentsSort by:DefaultDateName 383807b4 • 132 KB • 1140 click 08.04.2023faruzan • 558 KB • […]
估计阅读时长: 8 分钟https://github.com/rsharp-lang/NRRD NRRD(Nearly Raw Raster Data)是一种用于存储类似于热图成像数据的文件格式。其实我们可以将NRRD看作为类似于bitmap之类的未压缩的原始光栅图像文件。只要我们有对应的解码方式,我们就可以像查看普通图片文件一样查看NRRD文件。 AttachmentsSort by:DefaultDateName raster__238 • 60 KB • 1157 click 10.03.2023nrrd_text • […]

This content speaks to hearts
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 对于基于ec number来生成层级数据,我们直接使用《酶EC编号结构解析》文章末尾所展示的层级数据生成函数来实现。 […]
[…] 在前面的一篇《基因组功能注释(EC Number)的向量化嵌入》博客文章中,针对所注释得到的微生物基因组代谢信息,进行基于TF-IDF的向量化嵌入之后。为了可视化向量化嵌入的效果,通过UMAP进行降维,然后基于降维的结果进行散点图可视化。通过散点图可视化可以发现向量化的嵌入结果可以比较好的将不同物种分类来源的微生物基因组区分开来。 […]