
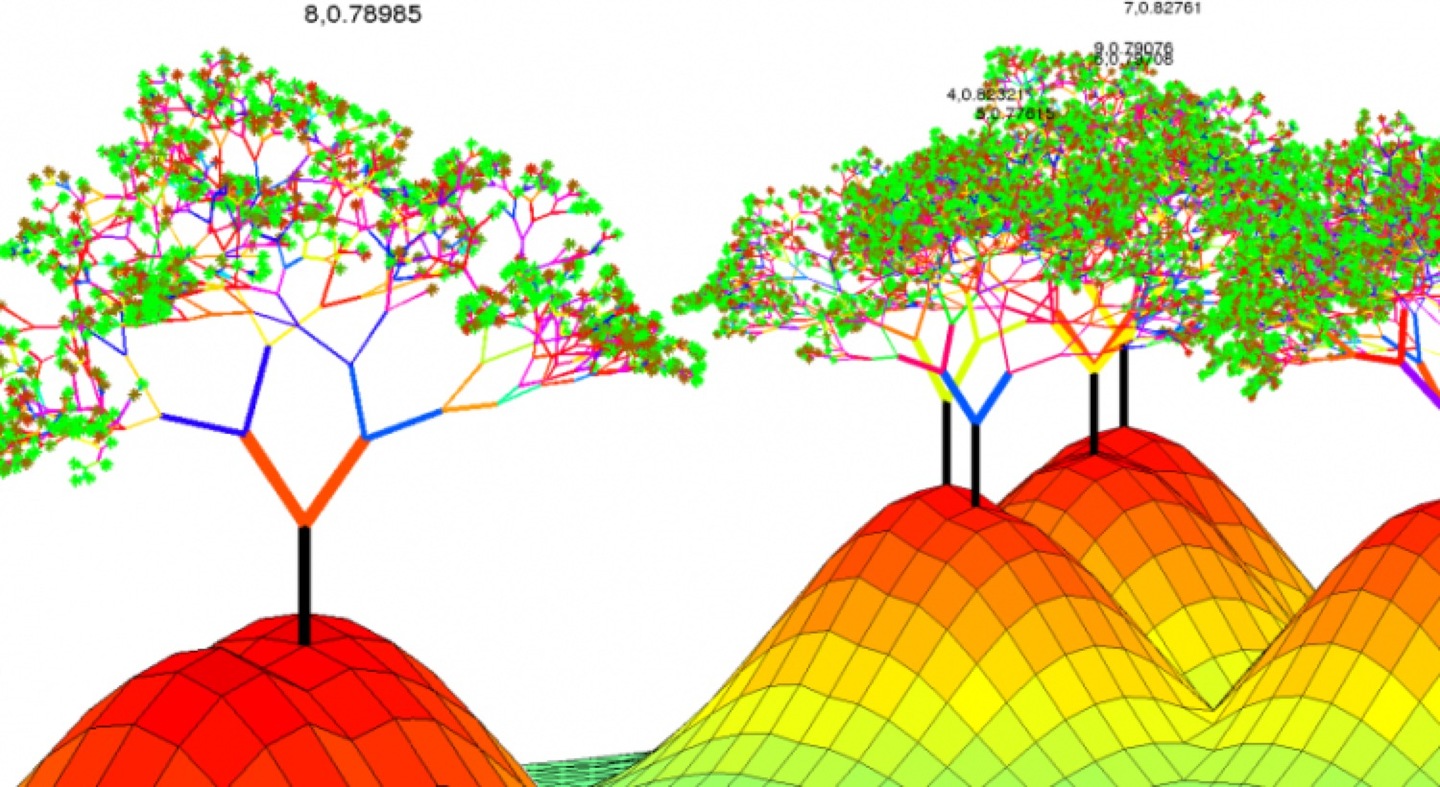
估计阅读时长: 9 分钟https://github.com/xieguigang/sciBASIC 在实际应用的机器学习方法里,GradientTree Boosting (GBDT)是一个在很多应用里都很出彩的技术。XGBoost是一套提升树可扩展的机器学习系统。XGBoost全名叫(eXtreme Gradient Boosting)极端梯度提升。它是大规模并行boosted tree的工具,XGBoost 所应用的算法就是 GBDT(gradient boosting decision tree)的改进,既可以用于分类也可以用于回归问题中。 AttachmentsSort by:DefaultDateName ROC • […]
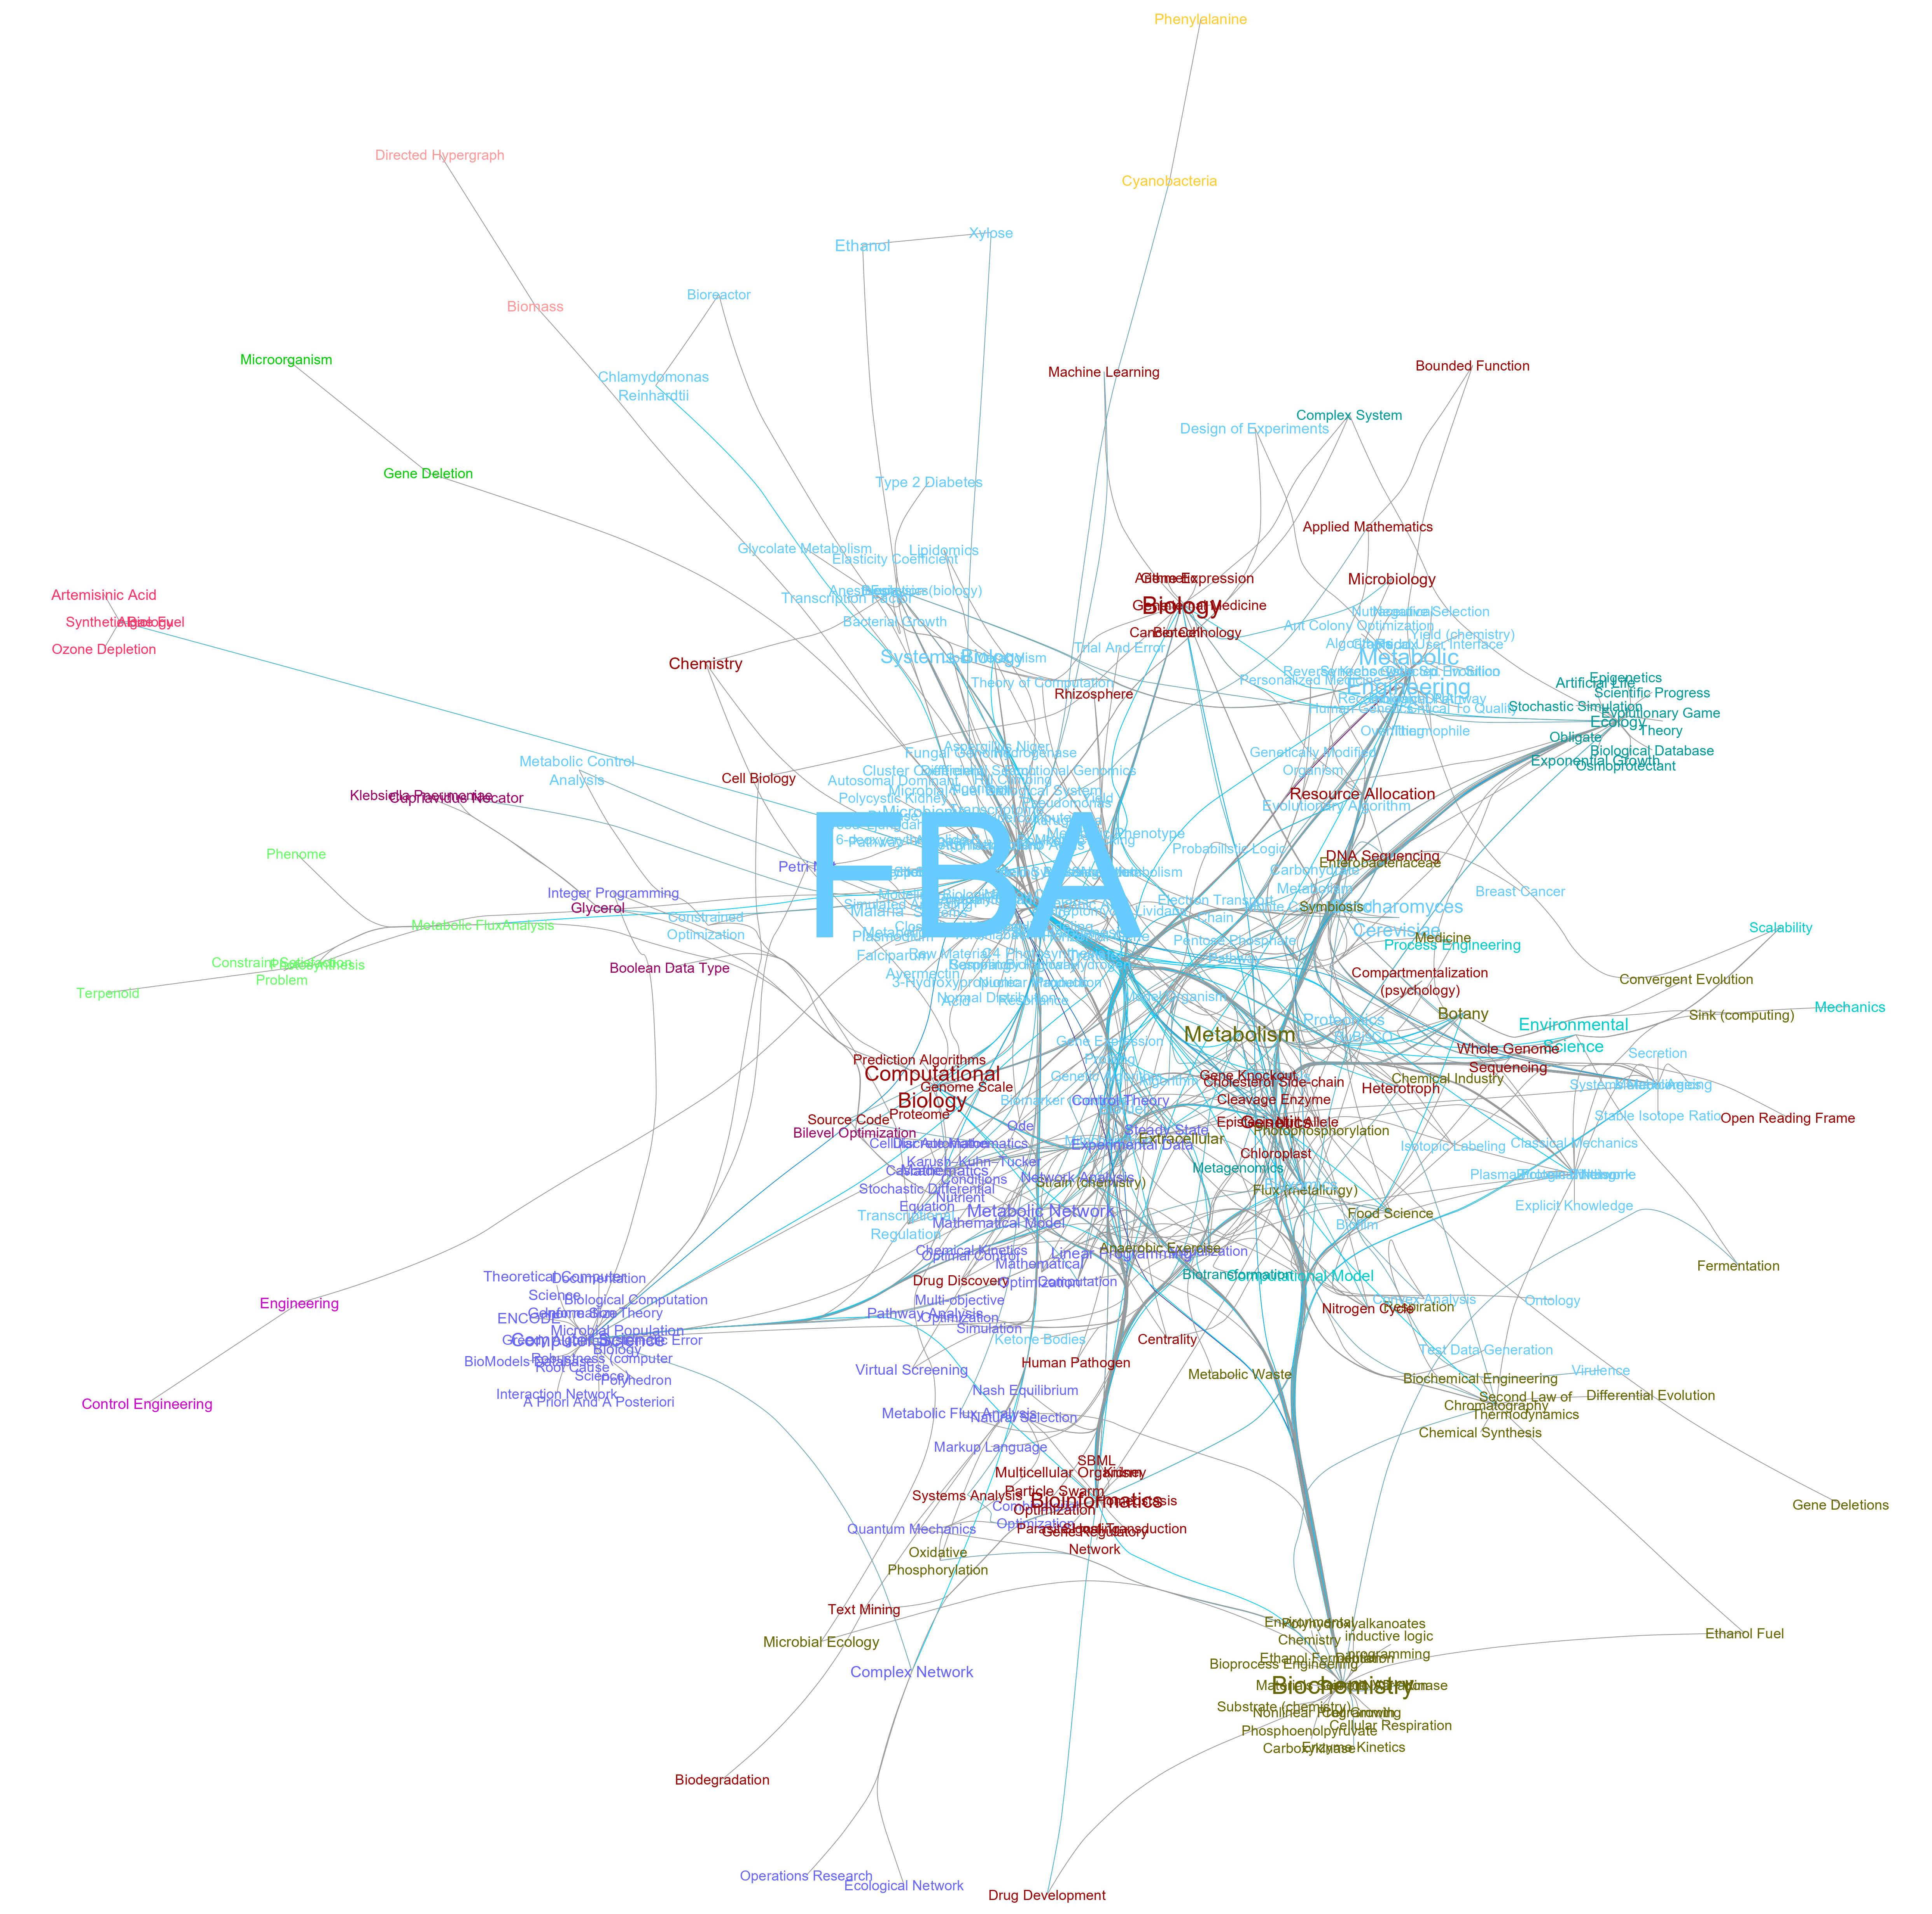
估计阅读时长: 7 分钟https://github.com/rsharp-lang/bing-academic 我们在进行一个新的课题项目开始之前,会需要经历过一个开题立项的报告过程。在这个过程之中,我们需要收集与课题相关的信息,例如相关的知识背景信息,建立出一个与课题相关的知识网络。基于此知识网络进行课题的技术相关概念的梳理。 AttachmentsSort by:DefaultDateName v2-8119594eef2838042df8fb5af0523c0c_720w • 125 KB • 1119 click 15.08.2021v2-96d82f034d4084cf1ed6eb4784f36ed4_r • 246 KB • […]
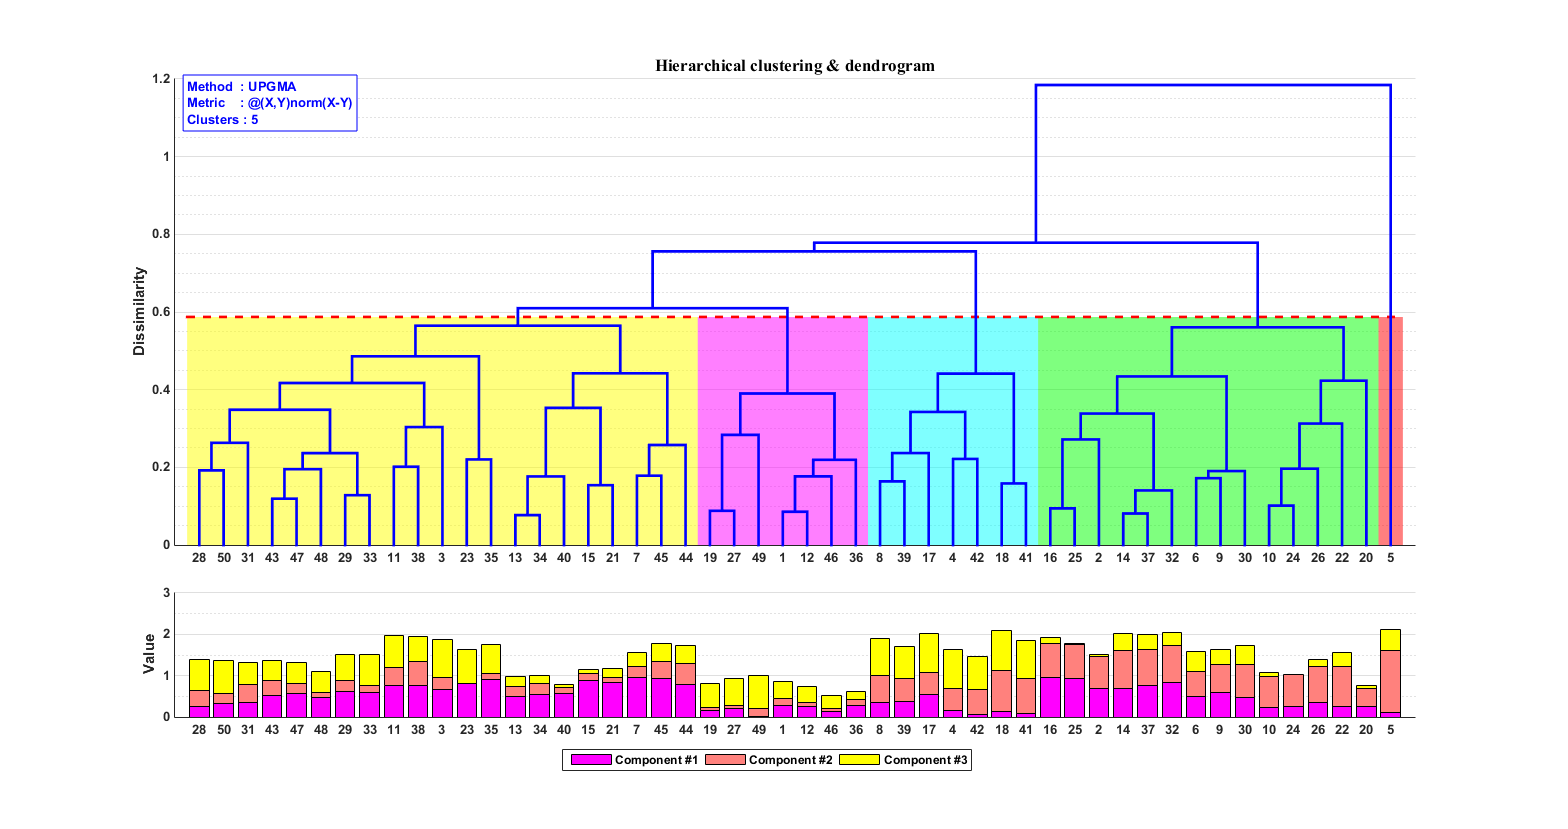
估计阅读时长: 14 分钟https://github.com/xieguigang/sciBASIC 层次聚类通过计算不同类别数据点间的相似度来创建一棵有层次的嵌套聚类树。基于层次聚类分析,我们可以初步可视化我们的一些原始数据: 例如对样本的层次聚类分类,可以让我们了解到样本在分组之间以及分组内的异质性。 对生物序列进行基于相似度的层次聚类分析,我们可以了解到序列之间的相似性程度或者进化关系 AttachmentsSort by:DefaultDateName metabolome • 14 KB • 1110 click 13.08.2021hclust_samples • 102 […]
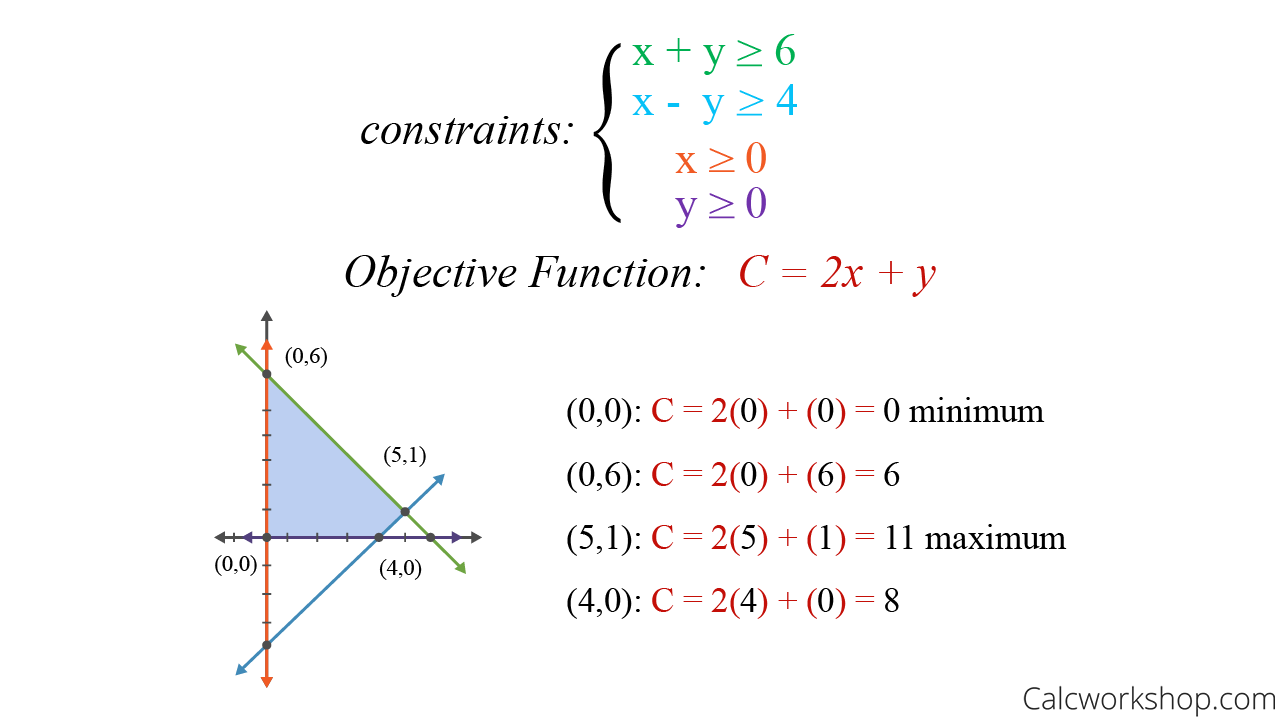
估计阅读时长: 30 分钟https://github.com/xieguigang/sciBASIC/ 线性规划(Linear programming,简称LP)方法起源于20世纪40年代,由美国数学家乔治·丹齐格(George Dantzig)提出,并设计了著名的“单纯形法”。这种优化算法是运筹学中研究较早、发展较快、应用广泛、方法较成熟的一个重要分支,它是辅助人们进行科学管理的一种数学方法。研究线性约束条件下线性目标函数的极值问题的数学理论和方法。通俗点的来讲,就是我们基于这一种数学优化技术,用于在一组线性约束条件下,求解线性目标函数的最大值或最小值(就是在“有限资源”和“一定规则”下,找到“最佳方案”的一种方法)。 AttachmentsSort by:DefaultDateName linear-programming-example • 21 KB • 1197 click 11.08.2021chi-graph-white-long • 24 […]
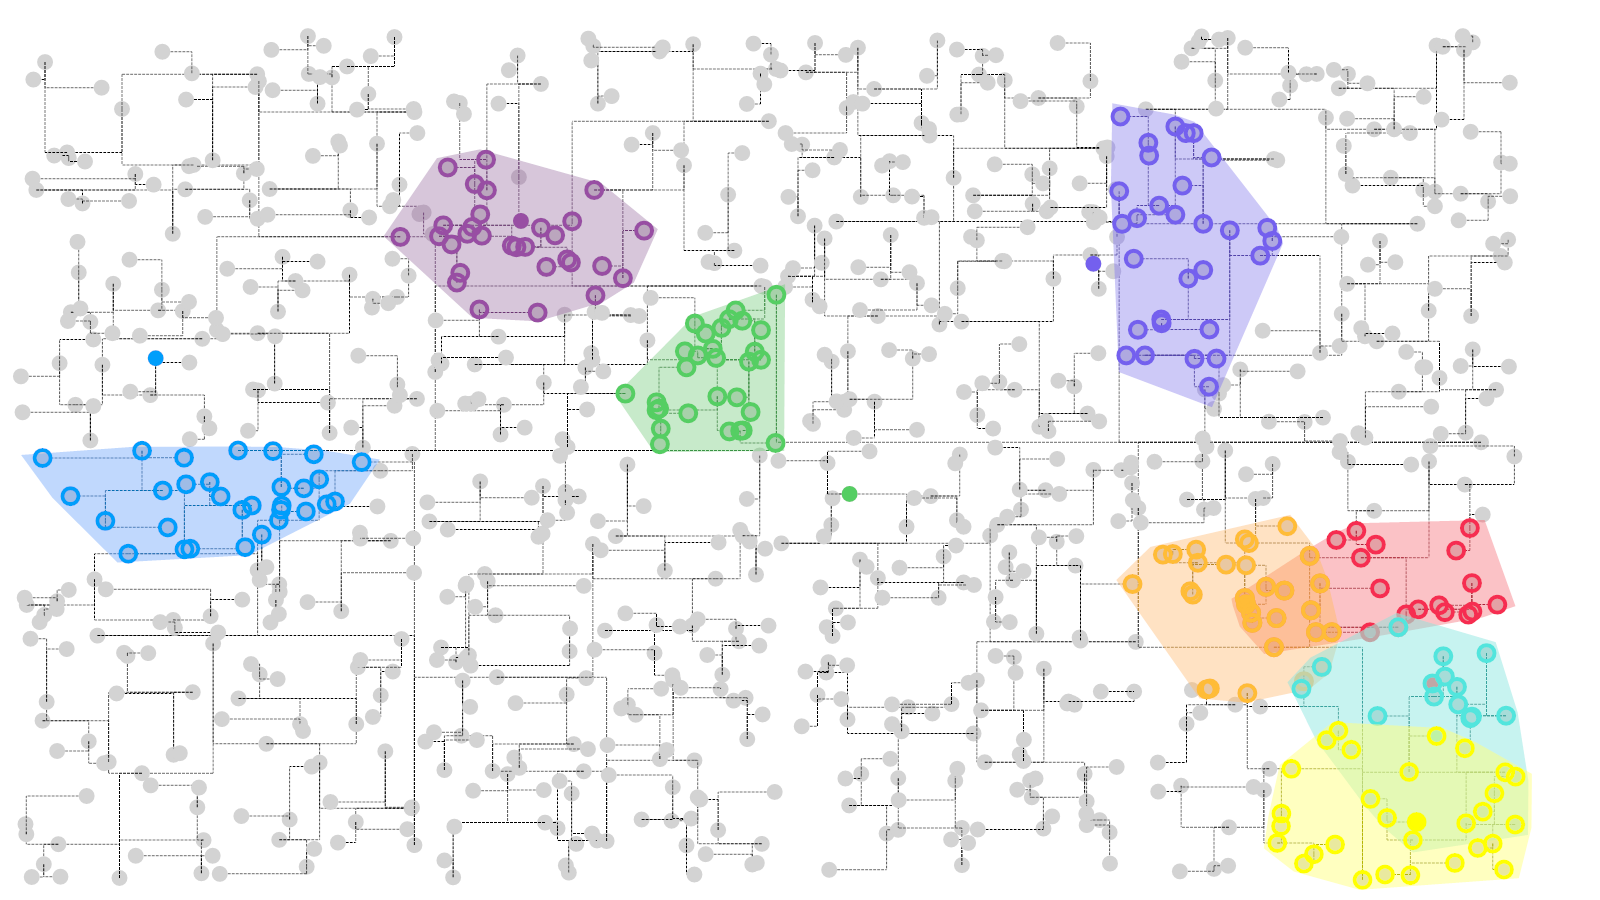
估计阅读时长: 8 分钟https://github.com/xieguigang/sciBASIC 在进行无监督聚类分析的方法之中,我们在算法代码之中一般会遇到求解与某一个样本数据点最相似的数据点的计算过程。对于这个计算过程,一般而言我们是基于欧几里得距离来完成的。 AttachmentsSort by:DefaultDateName Visual a KDtree Search • 274 KB • 1181 click 10.08.2021Visual a […]
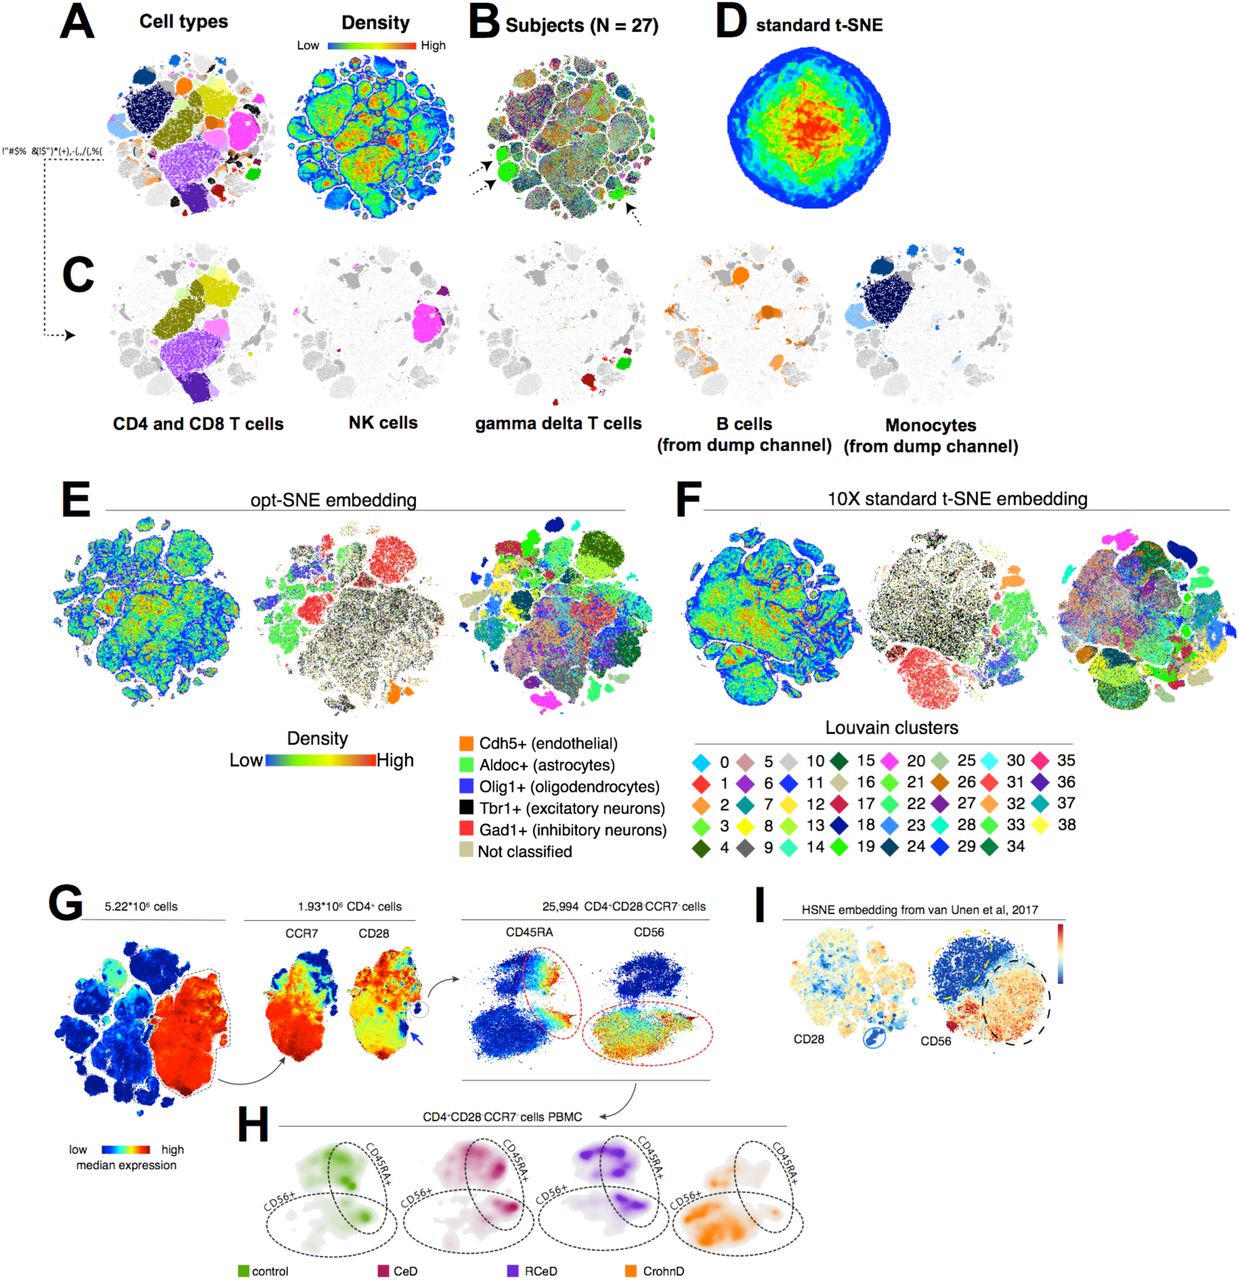
估计阅读时长: 11 分钟PhenoGraph提供了与UMAP类似的算法过程进行单细胞组学数据的细胞分型处理操作。与UMAP方法相比,PhenoGraph并不会产生数据降维效果,仅仅产生数据点Cluster信息。如果需要将数据进行可视化,还需要借助于t-SNE算法将PhenoGraph的分型结果数据投影到一个二维平面上完成。 AttachmentsSort by:DefaultDateName Phenograph-image4 • 199 KB • 1054 click 09.08.2021Automated Optimal Parameters for T-Distributed Stochastic […]
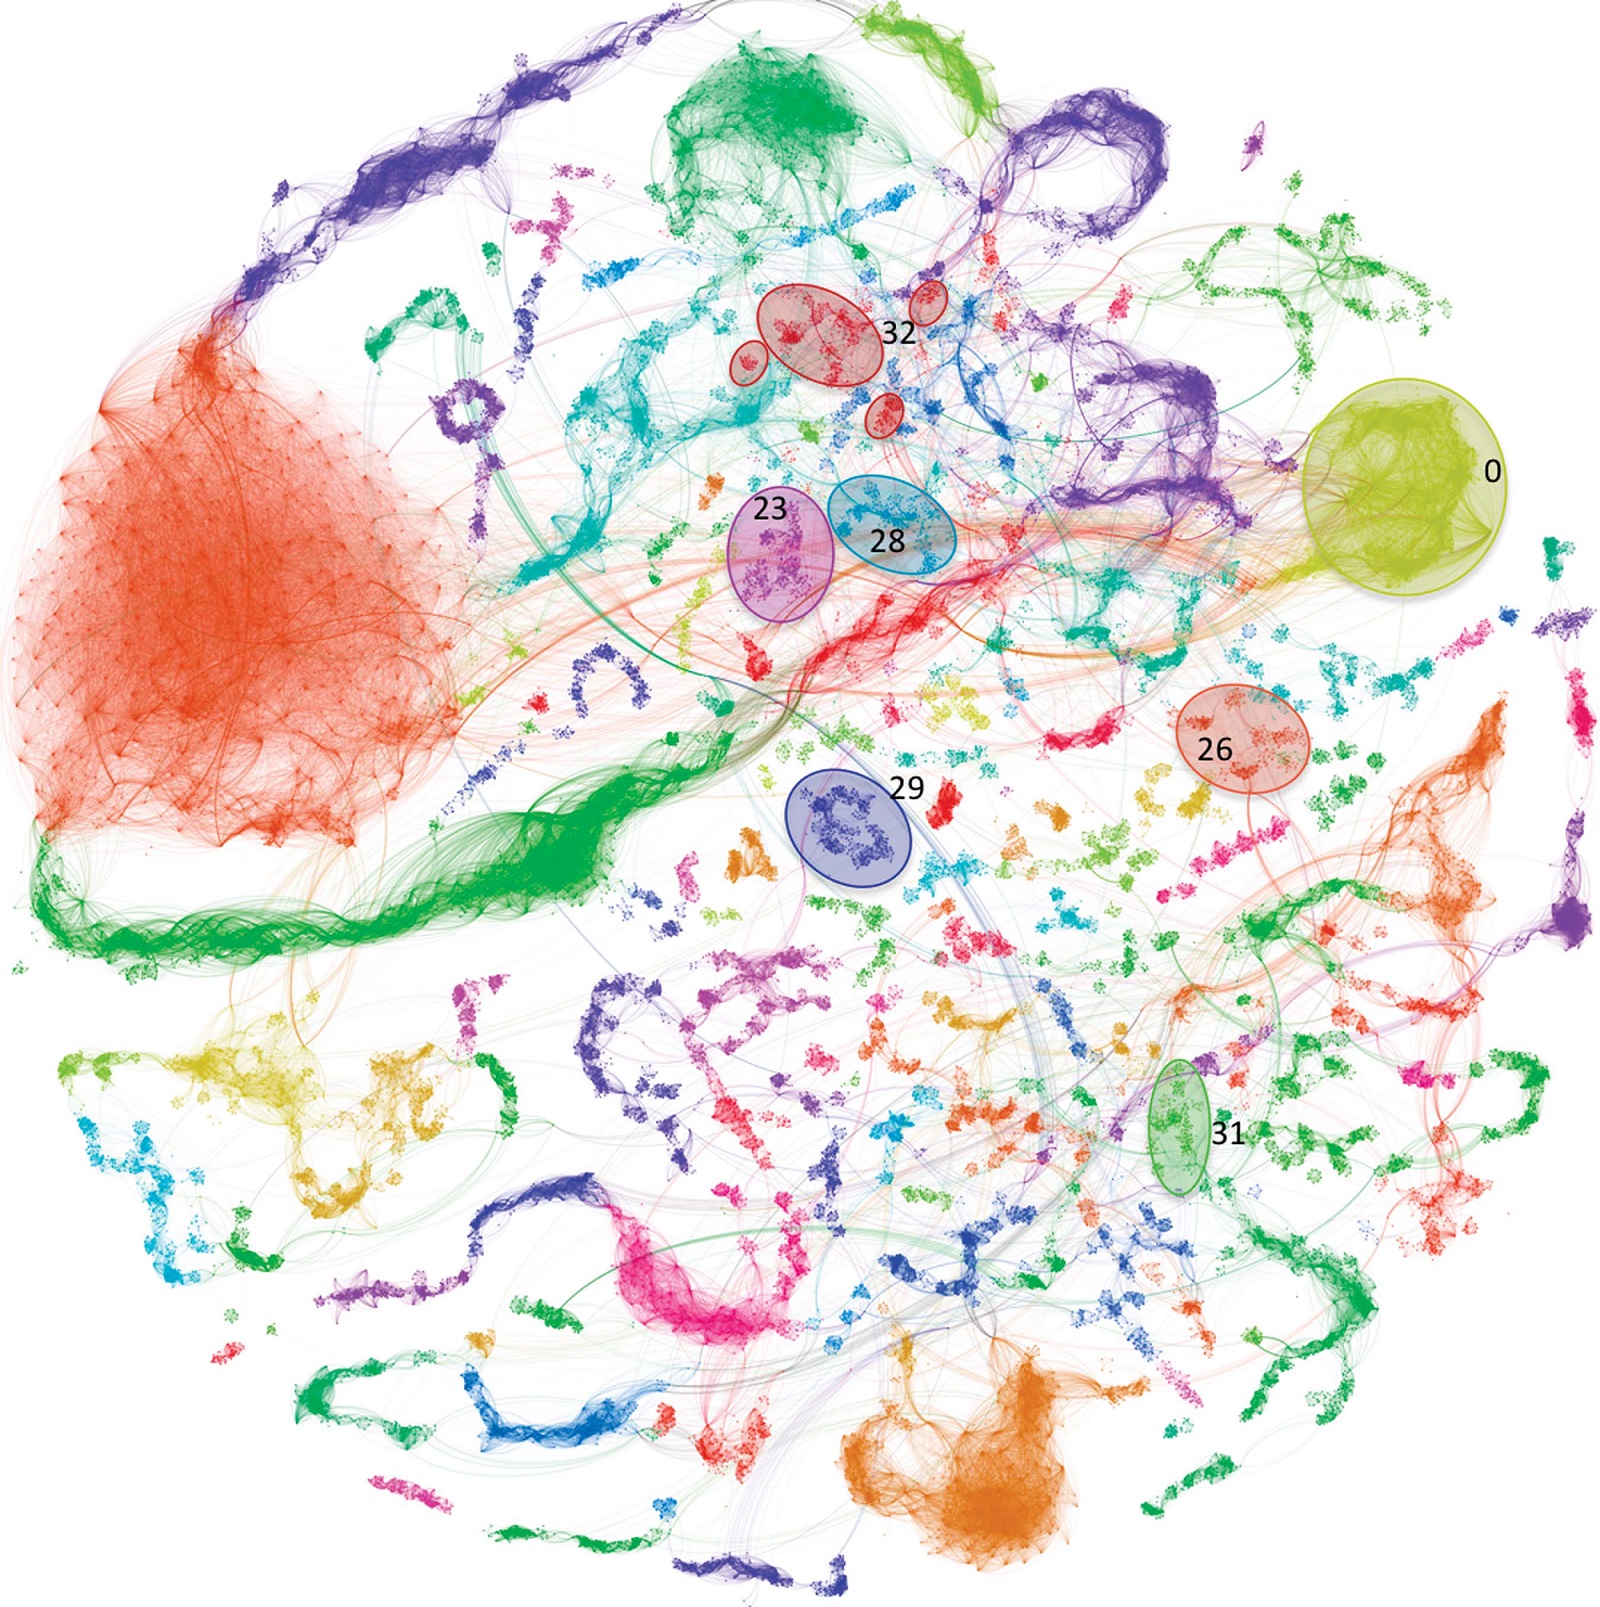
估计阅读时长: 11 分钟https://github.com/xieguigang/sciBASIC Louvain算法是基于模块度的网络节点集群发现算法。该算法在效率和效果上都表现较好,并且能够发现层次性的网络节点集群结构,其优化目标是最大化整个网络集群模块的模块度(Modularity)。 AttachmentsSort by:DefaultDateName graph • 1 MB • 1152 click 07.08.2021Metavirome network • 788 KB […]
估计阅读时长: < 1 分钟https://github.com/xieguigang/codegraph Attachments Microsoft.VisualBasic.Framework_v47_dotnet_8da45dcd8060cc9a.dll • 9 MB • 1093 click 29.08.2021
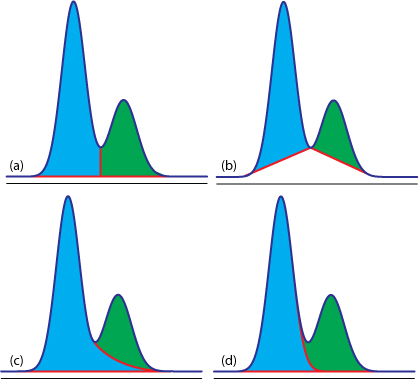
估计阅读时长: 8 分钟https://github.com/xieguigang/sciBASIC/tree/master/Data_science/Mathematica/SignalProcessing 进行峰识别是在代谢组学原始数据分析之中进行定量分析的很重要的一环。在代谢组学之中,定量分析分为靶向定量,以及非靶向定量计算这两大部分。 AttachmentsSort by:DefaultDateName Figure12.36 • 49 KB • 1136 click 10.07.2021view_signal • 56 KB • […]
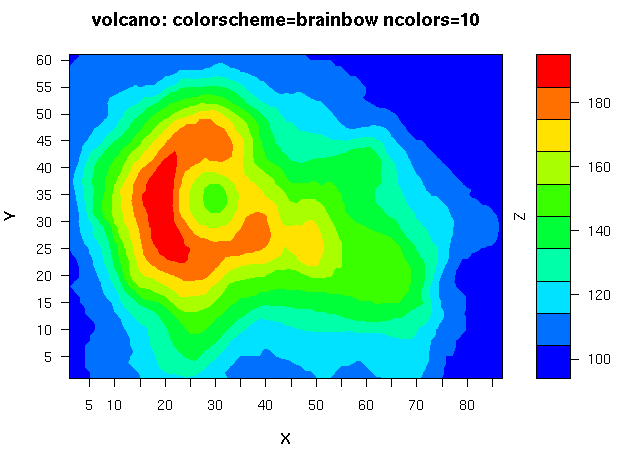
估计阅读时长: 16 分钟https://github.com/xieguigang/sciBASIC 等高线指的是地形图上高程相等的相邻各点所连成的闭合曲线。把地面上海拔高度相同的点连成的闭合曲线,并垂直投影到一个水平面上,并按比例缩绘在图纸上,就得到等高线。 AttachmentsSort by:DefaultDateName 1_Contour • 487 KB • 1365 click 30.06.2021Ms1Contour • 163 KB • […]

This content speaks to hearts
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 对于基于ec number来生成层级数据,我们直接使用《酶EC编号结构解析》文章末尾所展示的层级数据生成函数来实现。 […]
[…] 在前面的一篇《基因组功能注释(EC Number)的向量化嵌入》博客文章中,针对所注释得到的微生物基因组代谢信息,进行基于TF-IDF的向量化嵌入之后。为了可视化向量化嵌入的效果,通过UMAP进行降维,然后基于降维的结果进行散点图可视化。通过散点图可视化可以发现向量化的嵌入结果可以比较好的将不同物种分类来源的微生物基因组区分开来。 […]