
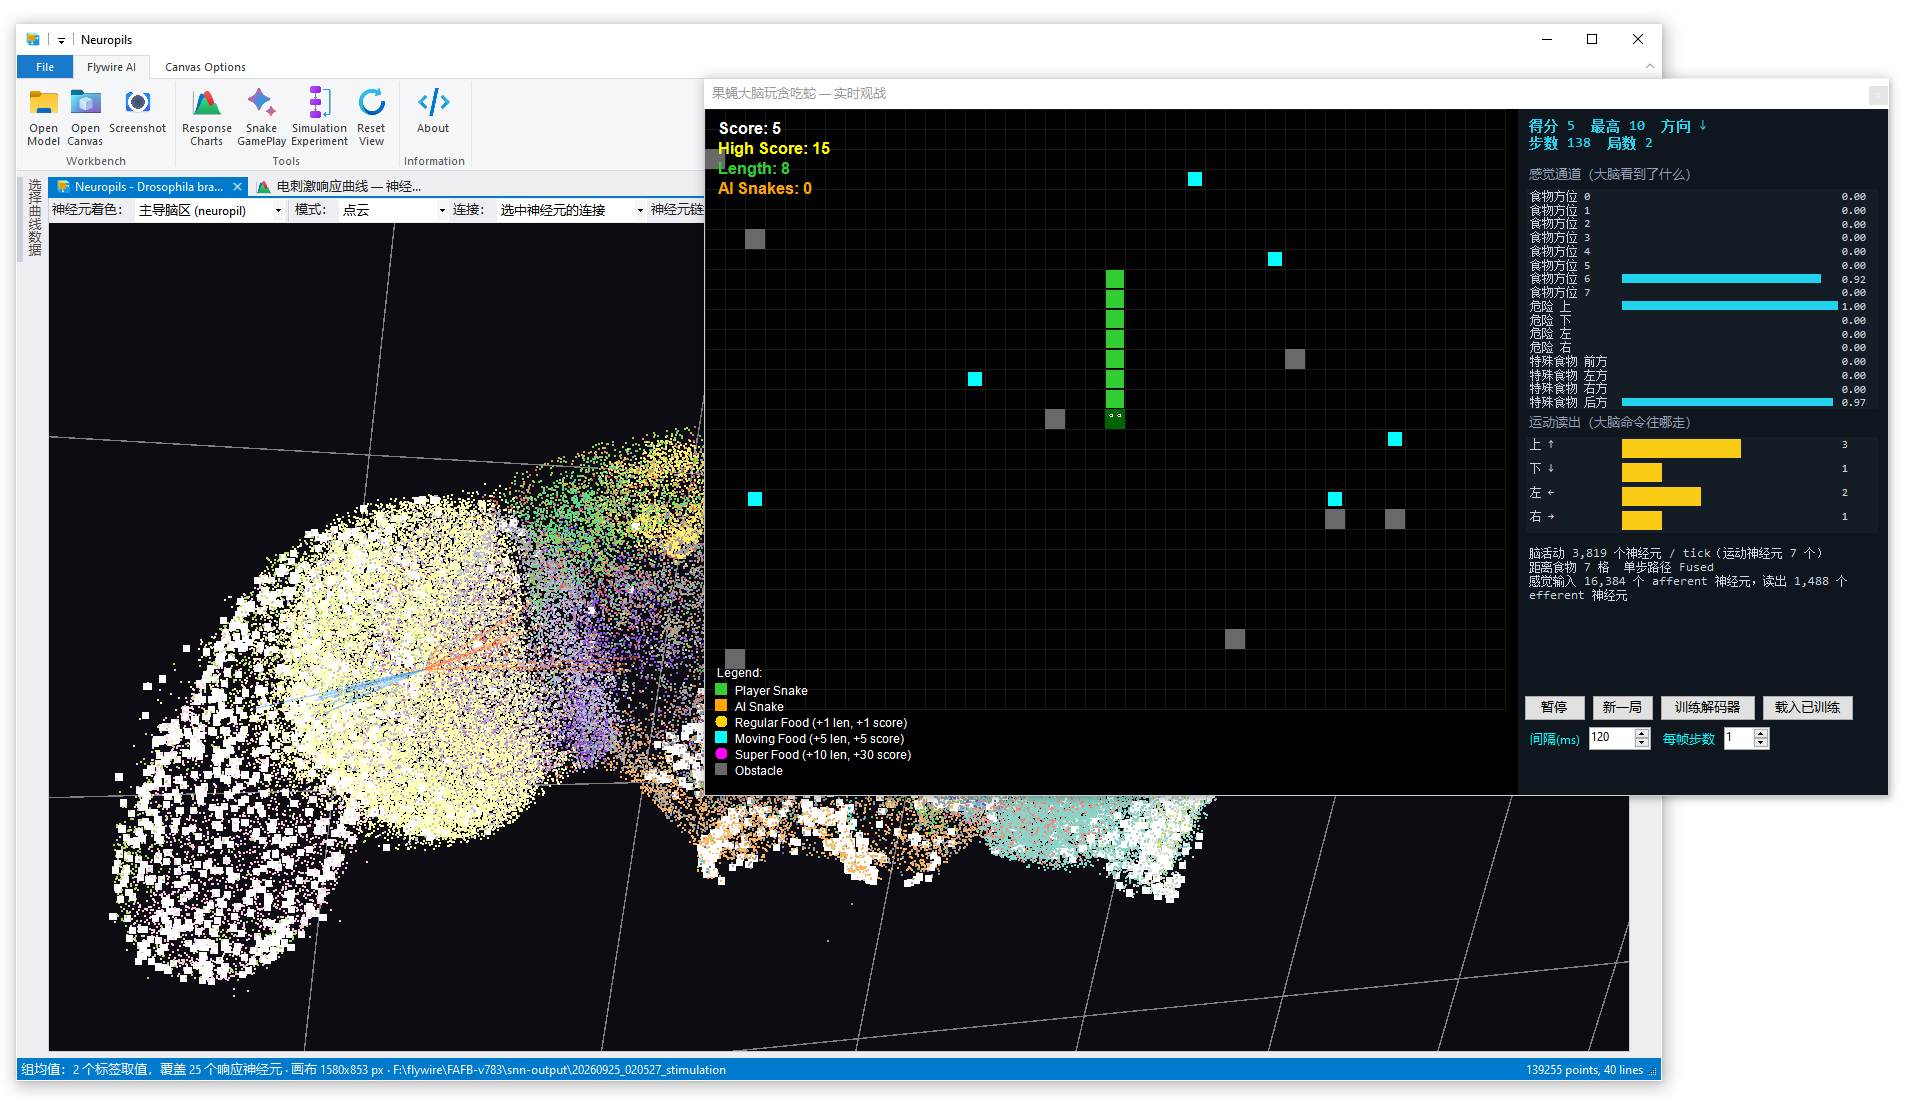
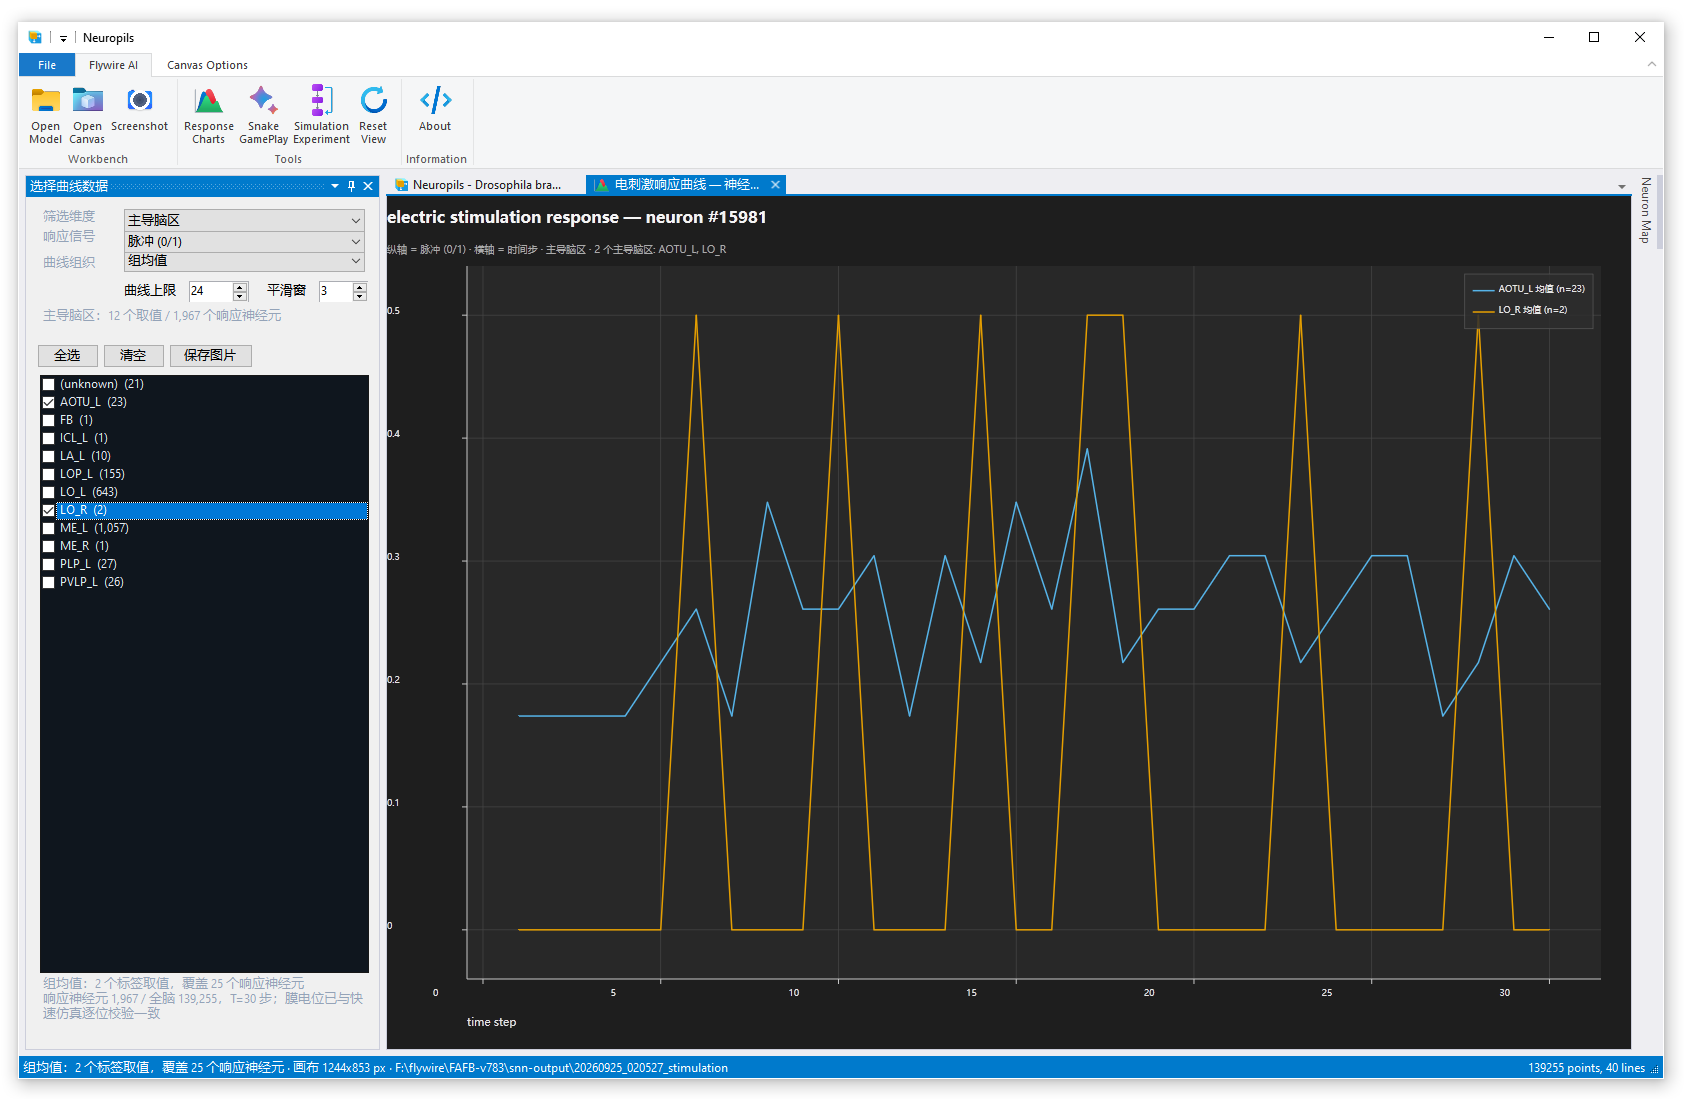
估计阅读时长: 10 分钟Github开源地址:https://github.com/xieguigang/flywire 本文是"果蝇赛博生命"三部曲的第三篇,也是高潮篇。前两篇我们讲清了脉冲神经元的"漏水桶"模型(第一篇),以及 FAFB-v783 连接组这张 5000 万条记录的全脑"通话清单"(第二篇)。今天,我们要做两件事:第一,给这只果蝇通电,看看她大脑里哪片区域在亮;第二,把贪吃蛇游戏接进她的大脑,让她自己玩。 然后——因为这篇文章写得足够长——我们顺便讨论一下人类的数字永生、缸中之脑、《黑客帝国》和《流浪地球 2》。坐稳了。
估计阅读时长: 6 分钟Github开源地址:https://github.com/xieguigang/flywire 本文是"果蝇赛博生命"三部曲的第二篇。上一篇我们讲明白了脉冲神经网络(SNN)的原理:神经元是会漏水的桶,脉冲是它们唯一的语言。但一个悬而未决的问题是——桶和桶之间的水管,到底怎么接? 传统的做法是训练出来的。而我们的做法更"莽":直接把一只真实果蝇的全脑接线图下载下来,照着抄。
估计阅读时长: 6 分钟Github开源地址:https://github.com/xieguigang/sciBASIC 本文是"果蝇赛博生命"三部曲的第一篇。我们不讲果蝇,也不讲贪吃蛇,只讲一件事:计算机是如何模仿你的大脑在"想事情"的。 放心,全文不需要任何机器学习背景,需要的只有高中数学,和一个愿意被比喻轰炸的开放心态。
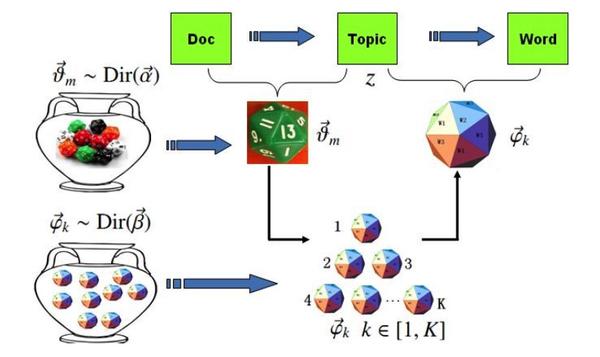
估计阅读时长: 20 分钟LDA(Latent Dirichlet Allocation,潜在狄利克雷分配)是一种用于发现文档集合中潜在主题的生成式概率模型。它假设文档是由多个主题混合而成的,而每个主题又是通过一定的概率分布选择词语生成的。LDA模型包含词、主题和文档三层结构,通过概率生成过程模拟文档的形成。Gibbs LDA 的核心在于使用吉布斯采样方法来推断这些隐藏的主题分布。
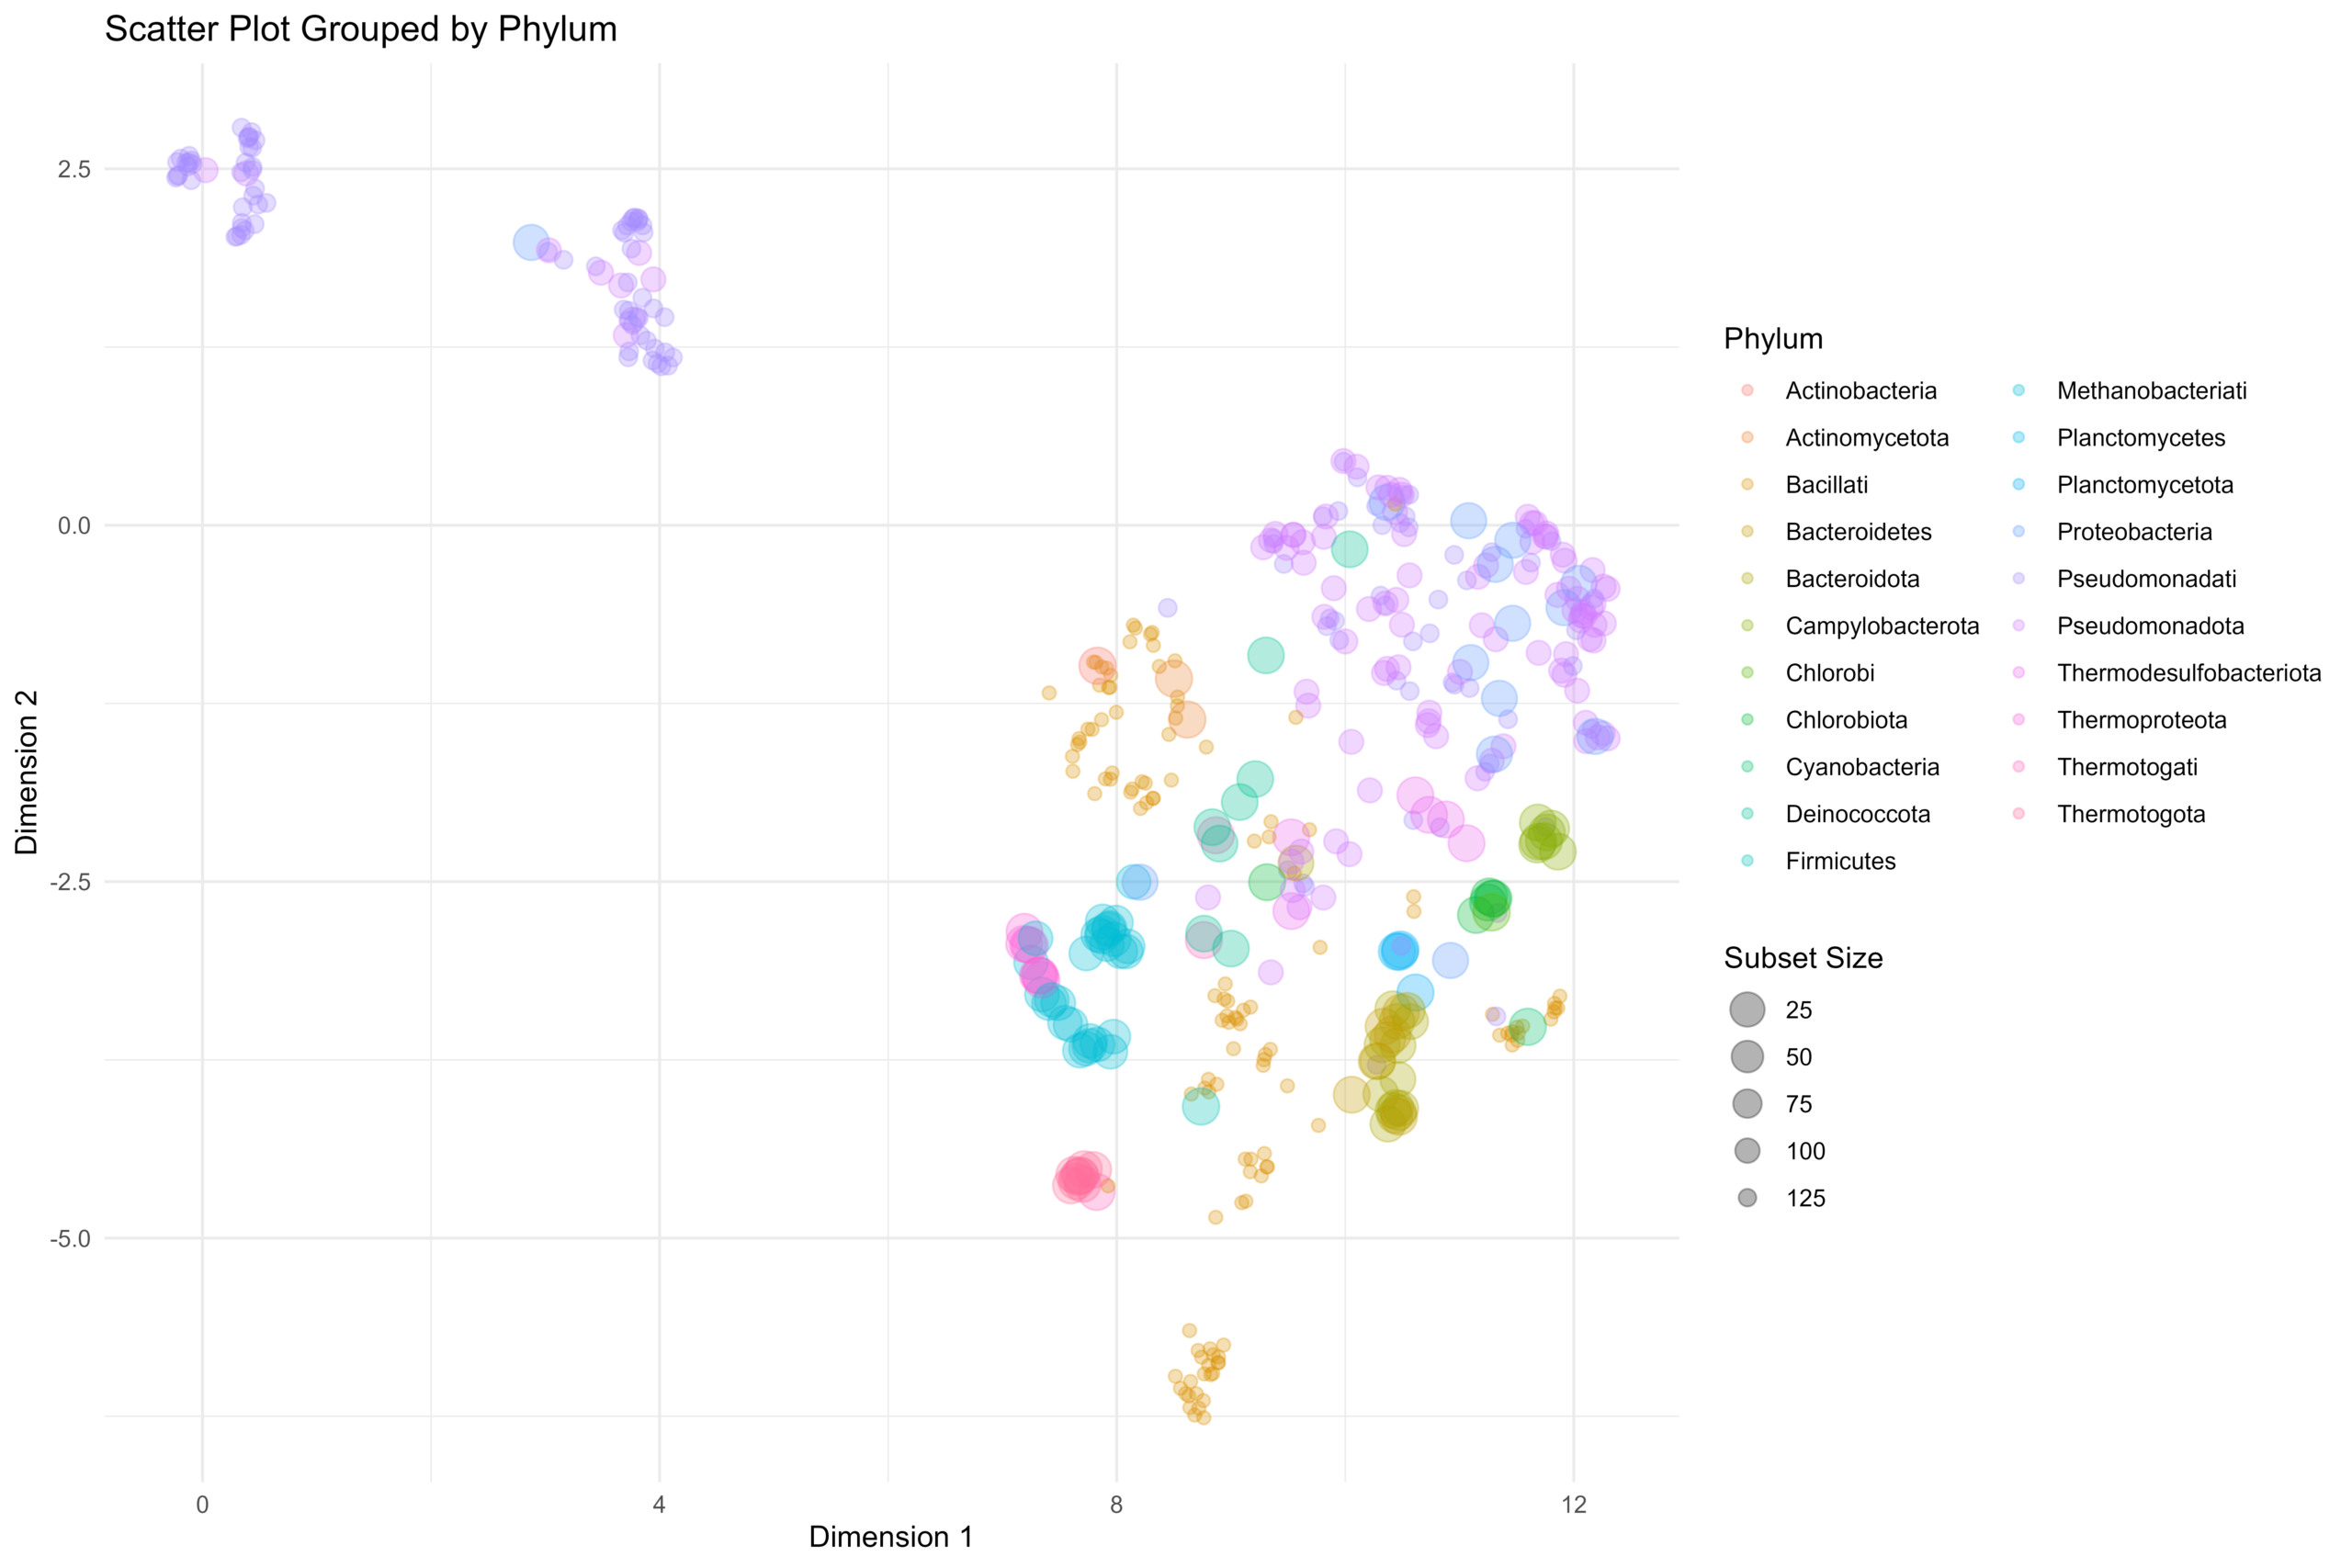
估计阅读时长: 17 分钟EC Number是国际酶学委员会(IUBMB)制定的一套酶分类编号体系,EC Number采用层级分类法,由4个数字组成,分别代表酶的大类、亚类、亚亚类和序号。例如,“EC 1.1.1.37”中,第一个“1”表示氧化还原酶大类;第二个“1”表示作用于CH-OH基团;第三个“1”表示以NAD+或NADP+为受体的酶;第四个“37”表示特定酶苹果酸脱氢酶。这种层次结构意味着EC编号蕴含了丰富的功能信息,包括酶催化的反应类型和底物/机制。将EC Number嵌入为向量,有助于我们利用机器学习模型进行功能预测、相似性分析等。
估计阅读时长: 11 分钟在将生物序列(如基因组或蛋白质序列)或文本数据转换为数值向量形式时,TF-IDF(Term Frequency-Inverse Document Frequency)和N-gram One-hot(又称Bag-of-n-grams)是两种经典且基础的文档嵌入算法。它们各自侧重于不同的特征提取方式,常被用于自然语言处理和生物信息学领域。
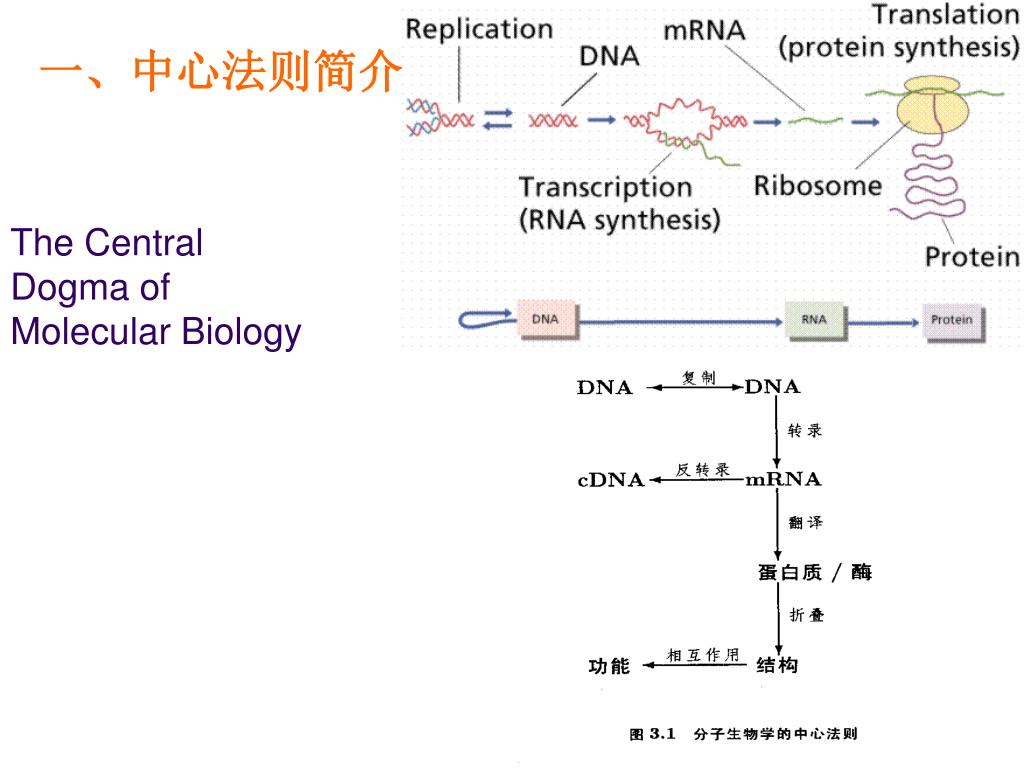
估计阅读时长: 8 分钟原核生物细胞内的中心法则是指遗传信息从DNA经RNA到蛋白质的传递过程,具有高效和经济的特点。DNA复制、转录和翻译均在细胞质中进行,且转录与翻译高度偶联——新生mRNA尚未完全合成,核糖体便已结合并开始翻译,极大提升了蛋白质合成速率。原核生物mRNA常为多顺反子结构,一条mRNA可编码多个功能相关的蛋白质,且无内含子、无需剪接,可直接作为翻译模板。此外,原核mRNA半衰期极短,便于快速响应环境变化。基因表达主要通过操纵子结构在转录水平进行精细调控,如乳糖操纵子和色氨酸操纵子,使原核生物能够灵活适应多变环境。这些机制共同构成了原核生物中心法则的核心,体现了其高度优化的遗传信息传递系统。
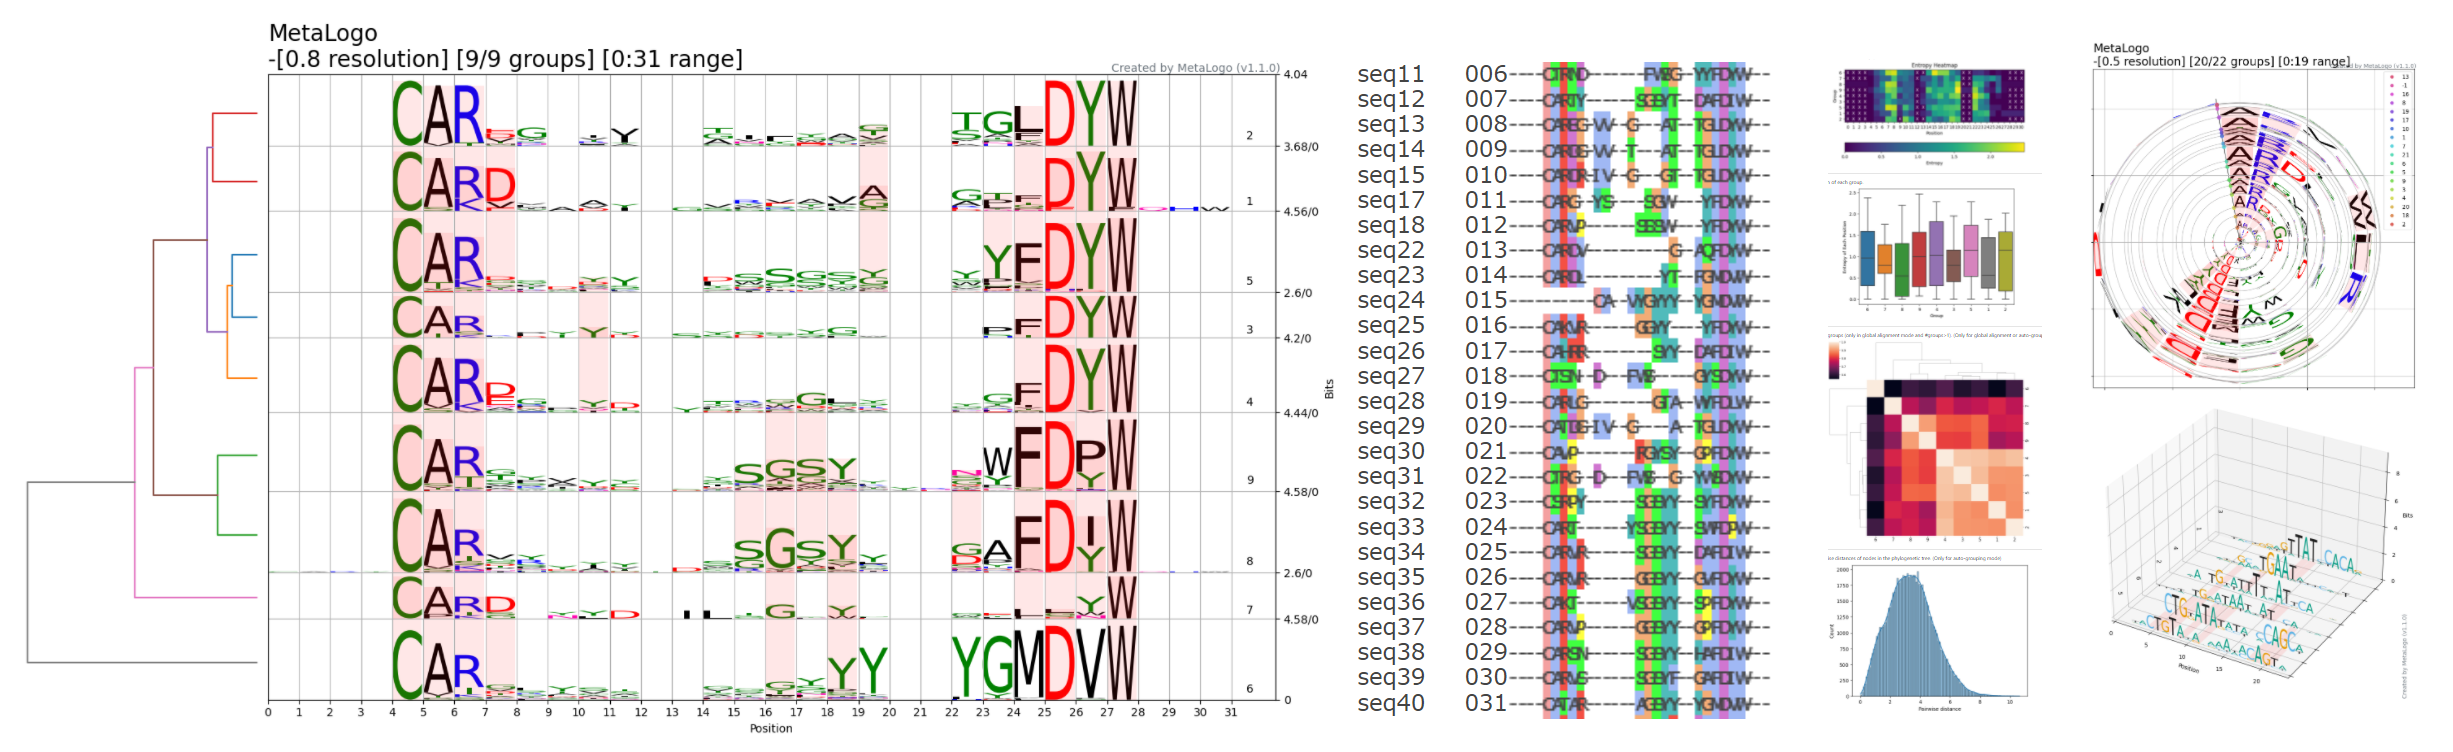
估计阅读时长: 23 分钟Sequence Logo 是一种可视化 DNA 或蛋白质序列保守性的图形表示方法。每个位置(列)上的字母堆叠高度代表该位点的信息含量(以 bits 为单位),而每个字母的高度则与其在该位点出现的频率成正比。高信息量的位置字母堆得高,低信息量的位置则矮甚至接近零。Sequence Logo的绘制遵循信息熵原理,我们可以很直观的通过某一个位置的总高低来了解该处位置的信息含量有多少,高信息量的位置,字母堆的高,一般会出现某一个字符特别高,表明该处非常保守。 位置权重矩阵(Position Weight Matrix, PWM)是描述基因组调控因子结合位点序列模式的核心模型。它通过统计在结合位点序列中每个位置上各核苷酸(或氨基酸)出现的频率,来量化该位置对不同碱基的偏好程度。PWM通常以矩阵形式表示,行对应核苷酸(A、C、G、T/U),列对应序列中的位置,矩阵元素即为该位置该核苷酸相对于背景的权重得分。这一模型简洁且易于计算,因此在转录因子结合位点(TFBS)等调控元件的识别和表征中被广泛采用。
估计阅读时长: 5 分钟将复杂的生物学过程拆解为单元化学反应,是进行定量模拟的基石。转录是基因表达调控的关键环节,决定了细胞在特定时间、特定环境下合成哪些蛋白质,对生命活动至关重要。最近的工作中需要将原本非常粗糙的虚拟细胞转录事件模型拆解为更加细分化的多步骤生物化学过程,以适应针对细胞群落生长的建模计算。下面为我将原核生物的转录过程拆解为一系列可以用化学式表示的单元步骤的结果。 在介绍这些分步骤之前,我们会需要首先来定义一下模型中会用到的各种“化学物质”(分子和复合物): RNAP: RNA聚合酶全酶(包含核心酶和σ因子)。 DNA: 基因组DNA双链。 DNA_P: 包含启动子区域的DNA。 DNA_T: 包含终止子区域的DNA。 NTP: 核糖核苷三磷酸(ATP, UTP, GTP, CTP的统称)。 PPi: […]

估计阅读时长: 30 分钟零分布(null distribution)是指在假设零假设(null hypothesis)成立的情况下,某个统计量随机取值的概率分布。在统计假设检验中,我们通常提出一个零假设(例如“两组数据没有显著差异”或“观察到的模式仅由随机因素造成”),然后根据观测数据计算一个检验统计量。零分布描述了这个统计量在零假设为真时的分布情况。通过将实际观测到的统计量与零分布进行比较,我们可以计算出P-value:即在零假设下,出现等于或更极端观测结果的概率。如果P-value很小(例如低于预设的显著性水平α),我们就认为零假设不太可能成立,从而拒绝零假设,认为观测结果是统计显著的。

代谢组学那堆名词我上次查资料时也手抄过一页,QC 样本、保留时间、m/z 这些混在一张表里,来回对照着看特别费劲。你这篇把英文缩写和中文解释排在一起,省了我不少翻文献的功夫,尤其是代谢物鉴定那几段。
文中提出的"能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢?"让我想到一个需要先厘清的问题:把Family层级的分类当作细胞分群标签时,功能相似性与亲缘关系可能会混在一起,图上的聚集未必能直接解释为代谢功能接近。如果借用单细胞分析中的降维流程,是否可以同时标注物种分类和基因组注释完整度,看看分离主要对应哪一种差异?尤其是这里用的是EC注释的TF-IDF矩阵,缺少某项注释究竟代表功能缺失还是未被识别,也可能影响对分群结果的判断。
这个角度之前没想到,零分布原理及其在生物信息学中的应用 确实值得深入了解。刚好之前看过,可以对照着看看。
Greetings! I stumbled upon this really useful site and figured I'd thanks for you post at here.
This content speaks to hearts