
估计阅读时长: 5 分钟https://github.com/xieguigang/scale_colour_genshin 在用R绘图时,颜色设置是美化过程中不可缺少的一步。在实际绘图时,一般不会一一手动寻找合适的颜色,而是通过一些R包、网站提供好的,美观的颜色组合,即调色板(palette),可供使用。在这里介绍一种通过提取图片主题色的方法来为我们自动生成画图所用的颜色板数据。 AttachmentsSort by:DefaultDateName 383807b4 • 132 KB • 1144 click 08.04.2023faruzan • 558 KB • […]
估计阅读时长: 8 分钟https://github.com/rsharp-lang/NRRD NRRD(Nearly Raw Raster Data)是一种用于存储类似于热图成像数据的文件格式。其实我们可以将NRRD看作为类似于bitmap之类的未压缩的原始光栅图像文件。只要我们有对应的解码方式,我们就可以像查看普通图片文件一样查看NRRD文件。 AttachmentsSort by:DefaultDateName raster__238 • 60 KB • 1160 click 10.03.2023nrrd_text • […]
估计阅读时长: 5 分钟在BILIBILI上观看视频:《【BioNovoGene Mzkit教程】代谢组学原始数据处理基础》 最近我在B站的视频页面下发现了这样的一条评论,面对质谱数据分析领域内的初学者的求教,其实自己也是非常的诚惶诚恐的。因为在视频中所使用的脚本语言是自己开发的一门新语言,所以可能给一些初学者造成了一部分的困扰哈哈😅😄😅😅。首先先对这个粉丝说一声抱歉哈。 针对上述的提问,我的回答大概是有以下的几点: AttachmentsSort by:DefaultDateName question_20230223 • 16 KB • 988 click 24.02.2023open_Rdevtool • 162 […]
估计阅读时长: 5 分钟在工作之中可能会遇到需要进行两个网络图对象之间的相似度计算的情形:例如在质谱数据分析的化学信息学计算工作之中,我们在解析SMILES字符串得到分子图之后,可以基于图相似度比较计算方法来比较计算两个代谢物分子图之间的结构上的相似度。 Attachments pone.0078360.g003 • 2 MB • 1149 click 06.08.2022https://journals.plos.org/plosone/article?id=10.1371/journal.pone.0078360
估计阅读时长: 4 分钟在代谢组学领域内,LCMS原始数据分析一般分为非靶向全扫原始数据,以及仅针对某些离子进行扫描的MRM靶向质谱数据。虽然二者都是基于LCMS方法进行实验,但是MRM靶向数据由于在事先已经通过实验确定,得到了Q1和Q3离子对信息,所以可以仅针对某一些特定代谢物进行检测。因为MRM数据是针对于某些代谢物检测的靶向数据,所以其XIC谱图在没有同分异构体存在的情况下,一般是很纯净的目标化合物的检测结果数据。所以在原始数据分离,定量计算方面都要比非靶向全扫结果数据要容易很多。 AttachmentsSort by:DefaultDateName xcms-logo-white • 182 KB • 1059 click 01.07.2022lcmspreproc_slides_1.2 • 136 KB • 1046 […]
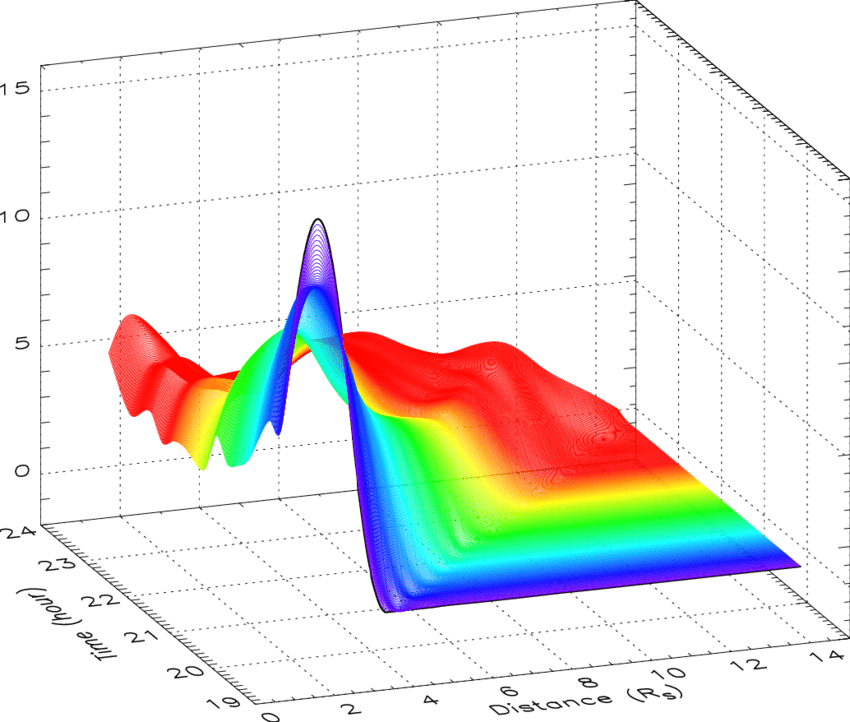
估计阅读时长: 7 分钟热图(Heat Map)是在二维空间中以颜色的形式显示一个现象的绝对量一种数据可视化技术。颜色的变化可能是通过色调或强度,给读者提供明显的视觉提示,说明现象是如何在空间上聚集或变化的。热图有两种完全不同的类别:聚集热图和空间热图。 在聚集热图中,幅度被排列成一个固定单元格大小的矩阵,其行和列是离散的现象和类别,行和列的排序是有意的,而且有些随意,目的是暗示聚集或描绘出通过统计分析发现的聚集。单元格的大小是任意的,但足够大,可以清晰可见。 相比之下,空间热图中某一量级的位置是由该量级在该空间中的位置所决定的,没有单元的概念,现象被认为是连续变化的。 AttachmentsSort by:DefaultDateName 2D-cubic-spline-interpolation-of-mass-profiles-from-1939-to-2354-UT-and-between-16 • 111 KB • 1265 click 14.06.2022eORLu • 636 […]
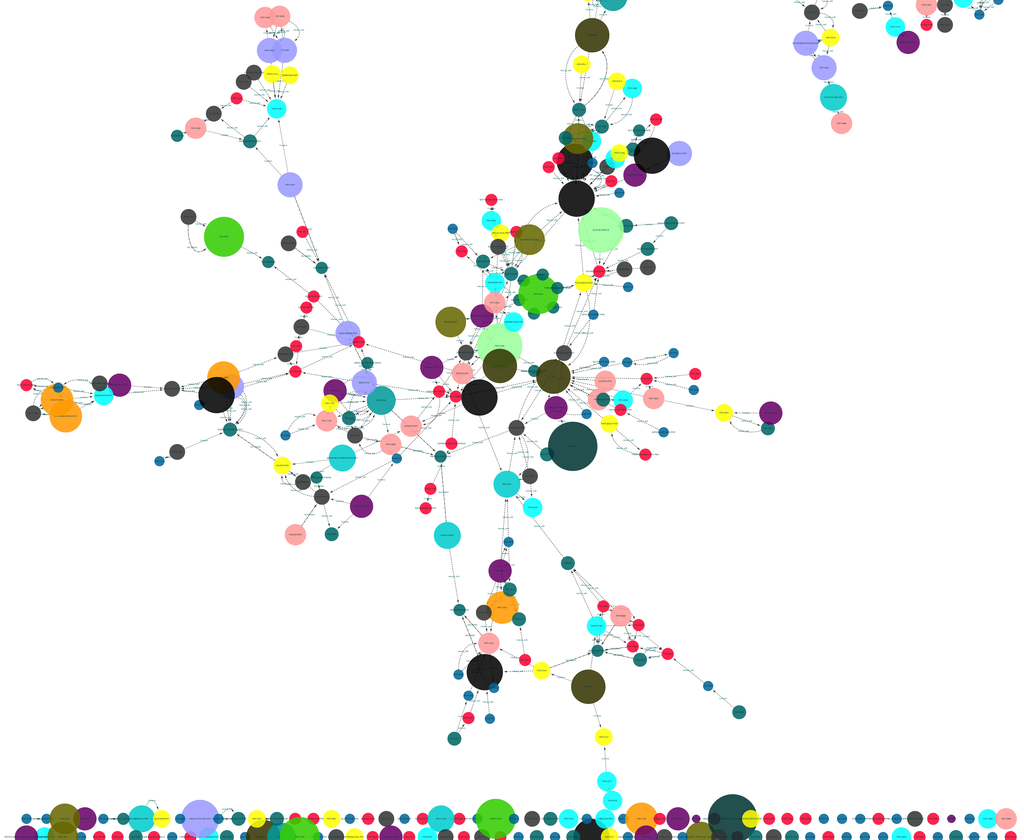
估计阅读时长: 7 分钟一般而言,进行全基因组的转录表达调控网络的建立,我们需要基于两个数据结果来完成: 目标基因的转录调控位点信息(Motif搜索结果,构成网络之中的节点) 转录调控位点相应的转录调控因子(Motif位点相关的转录调控因子,构成网络之中的边连接) AttachmentsSort by:DefaultDateName Xor • 271 KB • 1126 click 11.06.2022An integrated multi-omics approach […]
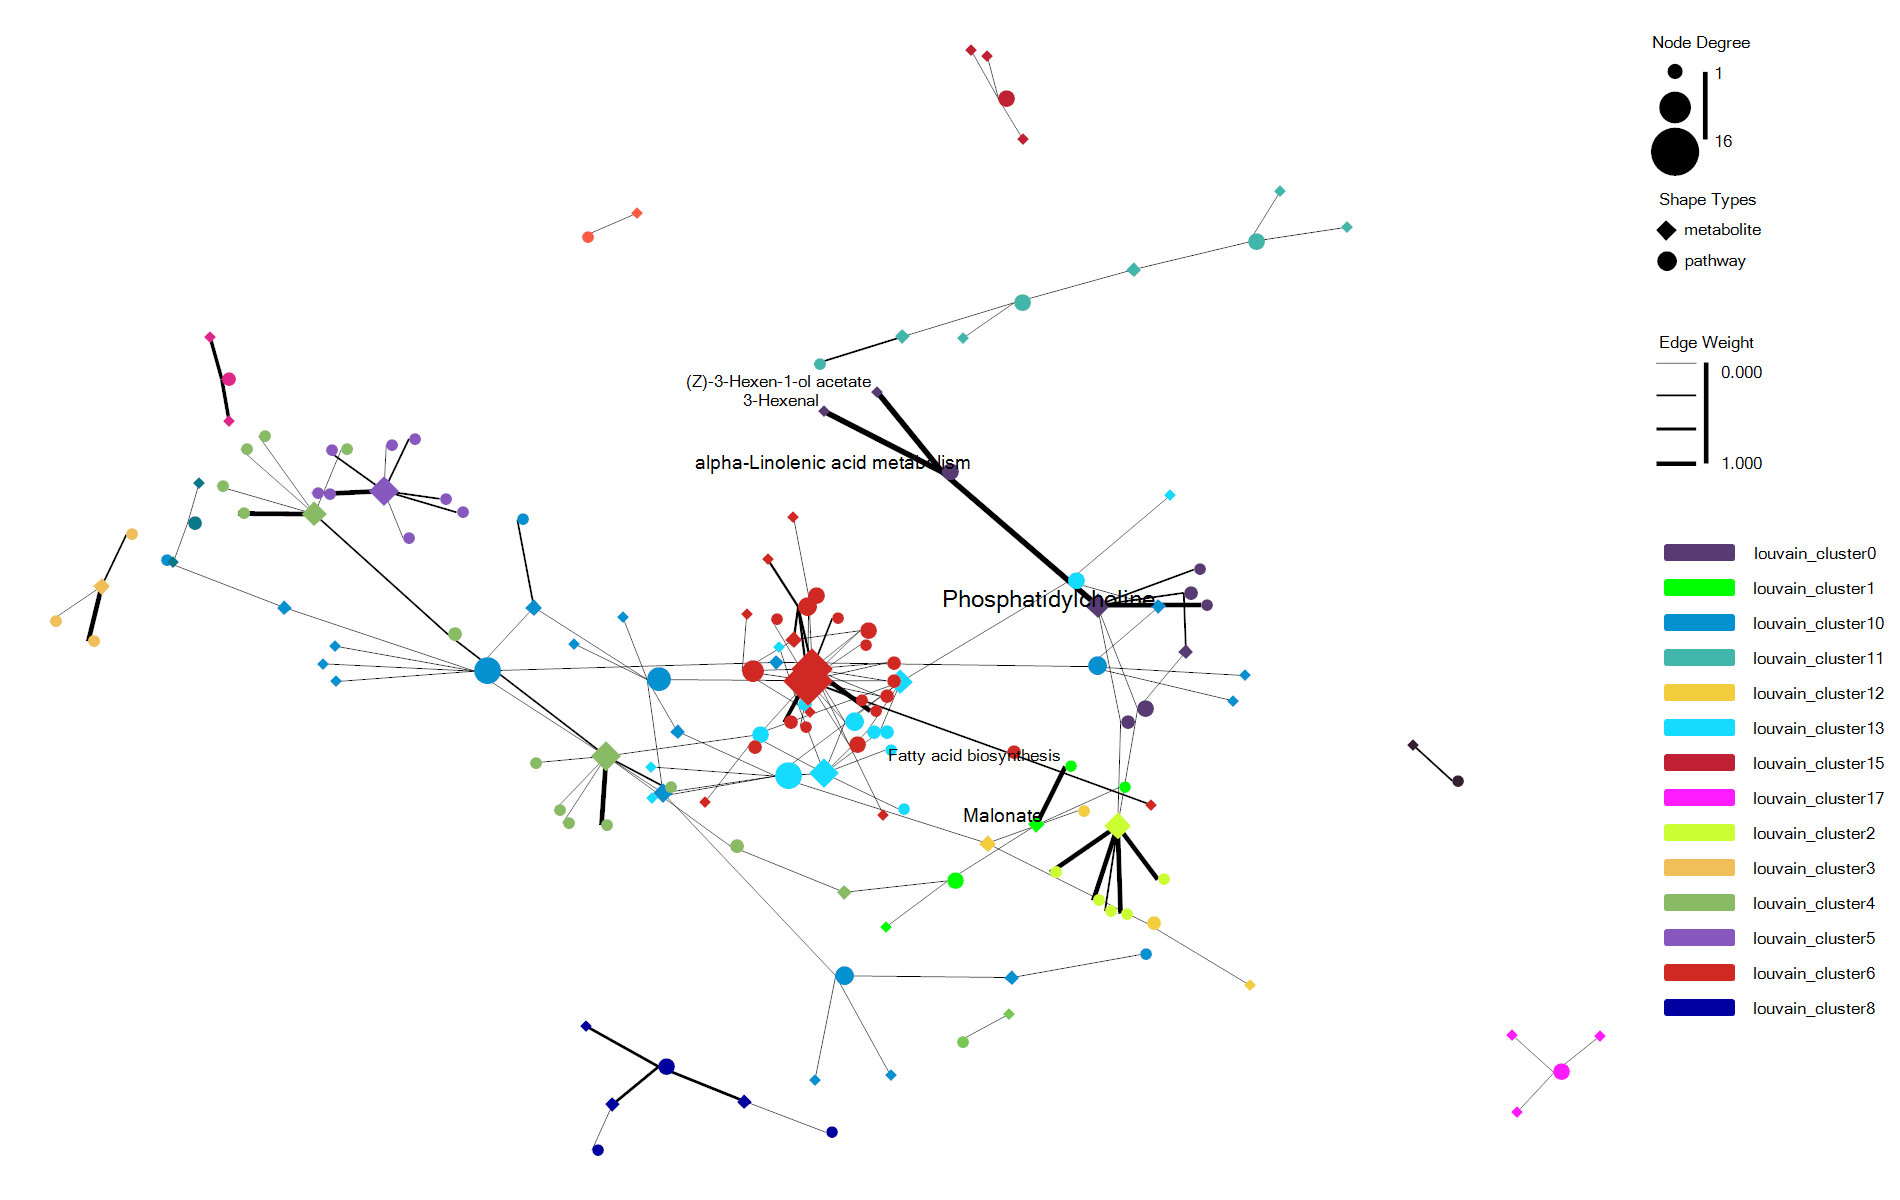
估计阅读时长: 7 分钟https://github.com/rsharp-lang/ggplot 在进行复杂关系的数据集进行可视化的时候,通过网络图的方式进行数据可视化可以让我们非常直观的借助于网络节点的聚集程度之类的布局信息了解到我们的复杂数据的关系结构信息。最近将R#语言之中的ggplot包进行网络可视化的代码库进行了一些更新。基于此功能更新工作,目前在ggplot程序包之中成功集成了ggraph程序包类似的网络可视化功能。在这里做了一些总结分享给大家。 AttachmentsSort by:DefaultDateName enrichNetwork_ggraph • 70 KB • 1076 click 01.06.2022enrichNetwork_ggraph2 • 104 KB • […]
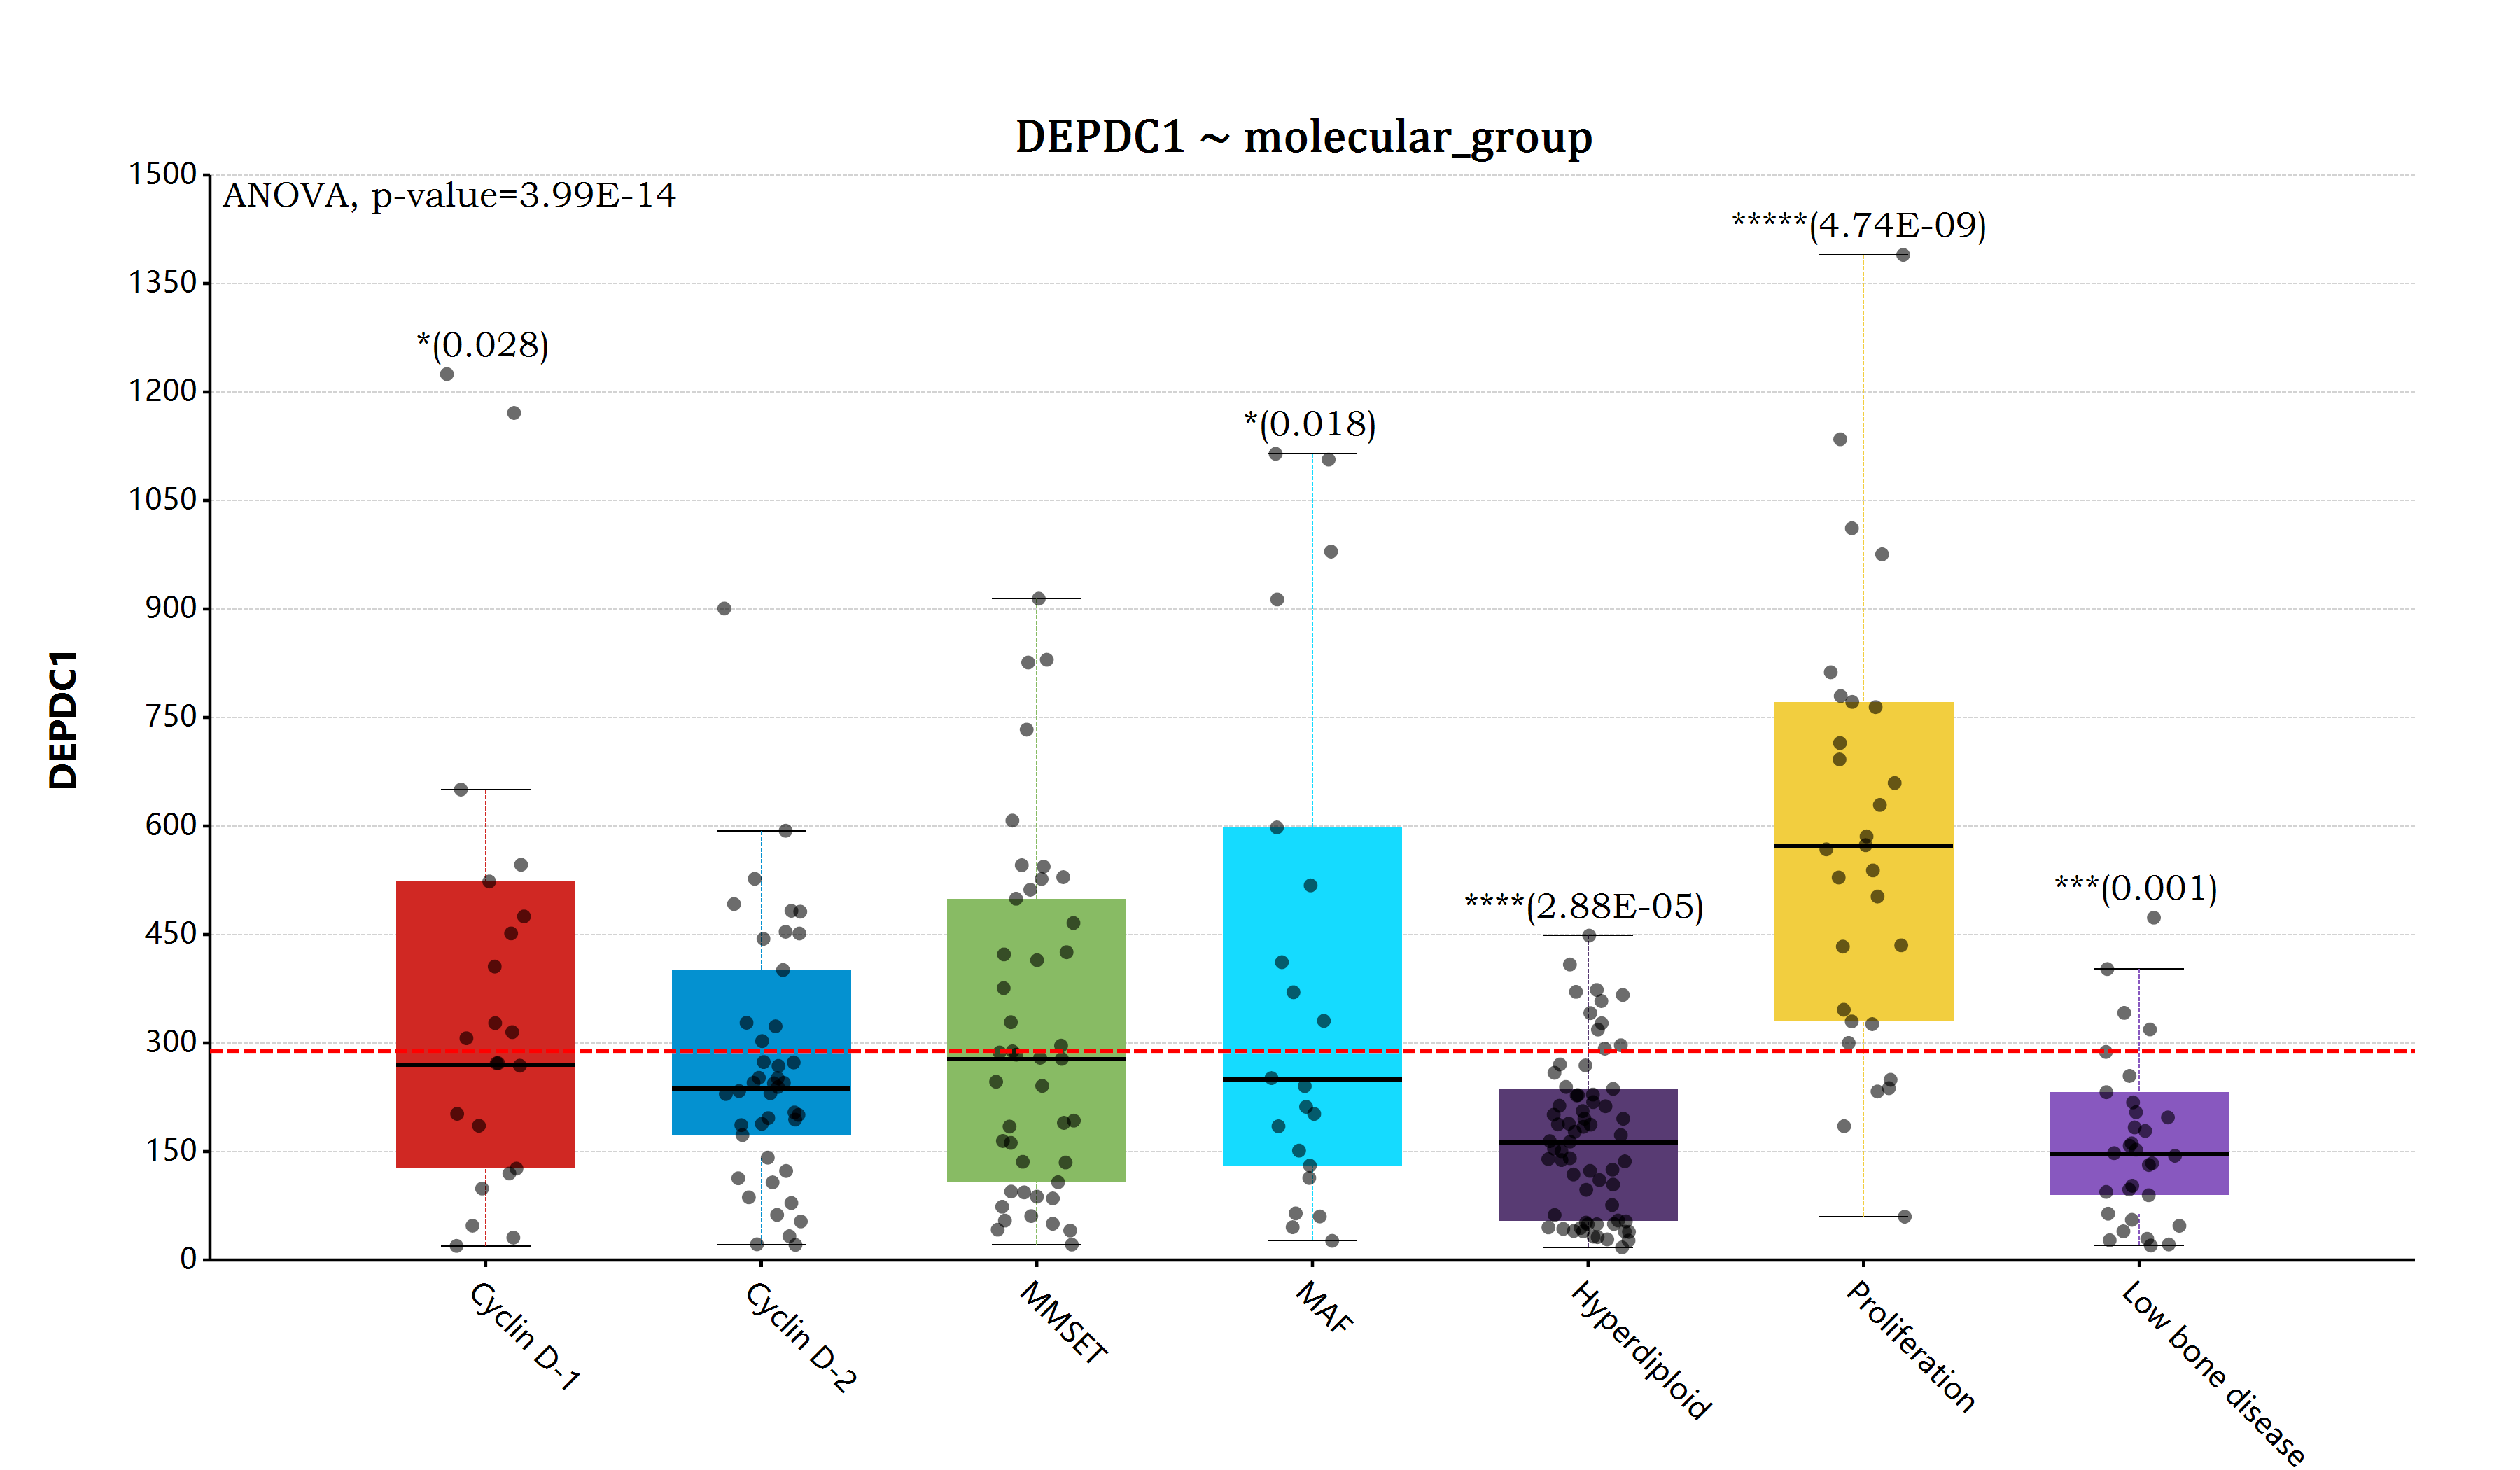
估计阅读时长: 14 分钟https://github.com/rsharp-lang/ggplot 在完成了前面所提到的ANOVA检验模块的代码开发编写工作之后,之前一直悬在我心里面的完善R#语言的ggplot统计作图功能的愿望现在终于实现了。在R#语言之中通过使用ggplot代码库进行相应的数据统计分析作图,目前已经变得和R语言之中的ggplot2程序包那样同样的简单和漂亮。 AttachmentsSort by:DefaultDateName myeloma_bar • 195 KB • 1214 click 29.05.2022myeloma_box • 203 KB • […]
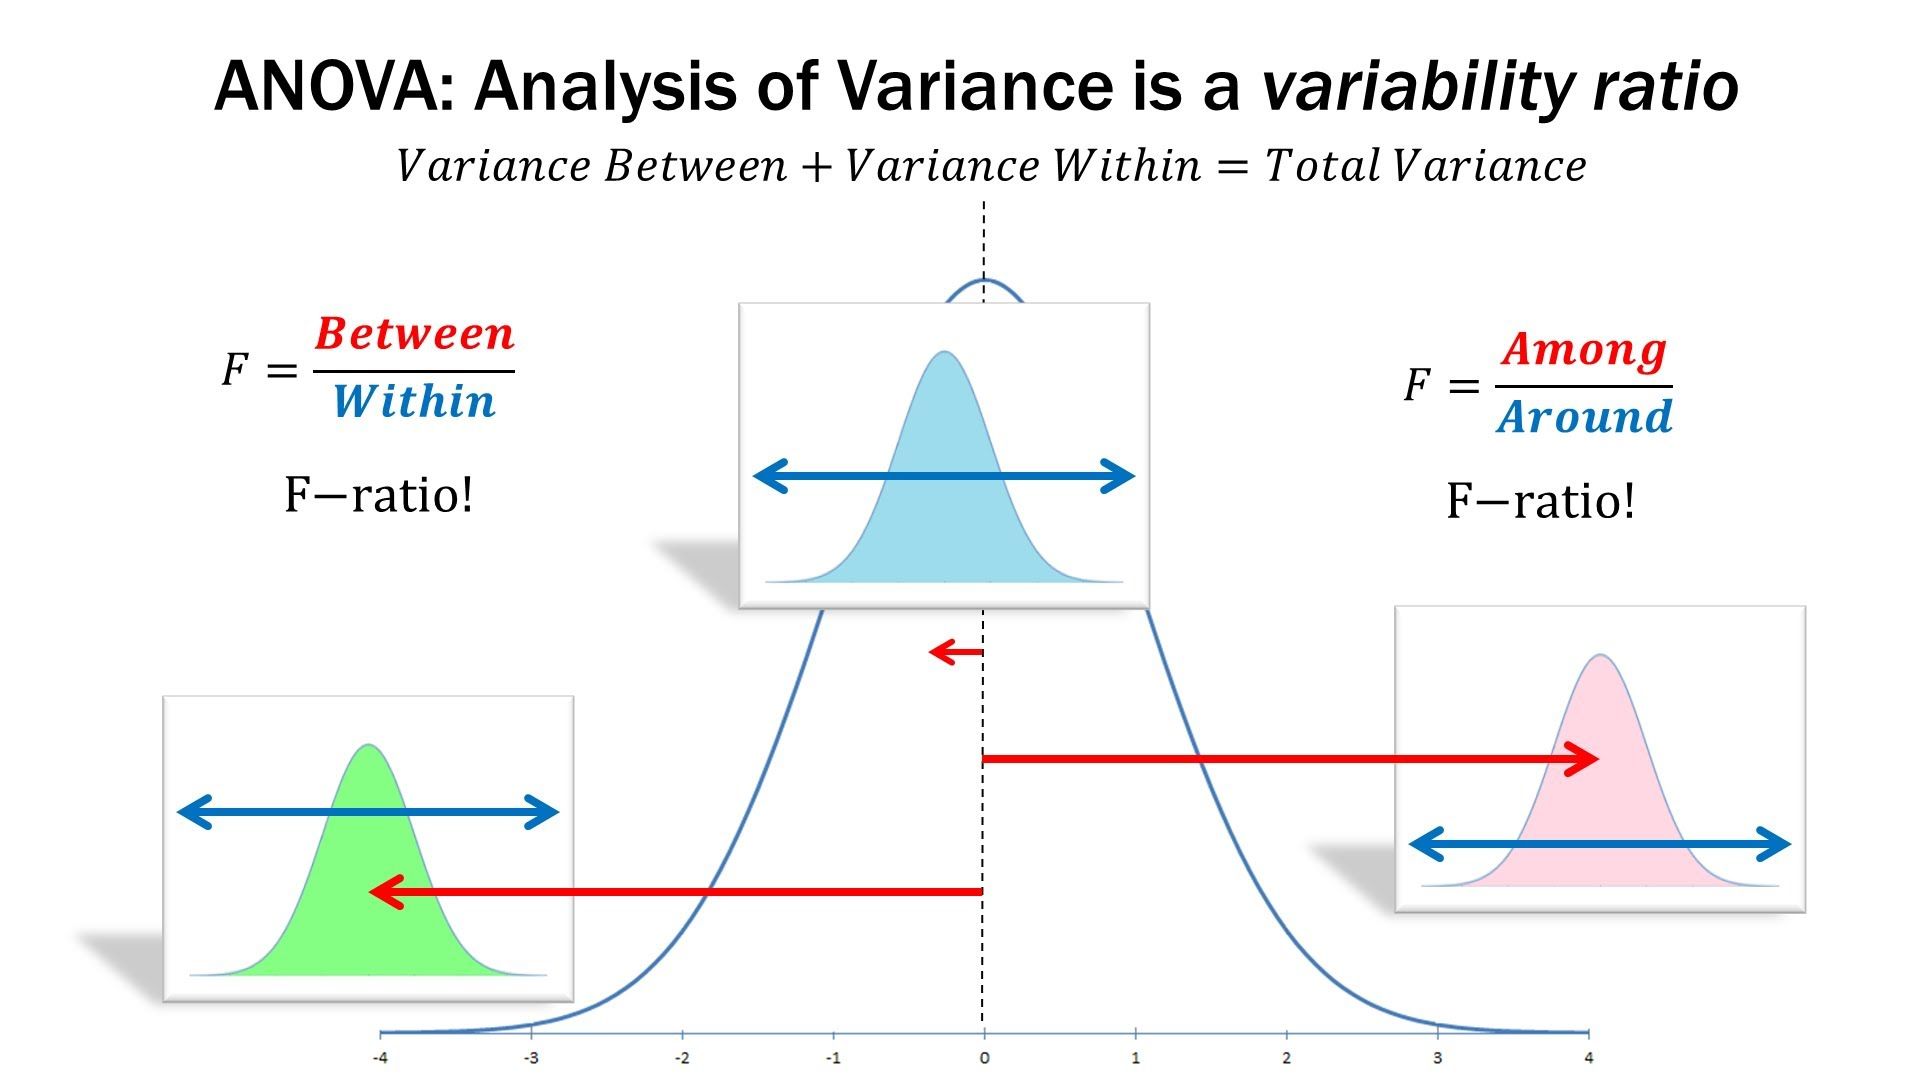
估计阅读时长: 14 分钟一般而言,如果我们在进行组学数据分析的时候,如果想要比较两组数据之间是否存在有差异性,一般是对两两比较的两组数据进行T-检验。但是在代谢组学数据分析领域内,则很多的组学数据分析情况为比较两组以上的数据,寻找差异的biomarker。那这个时候就需要使用上ANOVA统计检验方法了。 AttachmentsSort by:DefaultDateName anova • 104 KB • 1391 click 28.05.2022ANOVA-screen • 27 KB • 1167 […]

This content speaks to hearts
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 对于基于ec number来生成层级数据,我们直接使用《酶EC编号结构解析》文章末尾所展示的层级数据生成函数来实现。 […]
[…] 在前面的一篇《基因组功能注释(EC Number)的向量化嵌入》博客文章中,针对所注释得到的微生物基因组代谢信息,进行基于TF-IDF的向量化嵌入之后。为了可视化向量化嵌入的效果,通过UMAP进行降维,然后基于降维的结果进行散点图可视化。通过散点图可视化可以发现向量化的嵌入结果可以比较好的将不同物种分类来源的微生物基因组区分开来。 […]