
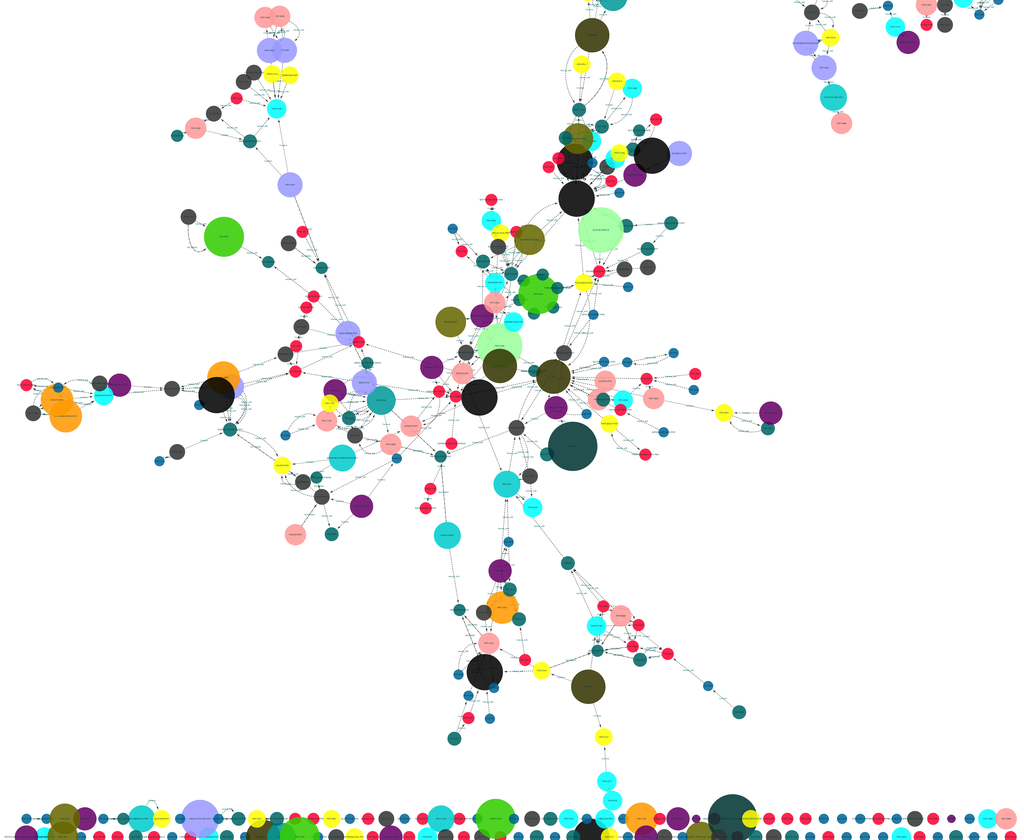
估计阅读时长: 7 分钟一般而言,进行全基因组的转录表达调控网络的建立,我们需要基于两个数据结果来完成: 目标基因的转录调控位点信息(Motif搜索结果,构成网络之中的节点) 转录调控位点相应的转录调控因子(Motif位点相关的转录调控因子,构成网络之中的边连接)
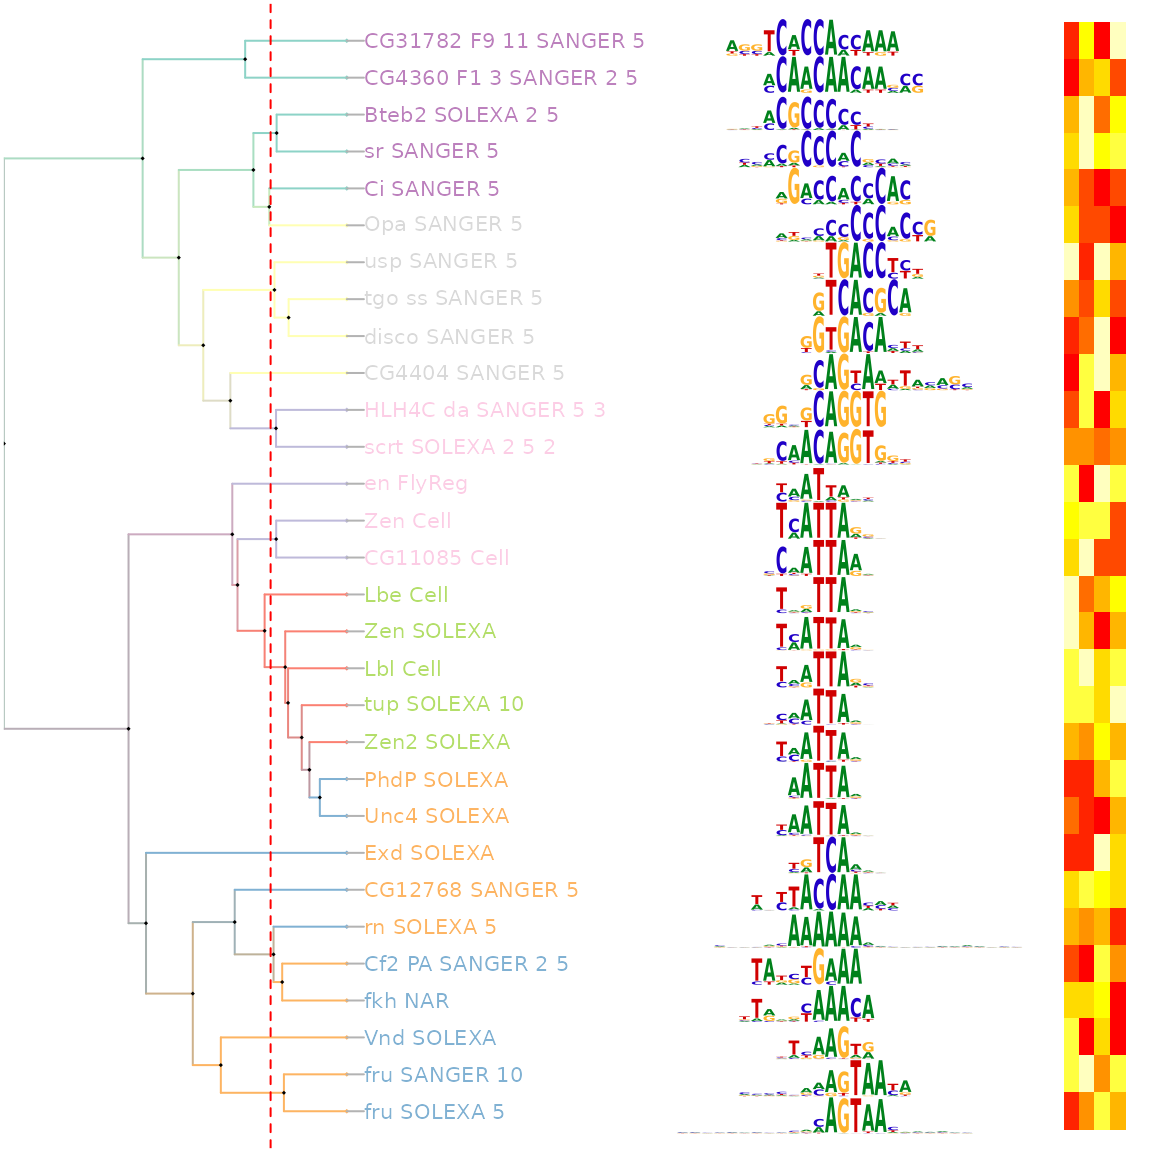
估计阅读时长: 12 分钟Motif是一段典型的序列或者一个结构。一般情况下是指构成任何一种特征序列的基本结构。通俗来讲,即是有特征的短序列,一般认为它是拥有生物学功能的保守序列,可能包含特异性的结合位点,或者是涉及某一个特定生物学过程的有共性的序列区段。比如蛋白质的序列特异性结合位点,如核酸酶和转录因子。
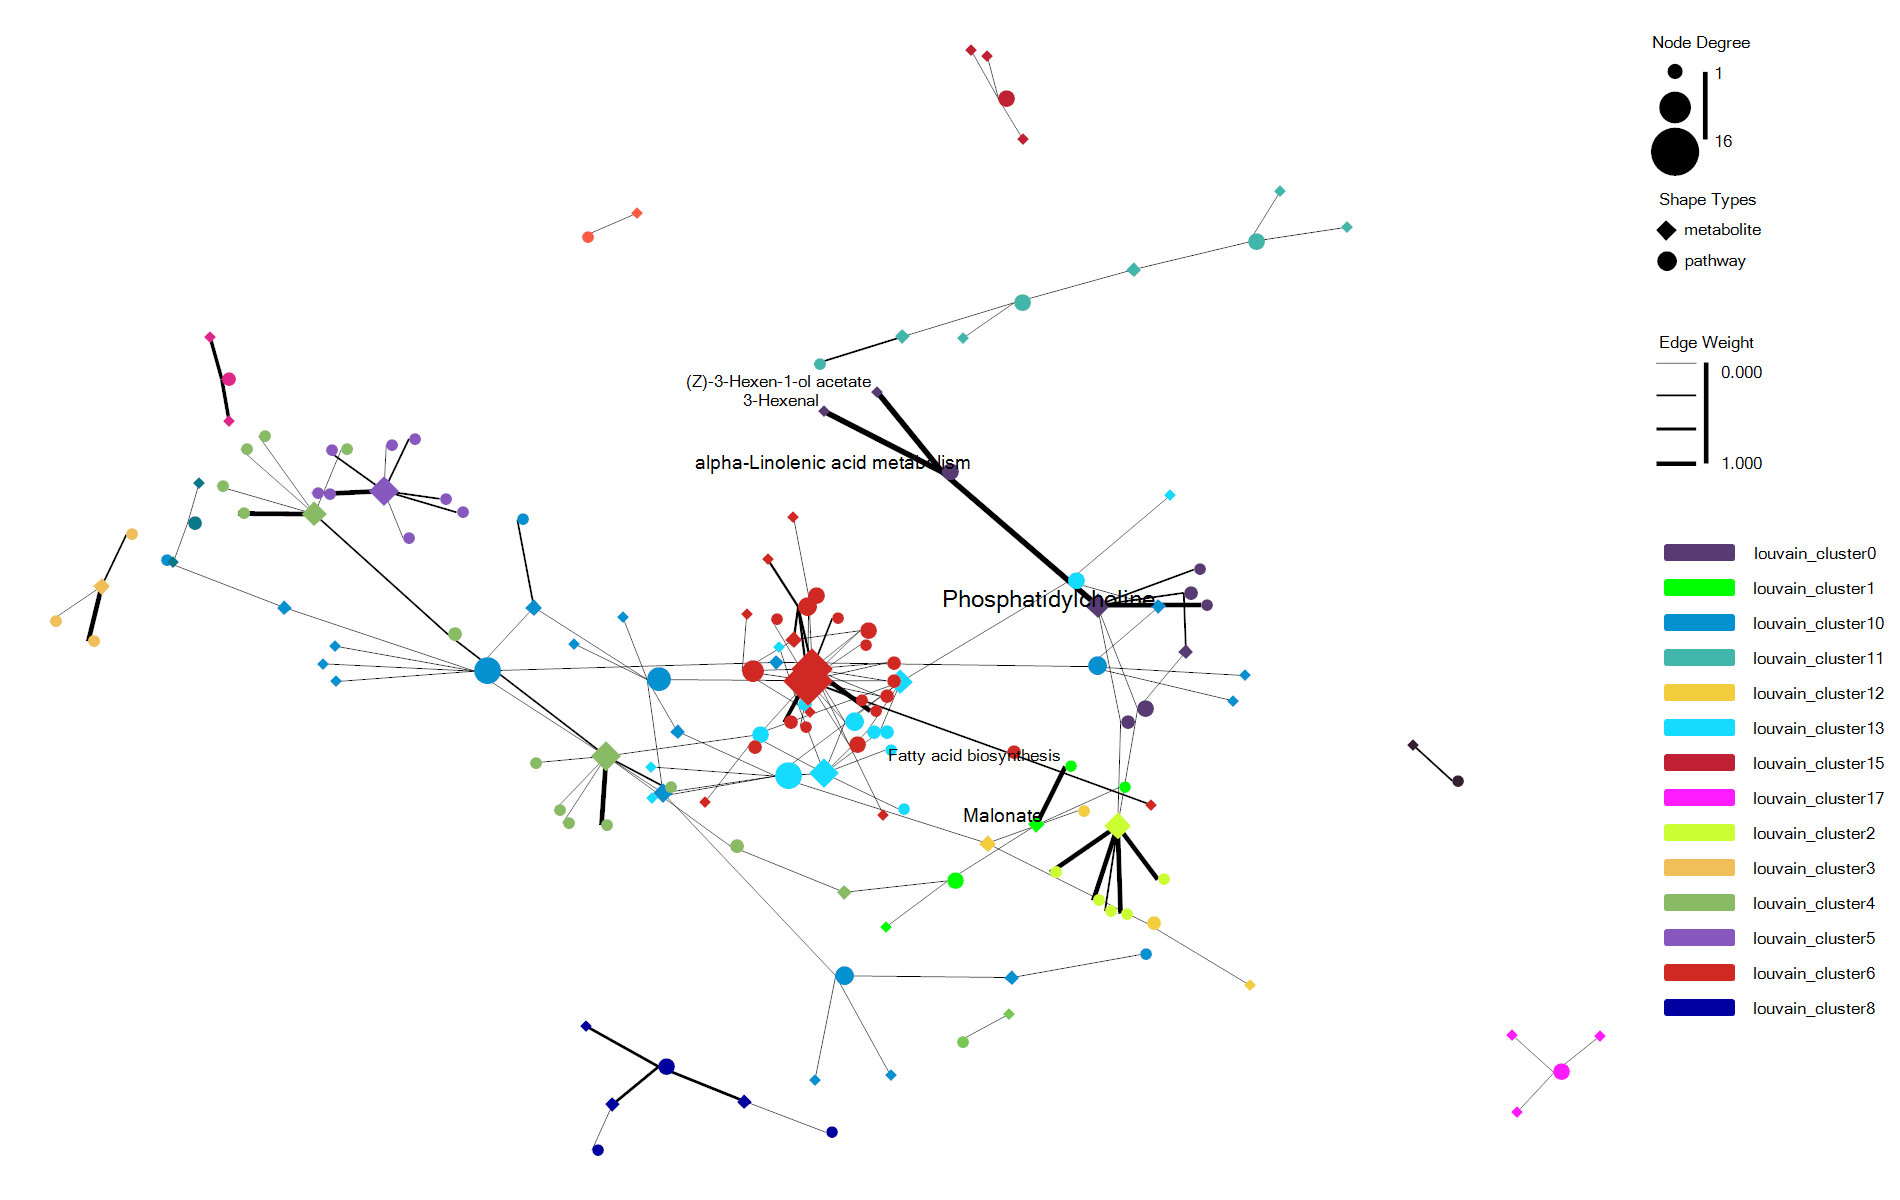
估计阅读时长: 7 分钟https://github.com/rsharp-lang/ggplot 在进行复杂关系的数据集进行可视化的时候,通过网络图的方式进行数据可视化可以让我们非常直观的借助于网络节点的聚集程度之类的布局信息了解到我们的复杂数据的关系结构信息。最近将R#语言之中的ggplot包进行网络可视化的代码库进行了一些更新。基于此功能更新工作,目前在ggplot程序包之中成功集成了ggraph程序包类似的网络可视化功能。在这里做了一些总结分享给大家。
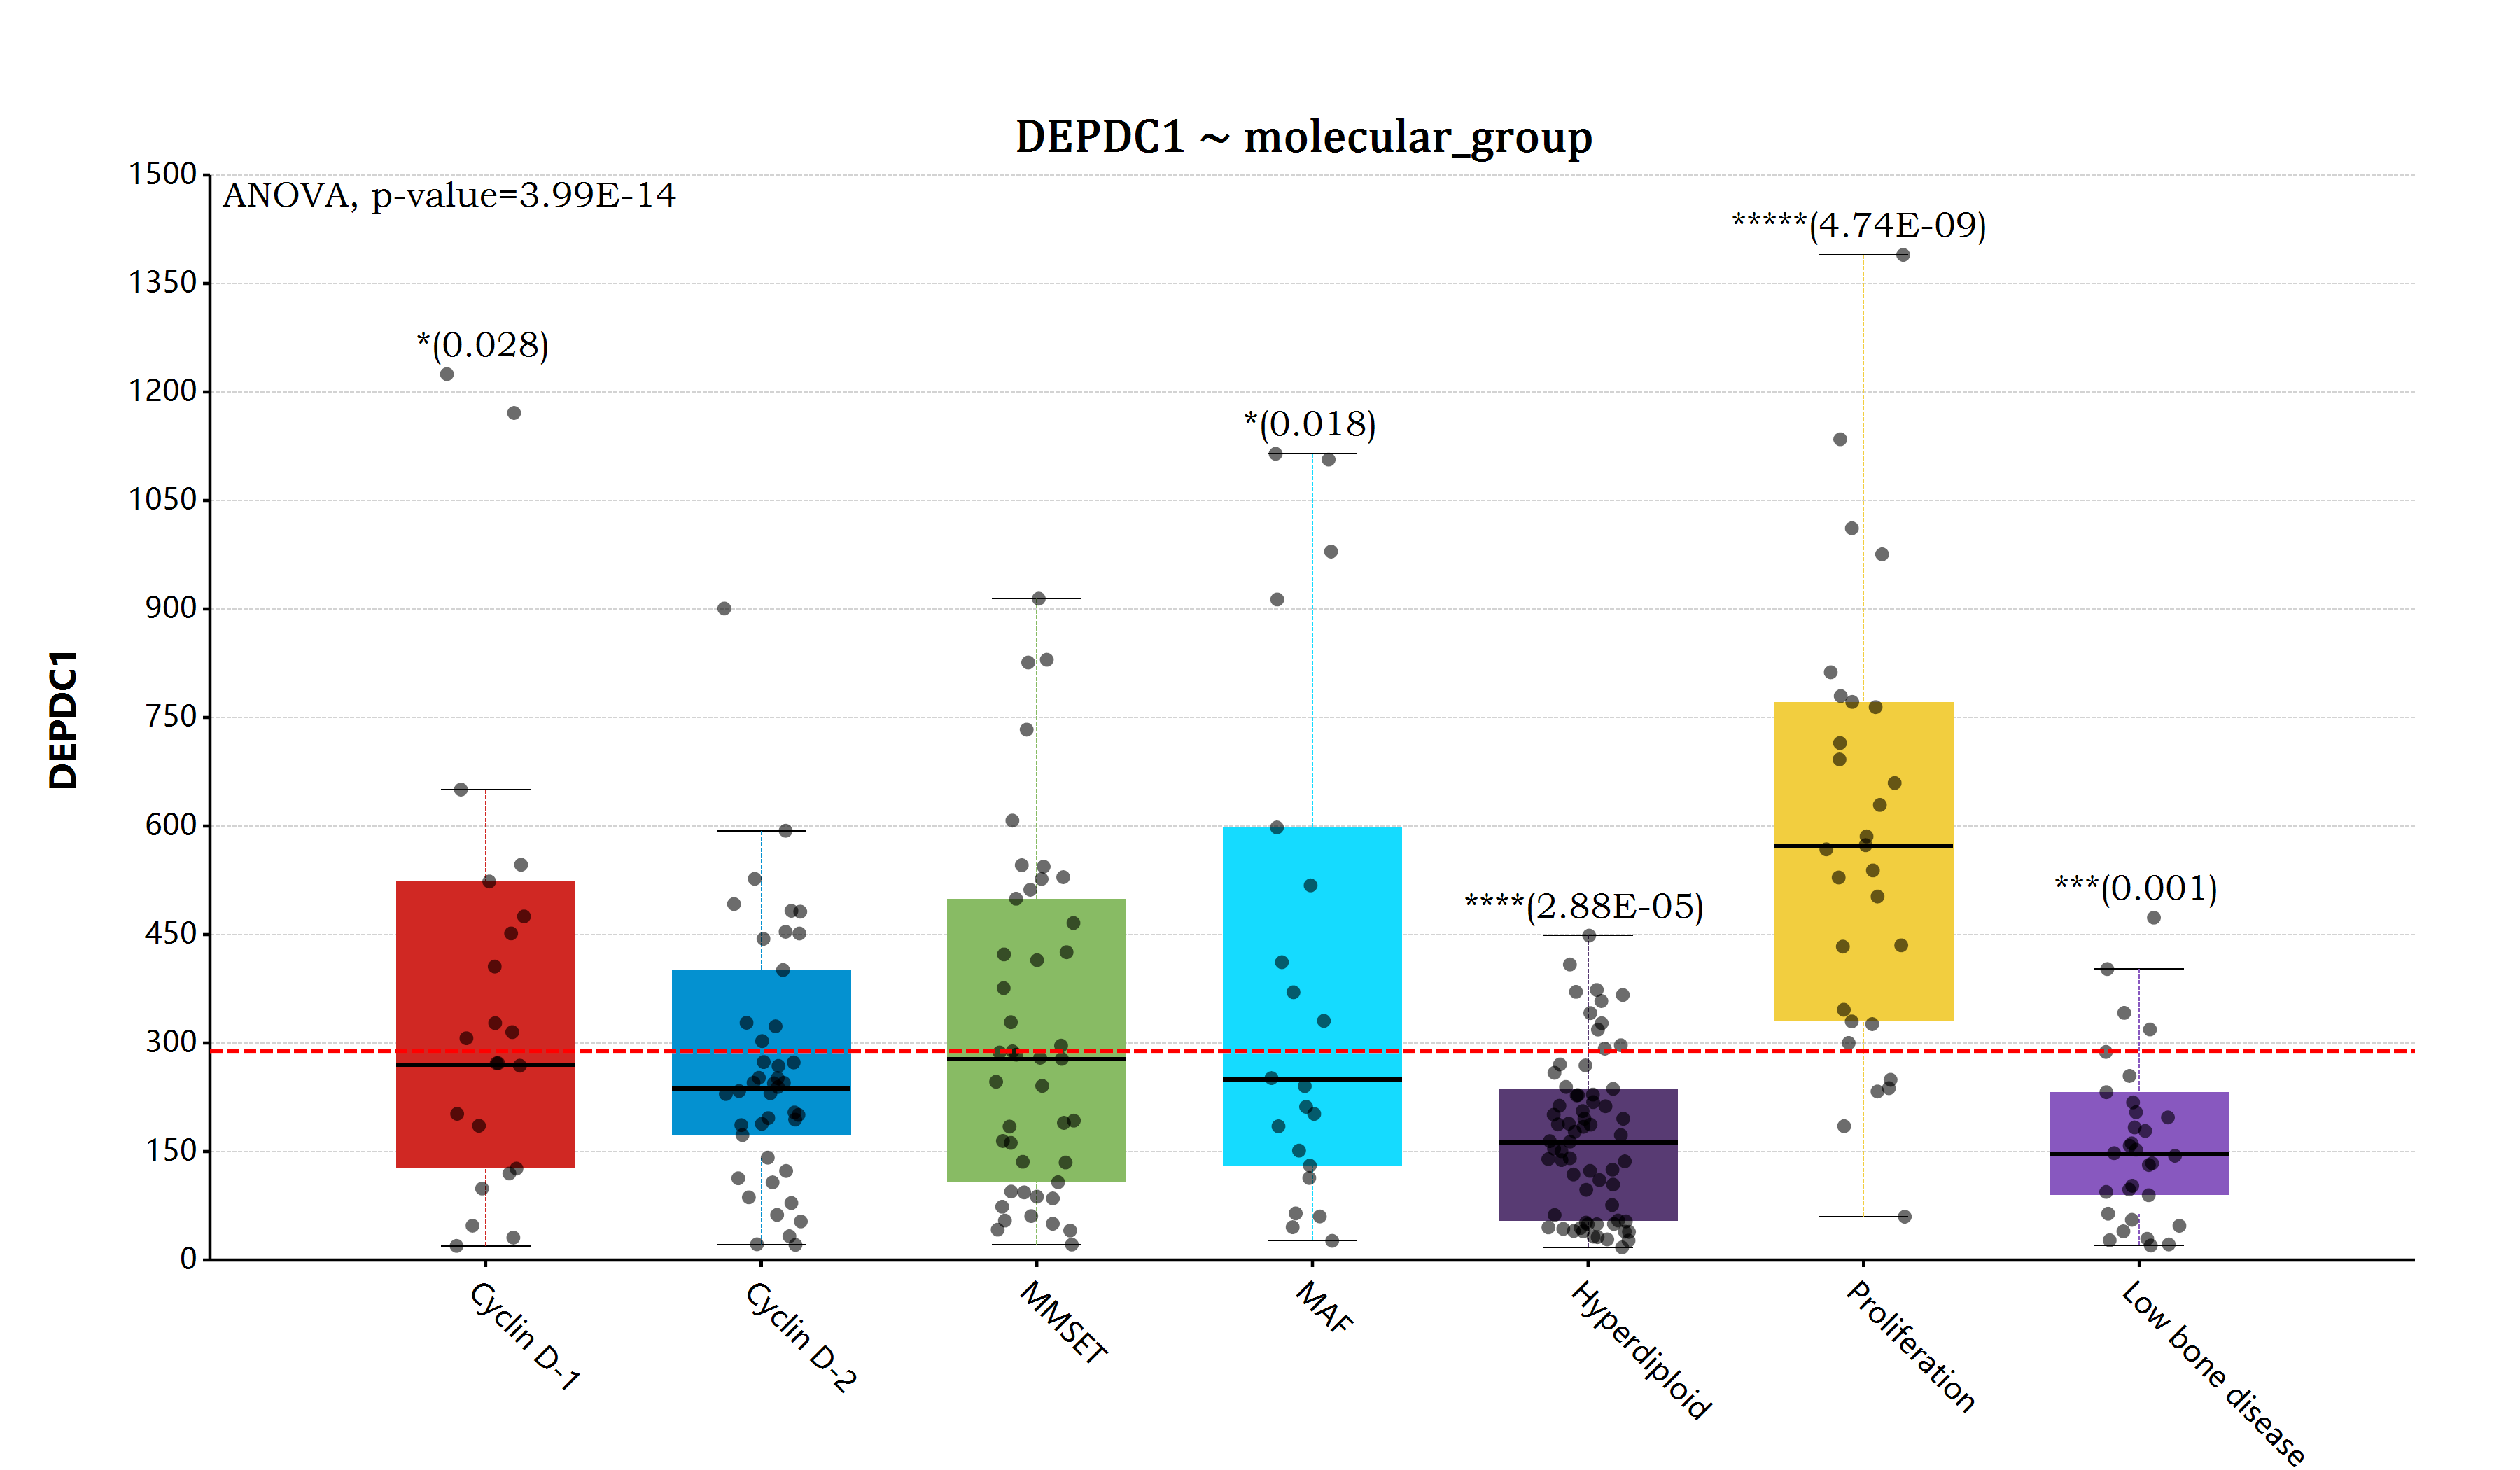
估计阅读时长: 14 分钟https://github.com/rsharp-lang/ggplot 在完成了前面所提到的ANOVA检验模块的代码开发编写工作之后,之前一直悬在我心里面的完善R#语言的ggplot统计作图功能的愿望现在终于实现了。在R#语言之中通过使用ggplot代码库进行相应的数据统计分析作图,目前已经变得和R语言之中的ggplot2程序包那样同样的简单和漂亮。
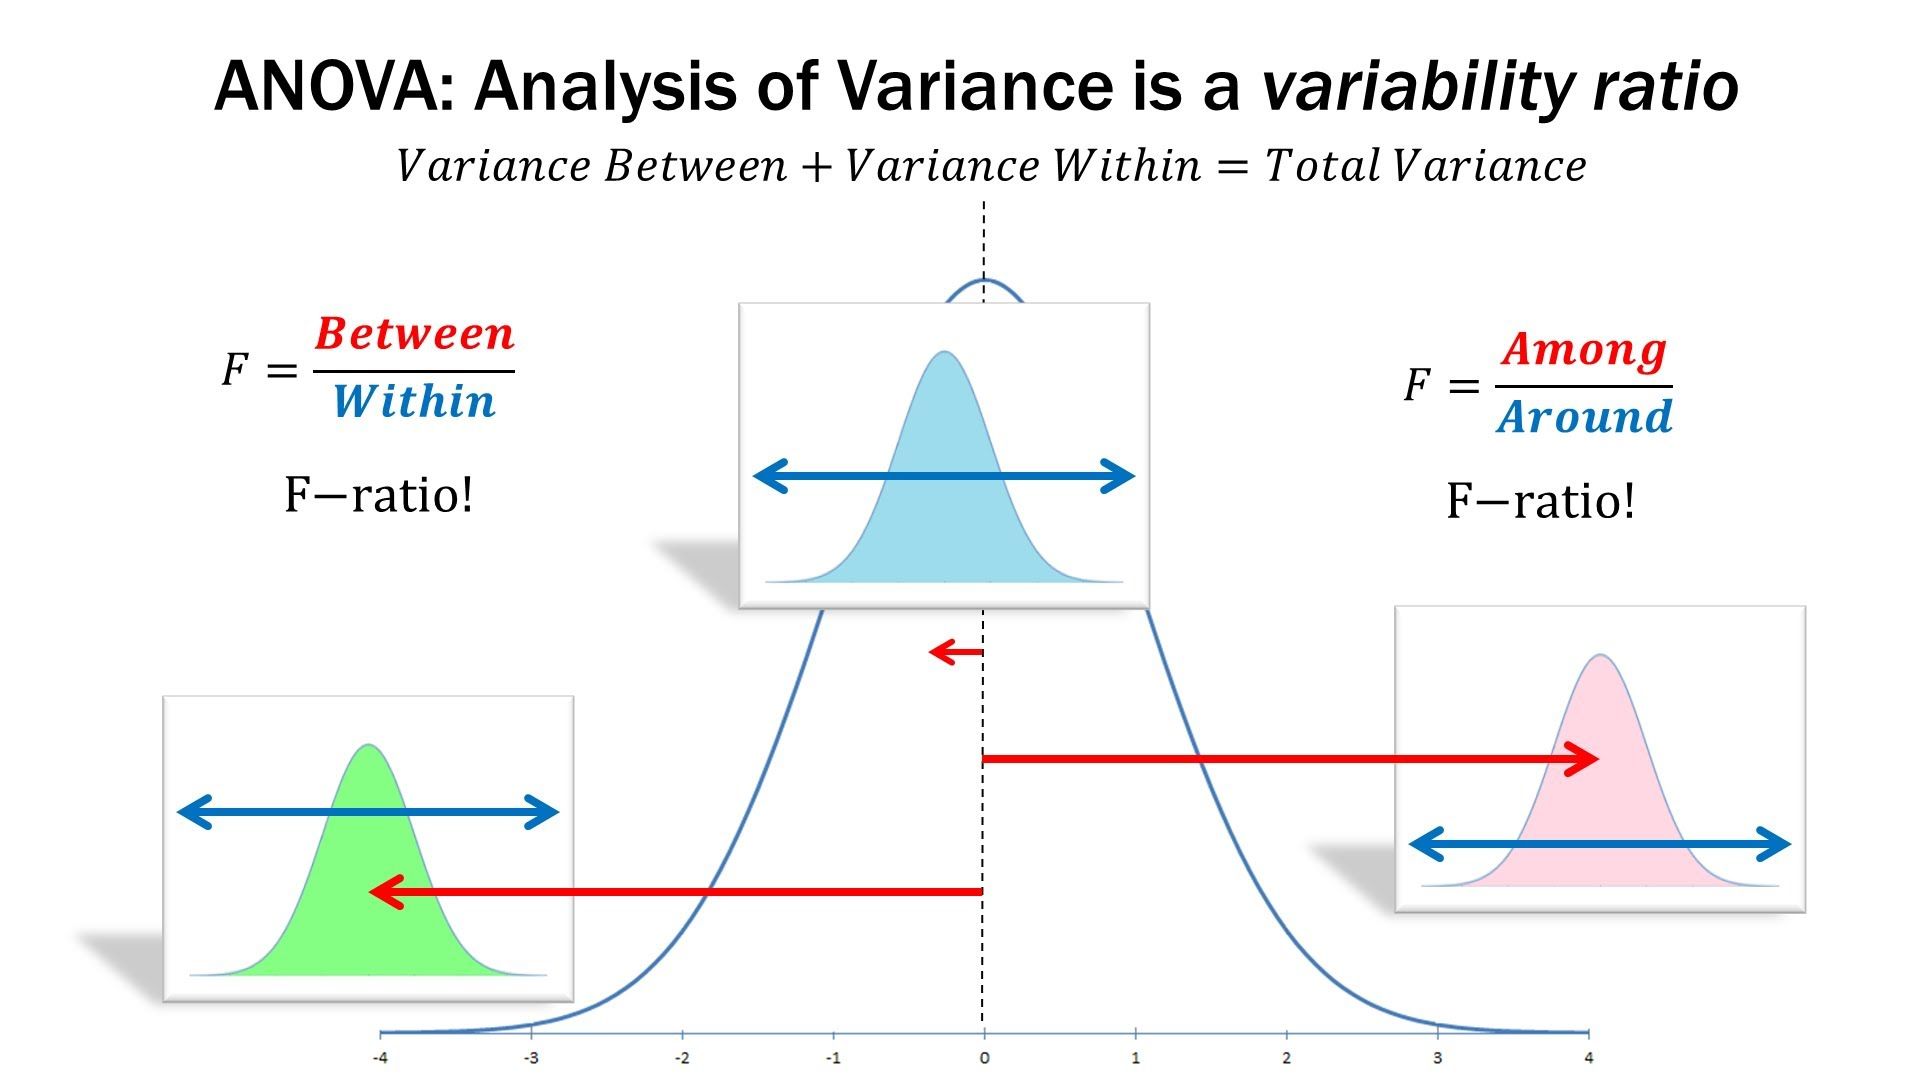
估计阅读时长: 14 分钟一般而言,如果我们在进行组学数据分析的时候,如果想要比较两组数据之间是否存在有差异性,一般是对两两比较的两组数据进行T-检验。但是在代谢组学数据分析领域内,则很多的组学数据分析情况为比较两组以上的数据,寻找差异的biomarker。那这个时候就需要使用上ANOVA统计检验方法了。
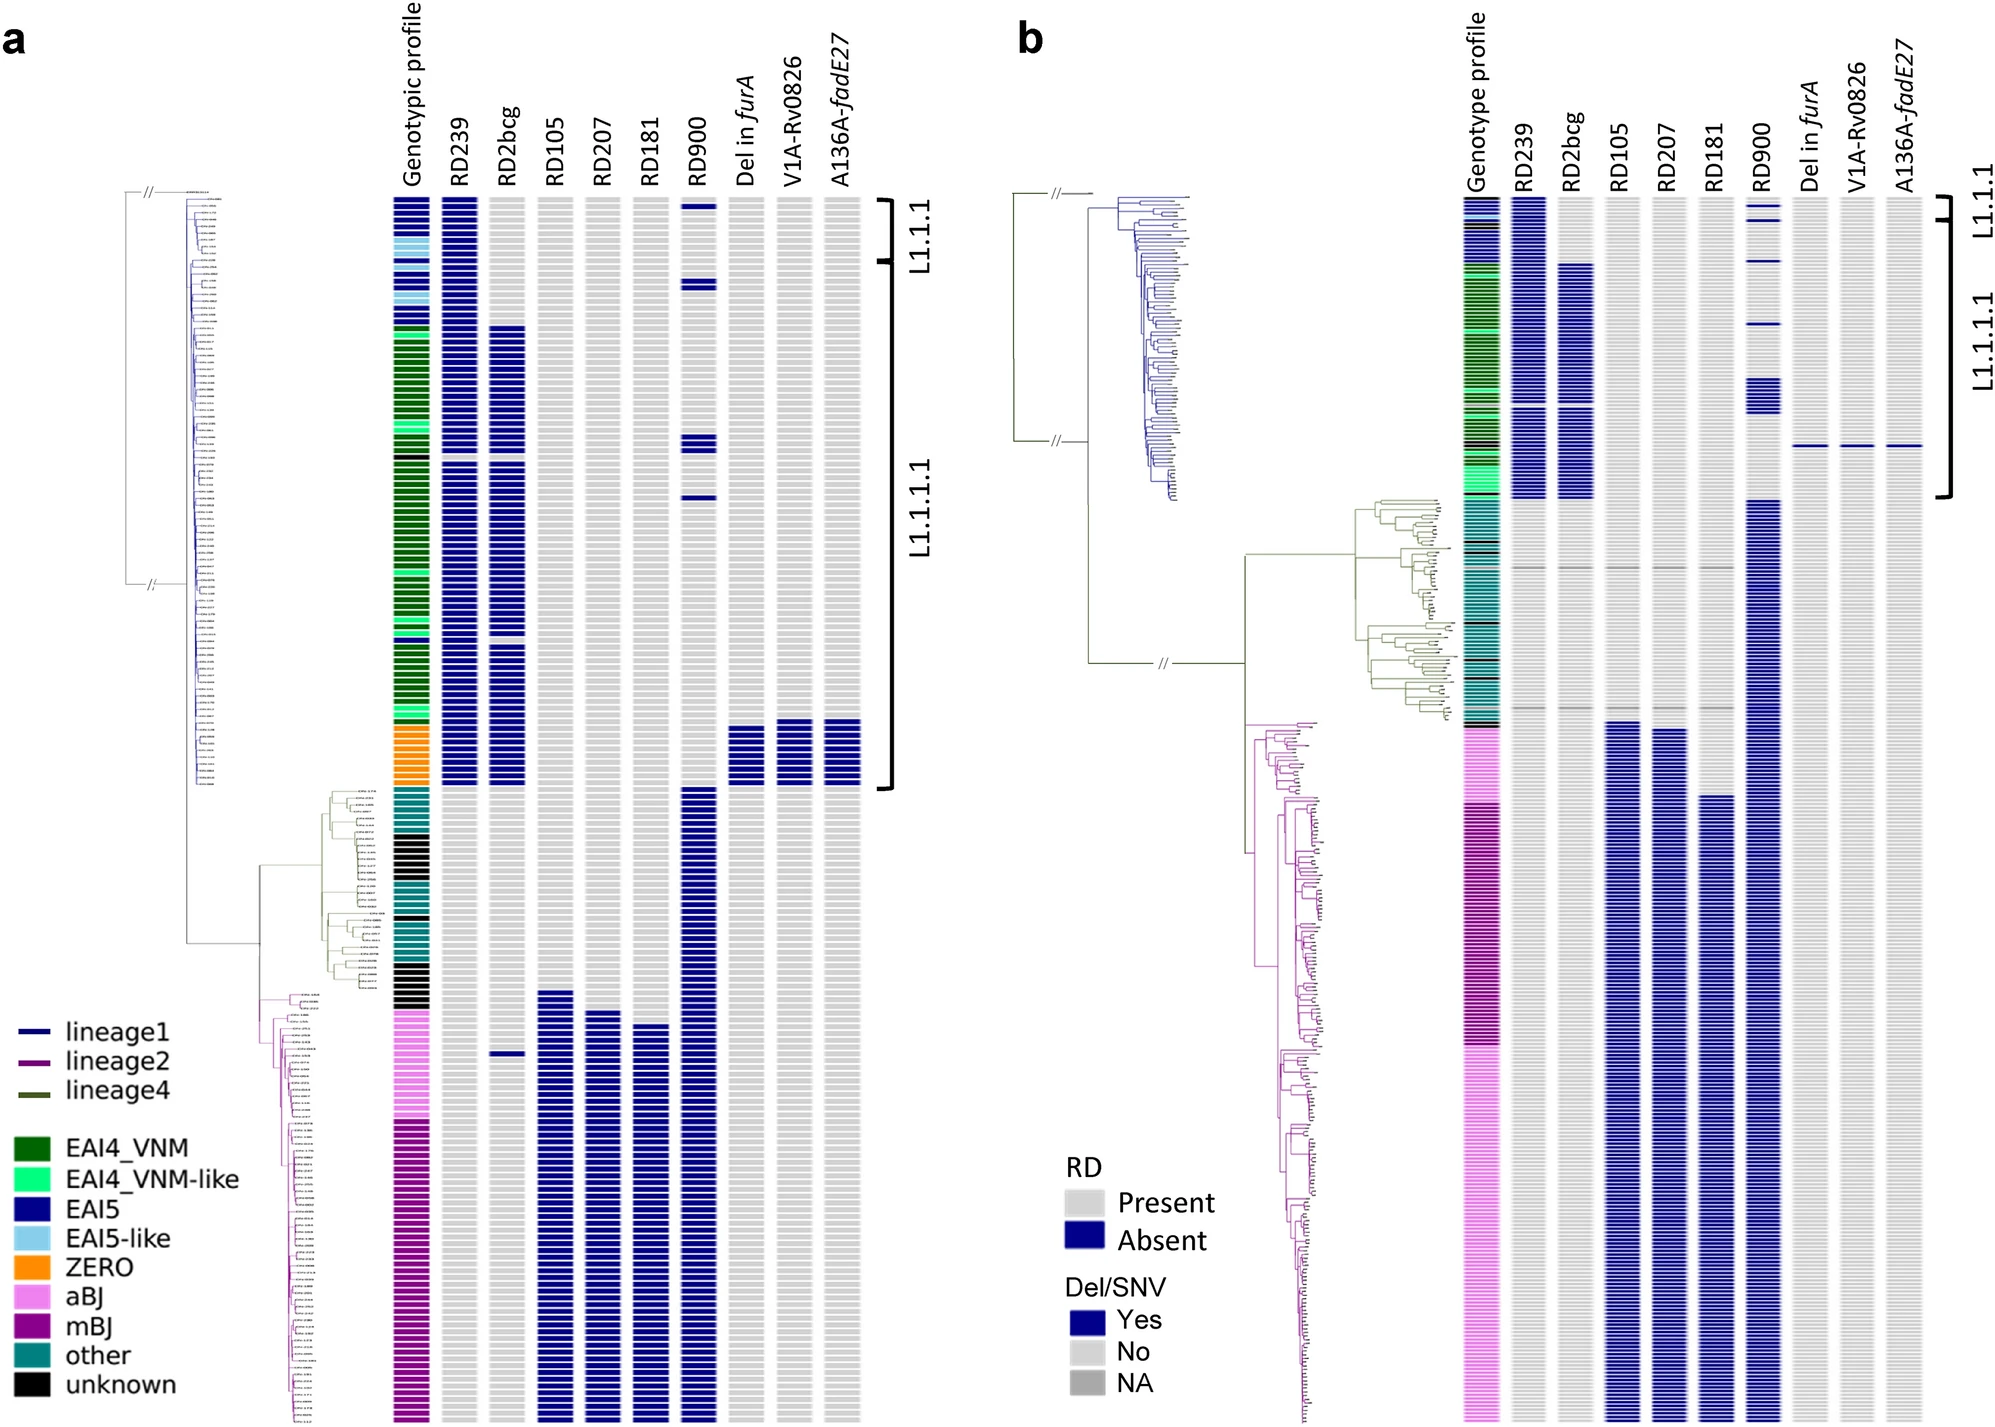
估计阅读时长: 7 分钟F统计量是群体遗传学中由Sewall Wright提出的重要统计量,用于衡量遗传变异在群体中的分布情况。它提供了对群体遗传结构和遗传分化的定量描述。F统计量主要有三种类型:Fis、Fit和Fst,分别反映个体内的、总体的和群体间的遗传分化。F统计量在群体遗传学中通常指的是Fst(Fixation Index,固定指数),它是一个衡量群体间遗传差异的指标。Fst的值范围从0到1,其中0表示群体间没有差异,1表示群体间完全分离。在群体遗传学研究中,Fst常用于评估群体的遗传多样性、群体间的迁移率以及自然选择的压力等。
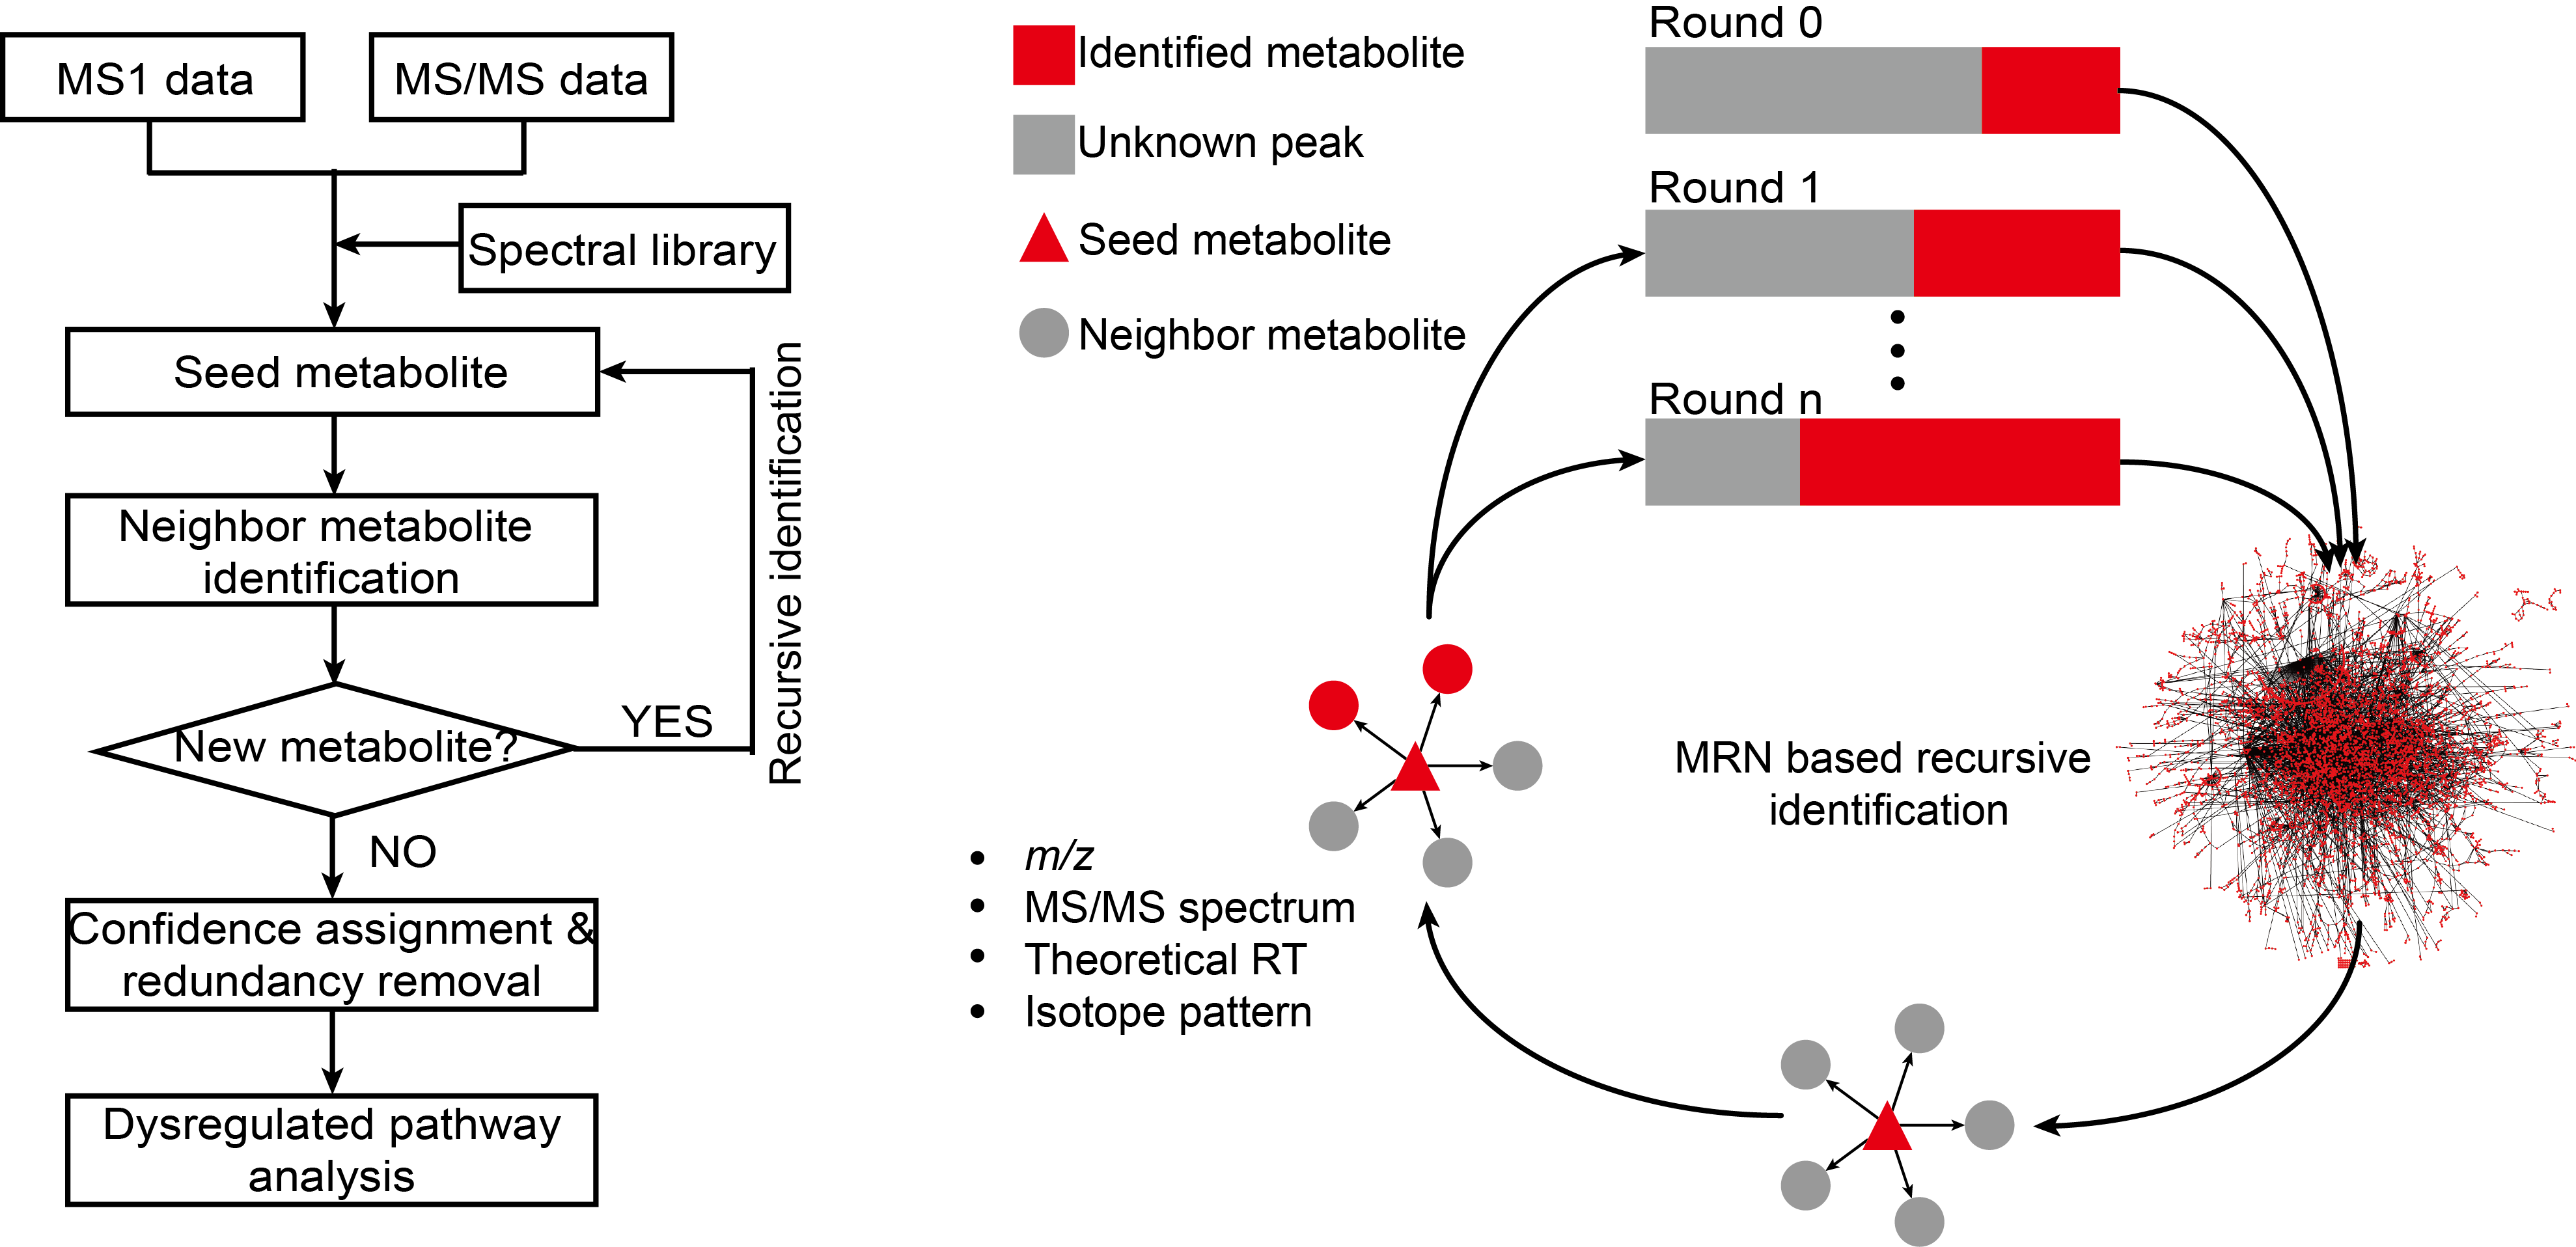
估计阅读时长: 6 分钟访问在线服务: http://metdna.zhulab.cn/ Metabolite identification is the long-standing challenge for liquid chromatography-mass spectrometry (LC-MS)-based untargeted metabolomics. Here, […]
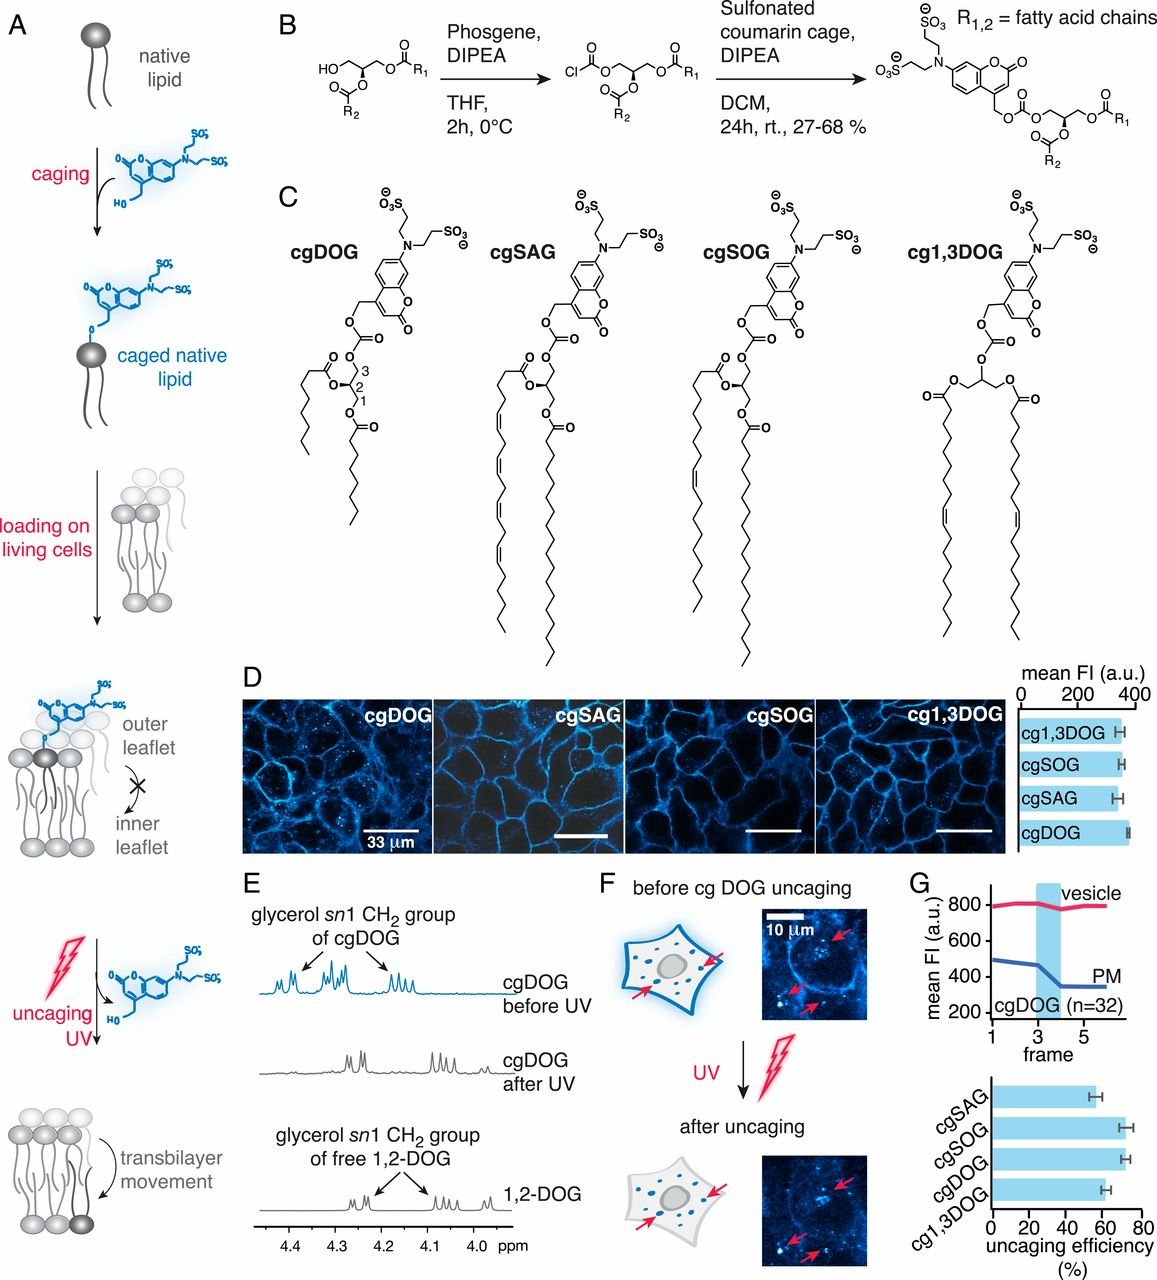
估计阅读时长: 17 分钟脂质的分类 LipidMAPS是美国国立卫生院推进的“脂质代谢途径研究计划”,涵盖目前最权威的脂类分类、命名法和结构信息,还囊括了众多的脂质组定性定量方法。此外,它还提供了一些生物信息学分析工具,比如基于质谱的脂质定性工具,通过给定特定的m/z,或特征子离子信息,或二级谱图信息,可以预测可能的脂质分子;又比如可以管理、可视化及编辑脂质信号通路等。
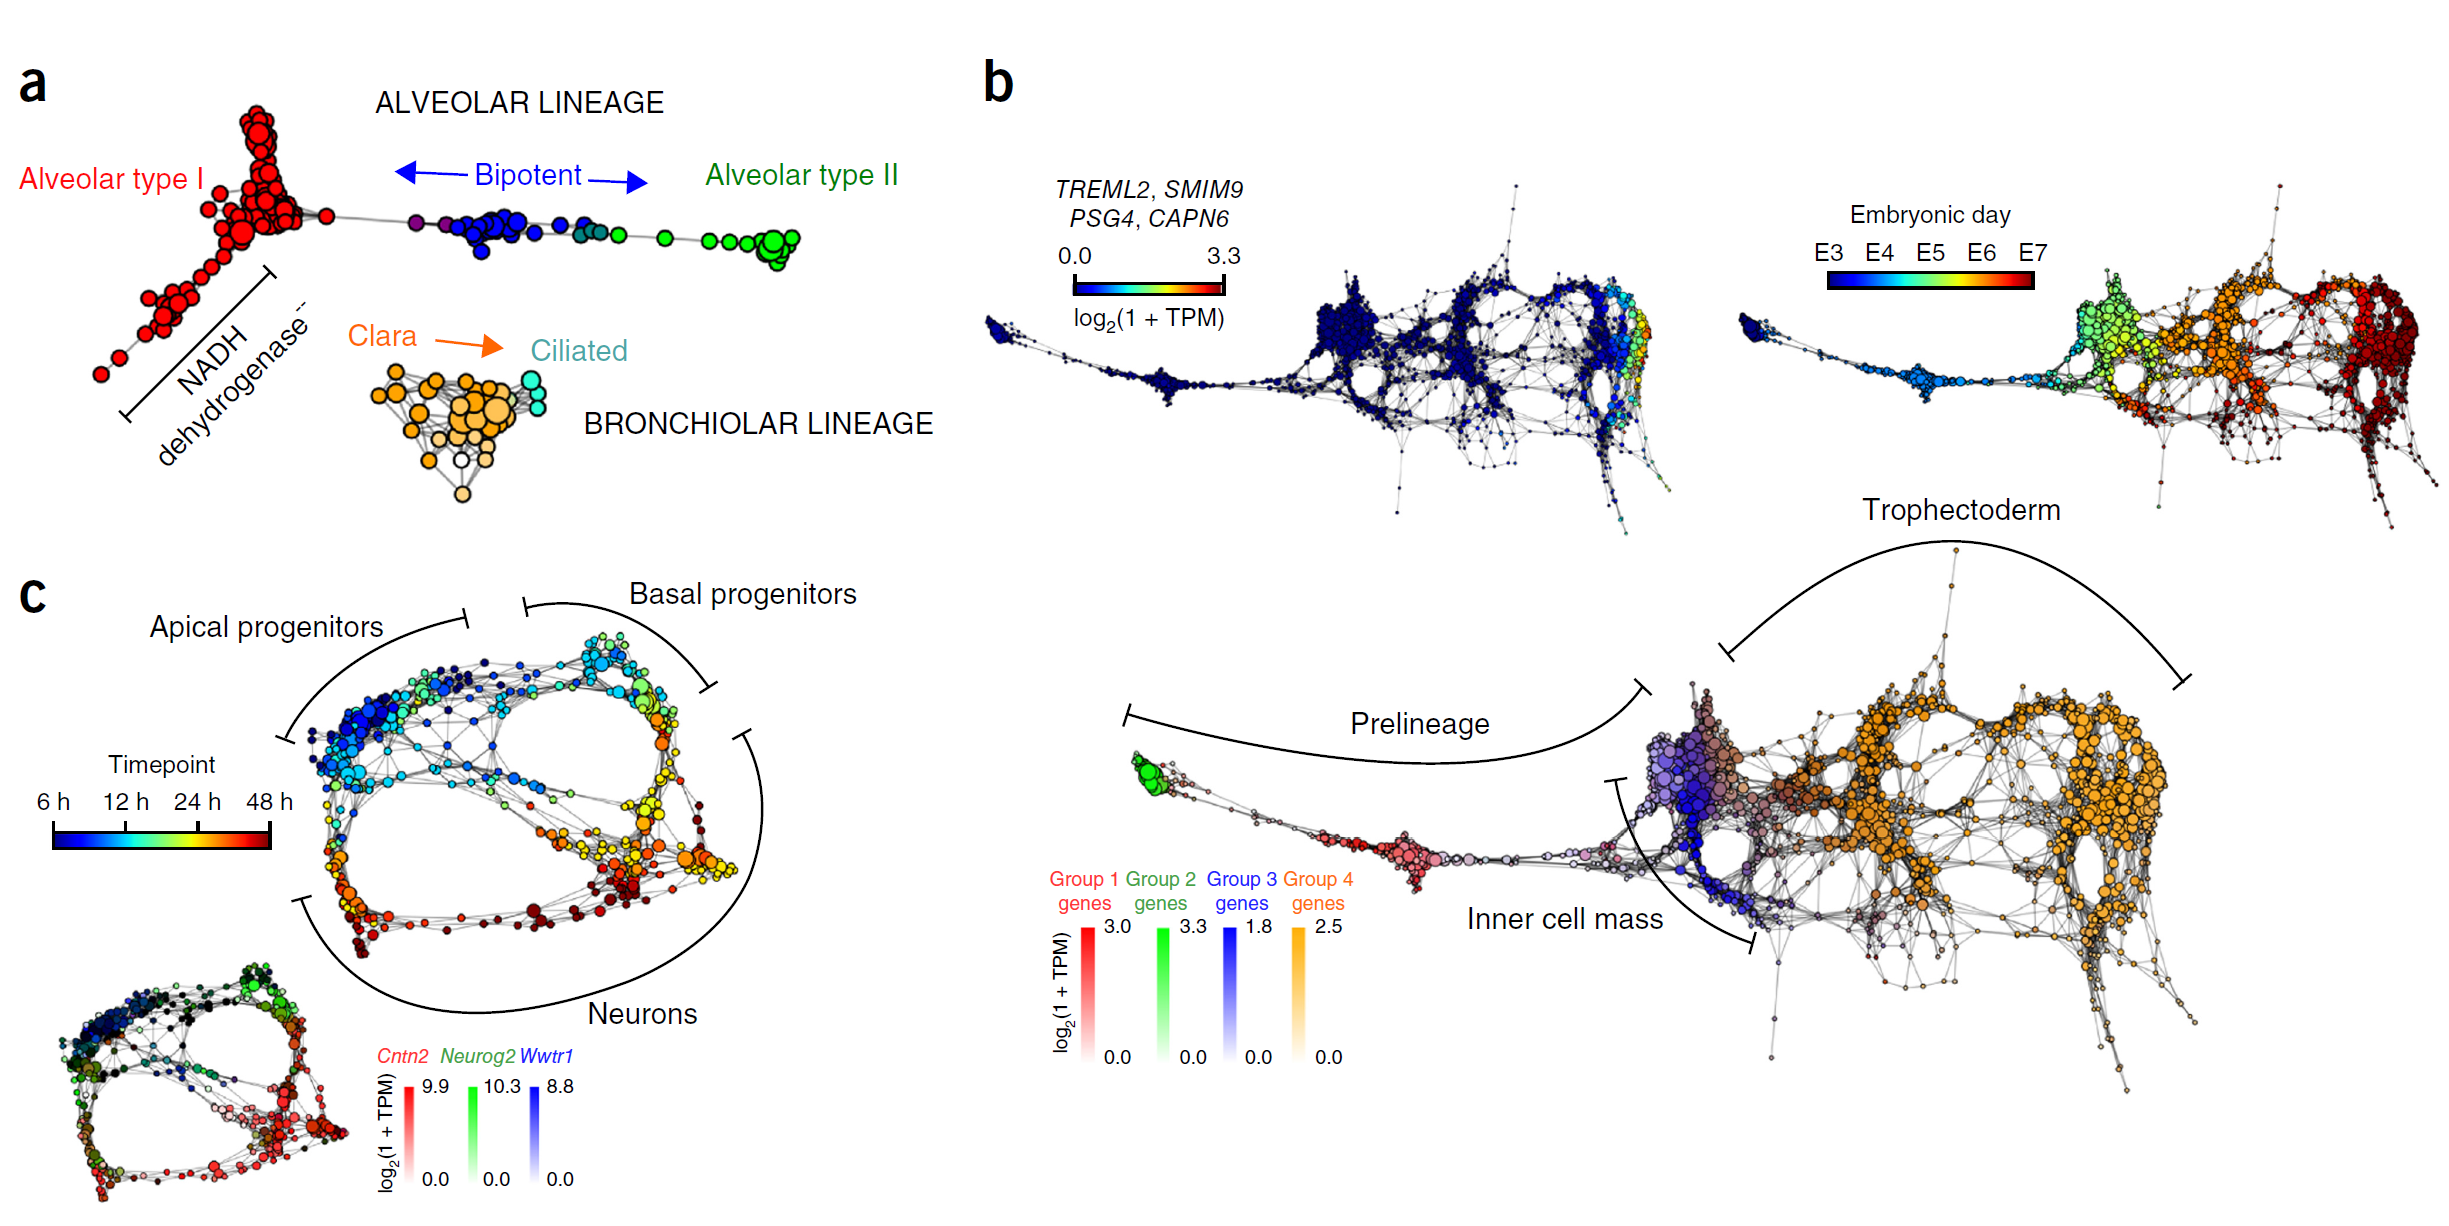
估计阅读时长: 14 分钟单细胞分析方法学习文献打卡记录: 【单细胞组学】PhenoGraph单细胞分型 【单细胞分析方法】VeTra:基于RNA速度的轨迹推断工具 【单细胞分析方法】单细胞图嵌入

代谢组学那堆名词我上次查资料时也手抄过一页,QC 样本、保留时间、m/z 这些混在一张表里,来回对照着看特别费劲。你这篇把英文缩写和中文解释排在一起,省了我不少翻文献的功夫,尤其是代谢物鉴定那几段。
文中提出的"能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢?"让我想到一个需要先厘清的问题:把Family层级的分类当作细胞分群标签时,功能相似性与亲缘关系可能会混在一起,图上的聚集未必能直接解释为代谢功能接近。如果借用单细胞分析中的降维流程,是否可以同时标注物种分类和基因组注释完整度,看看分离主要对应哪一种差异?尤其是这里用的是EC注释的TF-IDF矩阵,缺少某项注释究竟代表功能缺失还是未被识别,也可能影响对分群结果的判断。
这个角度之前没想到,零分布原理及其在生物信息学中的应用 确实值得深入了解。刚好之前看过,可以对照着看看。
Greetings! I stumbled upon this really useful site and figured I'd thanks for you post at here.
This content speaks to hearts