
估计阅读时长: 9 分钟https://github.com/rsharp-lang/Rnb 之前使用Python脚本进行编写代码的时候,十分的羡慕Python脚本可以基于ipynb记事本进行文档化的编码。在之前R#脚本是缺少相关的代码库模块将可执行的R#脚本渲染成可视化文档。但是经过几天的开发工作时候,现在R#脚本编程已经具备有了文档化编程的基本框架了。
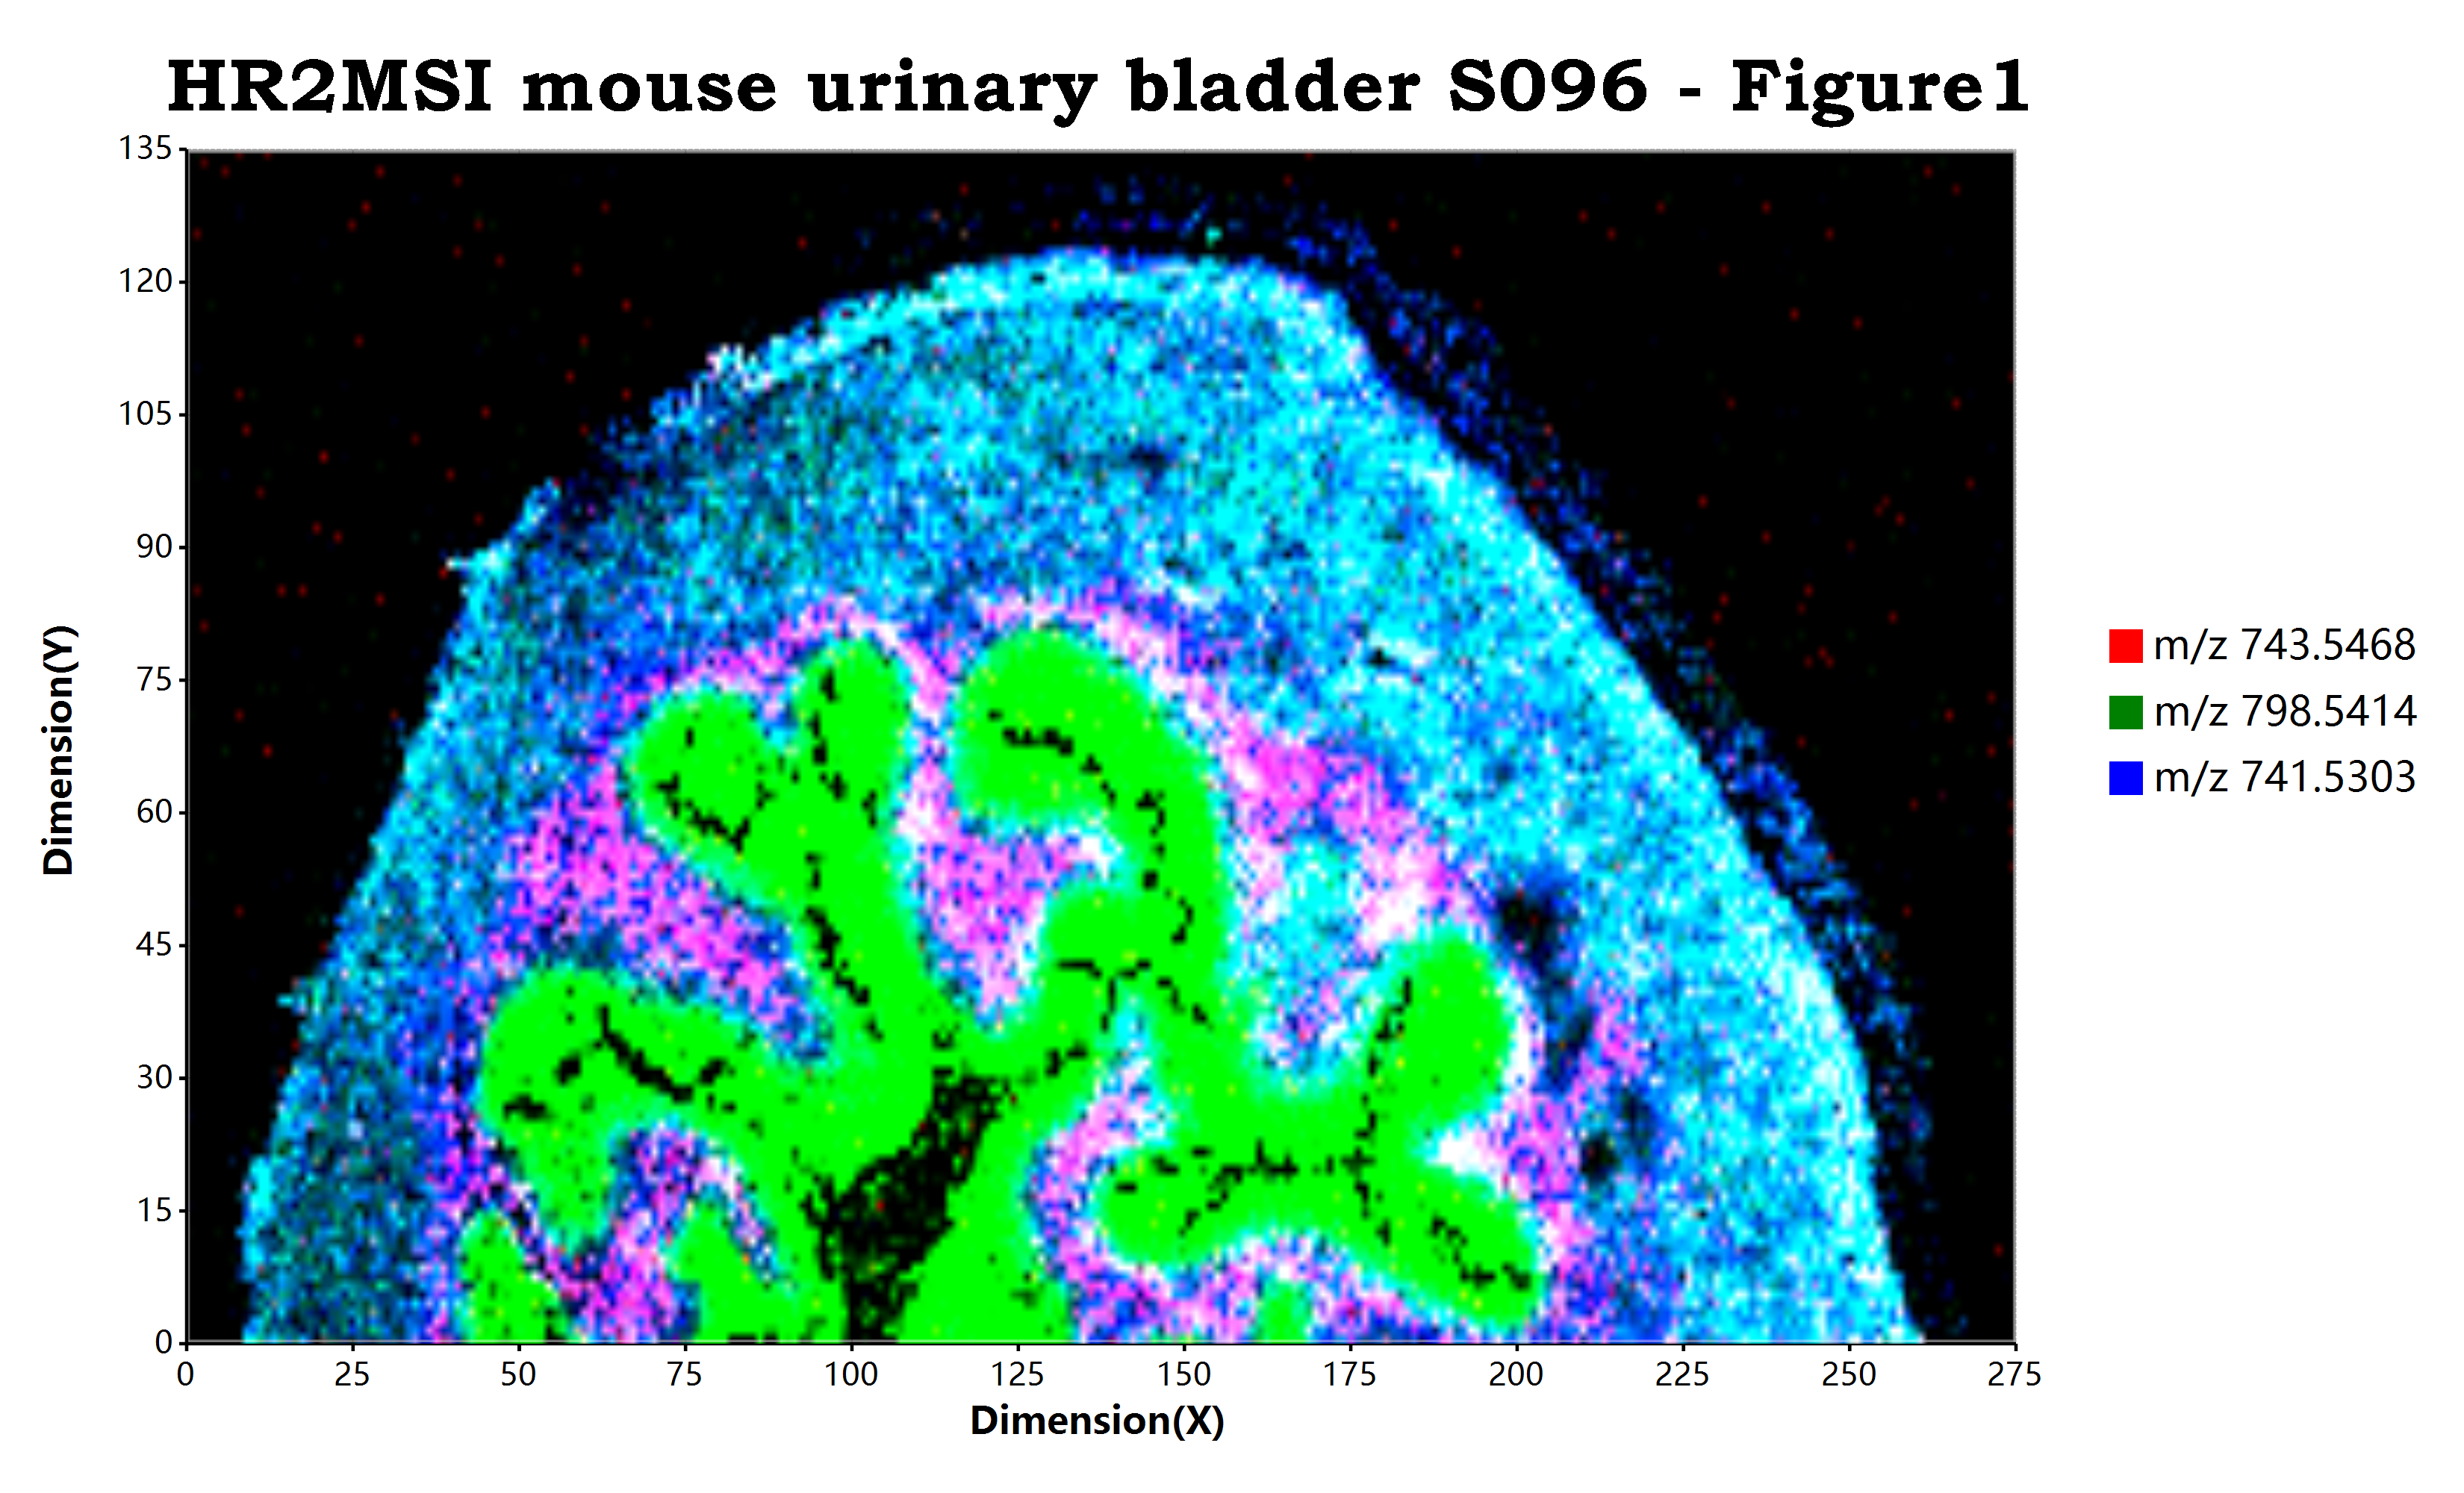
估计阅读时长: 11 分钟https://github.com/xieguigang/ms-imaging Mass spectrometry imaging ( MSI) is a technique used in mass spectrometry to visualize the […]
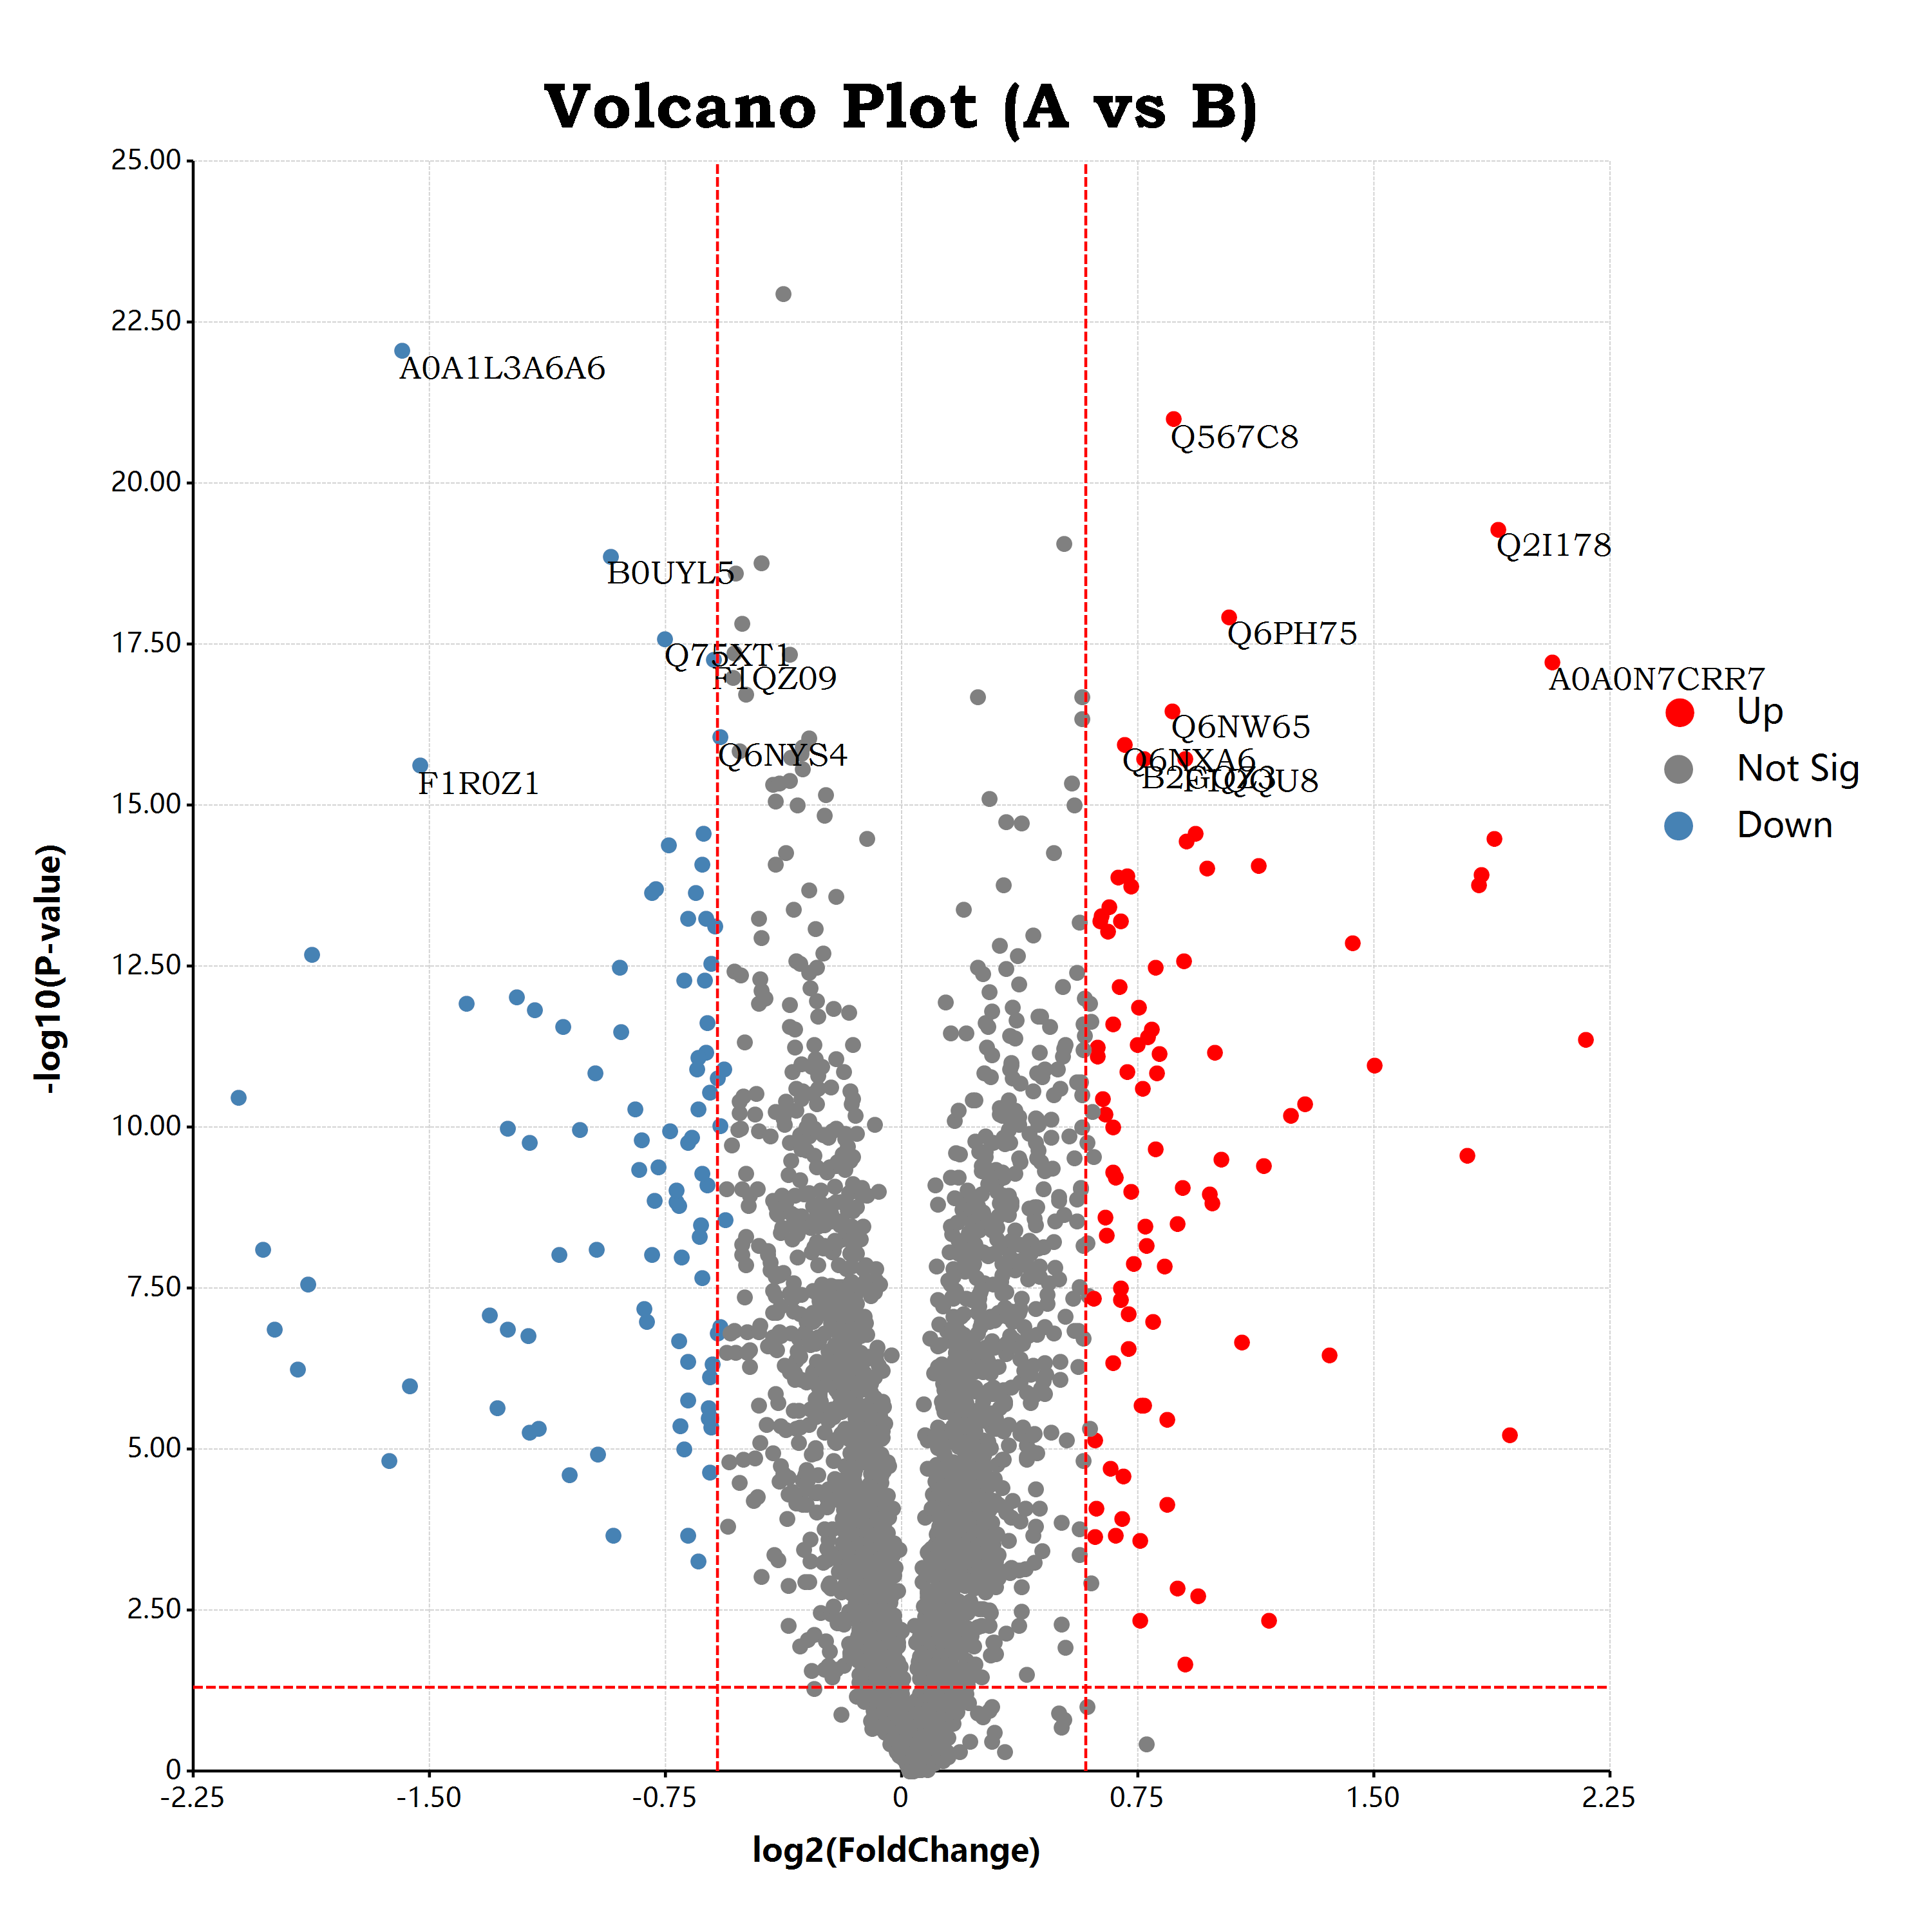
估计阅读时长: 17 分钟https://github.com/rsharp-lang/ggplot 接上一篇博客文章中谈到,我们已经通过R#语言之中的ggplot程序包绘制出了一个可以使用的火山图。在这里,我们将会通过在火山图上添加更多的可视化元素来为大家介绍R#语言之中的ggplot程序包的进阶使用方式。
估计阅读时长: 11 分钟https://github.com/rsharp-lang/ggplot 在生物信息学中的组学数据分析领域内,有一个非常常见的数据可视化图表:应用于可视化两两组别比对结果的火山图。在火山图之中,X坐标轴一般是log2FC,纵坐标Y轴,则一般是t检验的pvalue的-log10转换之后的值。由于fold change有大于1的值,A/B大于1,表示A的表达量高于B的表达量,反之小于一表示A的表达量低于B的表达量。这样子fold change经过log2转换之后,就会出现负数,散点一般呈轴对称分布在X=0的位置周围。这样子绘制出来的散点图就有点类似于火山喷发的样子了。
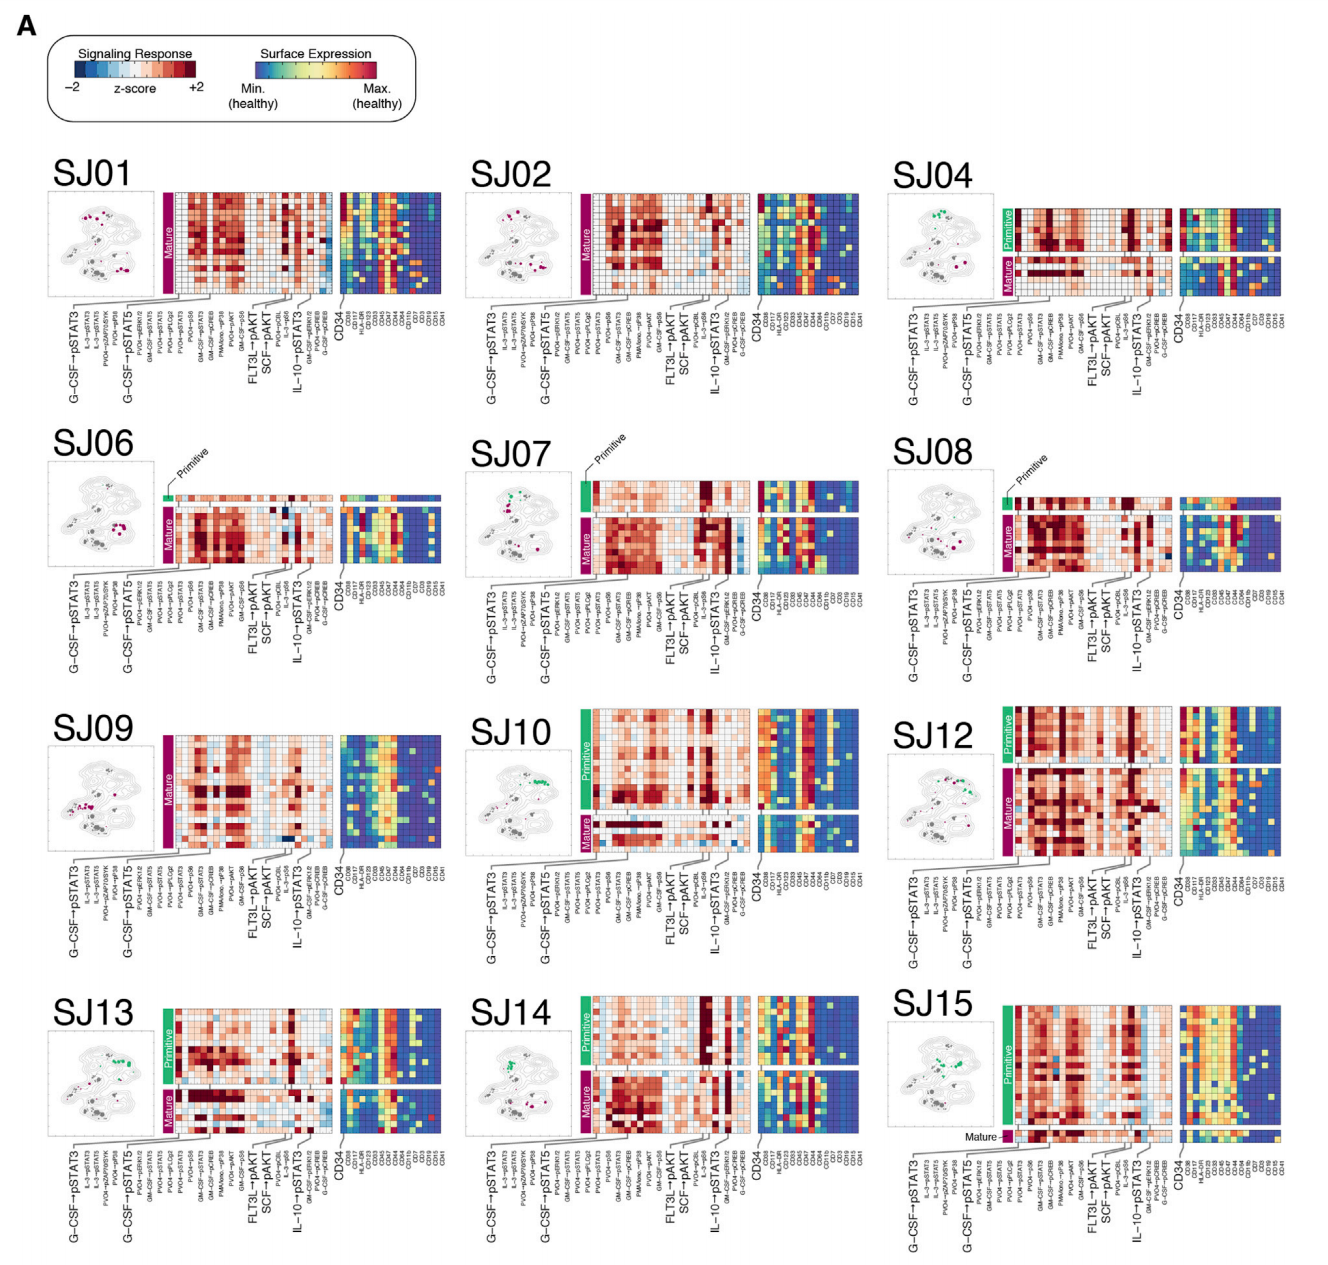
估计阅读时长: 7 分钟https://github.com/rsharp-lang/ggplot 一张统计图形就是从数据到几何对象(geometric object, 缩写为geom, 包括点、线、条形等)的图形属性(aesthetic attributes, 缩写为aes, 包括颜色、形状、大小等)的一个映射。此外, 图形中还可能包含数据的统计变换(statistical transformation, 缩写为stats), 最后绘制在某个特定的坐标系(coordinate system, 缩写为coord)中, 而分面(facet, 指将绘图窗口划分为若干个子窗口)则可以用来生成数据中不同子集的图形。 […]
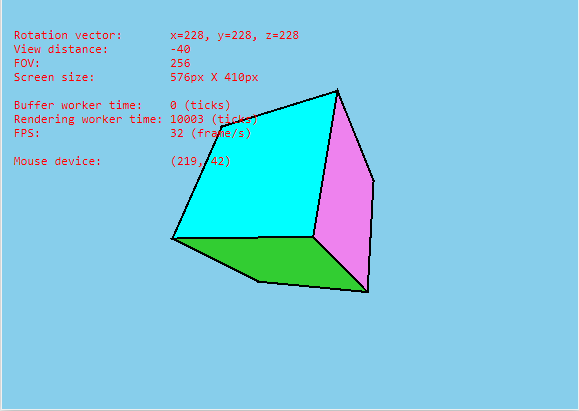
估计阅读时长: 17 分钟https://github.com/xieguigang/sciBASIC/tree/master/gr/Microsoft.VisualBasic.Imaging/Drawing3D 因为大家大多数都是从小接受电子游戏,所以长大了之后能够自己从零开始开发一个完整的3维图形引擎是每一个男程序员的梦想。这个就像玩机械的男人的梦想就是自己从头开始组装一辆汽车。还好这个梦想我在几年前就已经实现了。
估计阅读时长: 9 分钟https://github.com/rsharp-lang/bing-academic 必应学术是由微软必应团队联合微软研究院打造的免费学术搜索产品。旨在为广大研究人员提供海量的学术资源,并提供智能的语义搜索服务。目前已涵盖多学科学术论文、国际会议、权威期刊、知名学者等方面。搜索位置:http://cn.bing.com/academic。
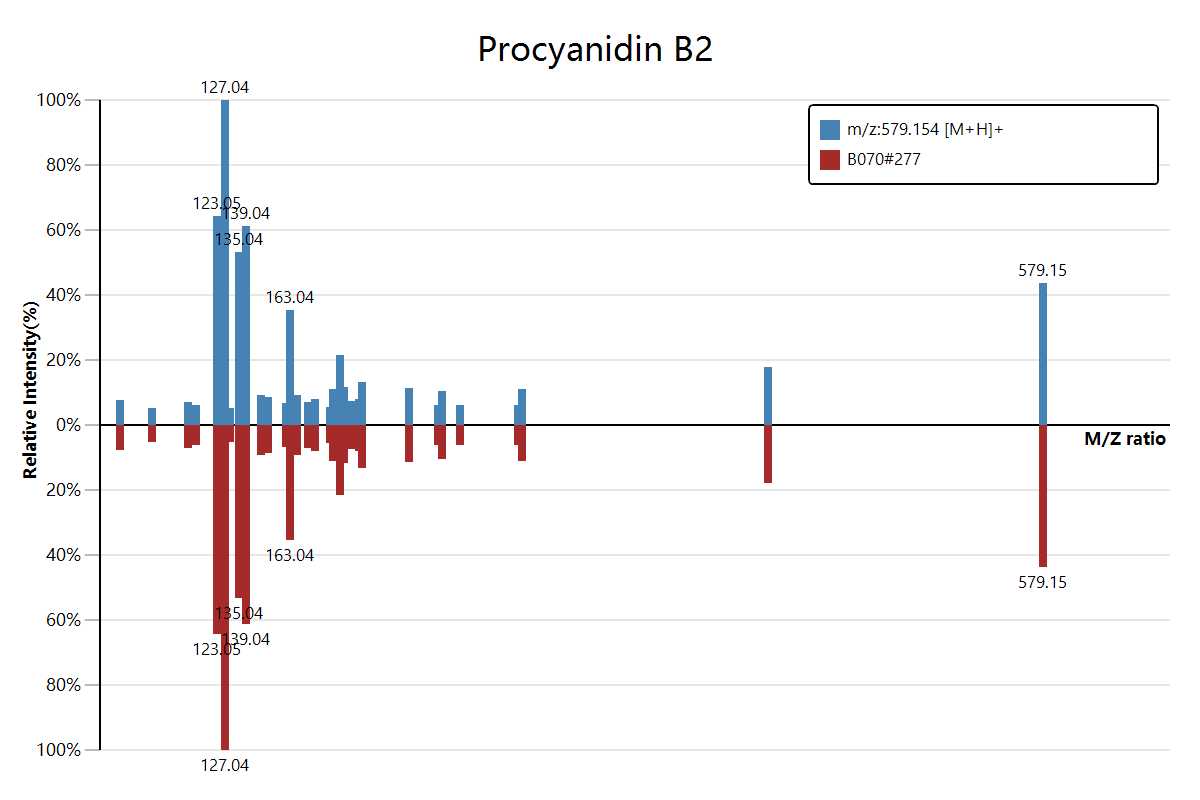
估计阅读时长: 2 分钟https://mzkit.org/ 代谢组文章整个坎坷的发表经历中,大家可能都会遇到的一个老大难问题就是我们有时候会需要从原始数据中得到物质注释结果的二级质谱图数据。对于熟悉xcms程序包的同学,获取二级质谱图可能会比较容易:无非就是加载原始数据,然后按照m/z和rt找到对应的二级scan就好了。但是,这种方法会需要编写脚本来完成。
估计阅读时长: 2 分钟https://github.com/dotvanilla/vanilla 在Vanilla编译器项目之中,会需要一个程序模块将VisualBasic代码进行解析为语法树。然后我们基于此语法树就可以将VisualBasic项目转换为WAST源代码,从而实现编译为WebAssembly程序了。在这个步骤之中,我们可以通过一个微软官方的Roslyn编译器平台来实现。
估计阅读时长: 9 分钟https://github.com/dotvanilla/vanilla WebAssembly是一种运行在浏览器端的二进制程序集文件。和普通的应用程序开发一样,WebAssembly需要基于一定的源代码文本进行编译。这个编译所需要的源代码文本就是WAST文件。 Understanding WebAssembly text format(https://developer.mozilla.org/en-US/docs/WebAssembly/Understanding_the_text_format)

代谢组学那堆名词我上次查资料时也手抄过一页,QC 样本、保留时间、m/z 这些混在一张表里,来回对照着看特别费劲。你这篇把英文缩写和中文解释排在一起,省了我不少翻文献的功夫,尤其是代谢物鉴定那几段。
文中提出的"能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢?"让我想到一个需要先厘清的问题:把Family层级的分类当作细胞分群标签时,功能相似性与亲缘关系可能会混在一起,图上的聚集未必能直接解释为代谢功能接近。如果借用单细胞分析中的降维流程,是否可以同时标注物种分类和基因组注释完整度,看看分离主要对应哪一种差异?尤其是这里用的是EC注释的TF-IDF矩阵,缺少某项注释究竟代表功能缺失还是未被识别,也可能影响对分群结果的判断。
这个角度之前没想到,零分布原理及其在生物信息学中的应用 确实值得深入了解。刚好之前看过,可以对照着看看。
Greetings! I stumbled upon this really useful site and figured I'd thanks for you post at here.
This content speaks to hearts