
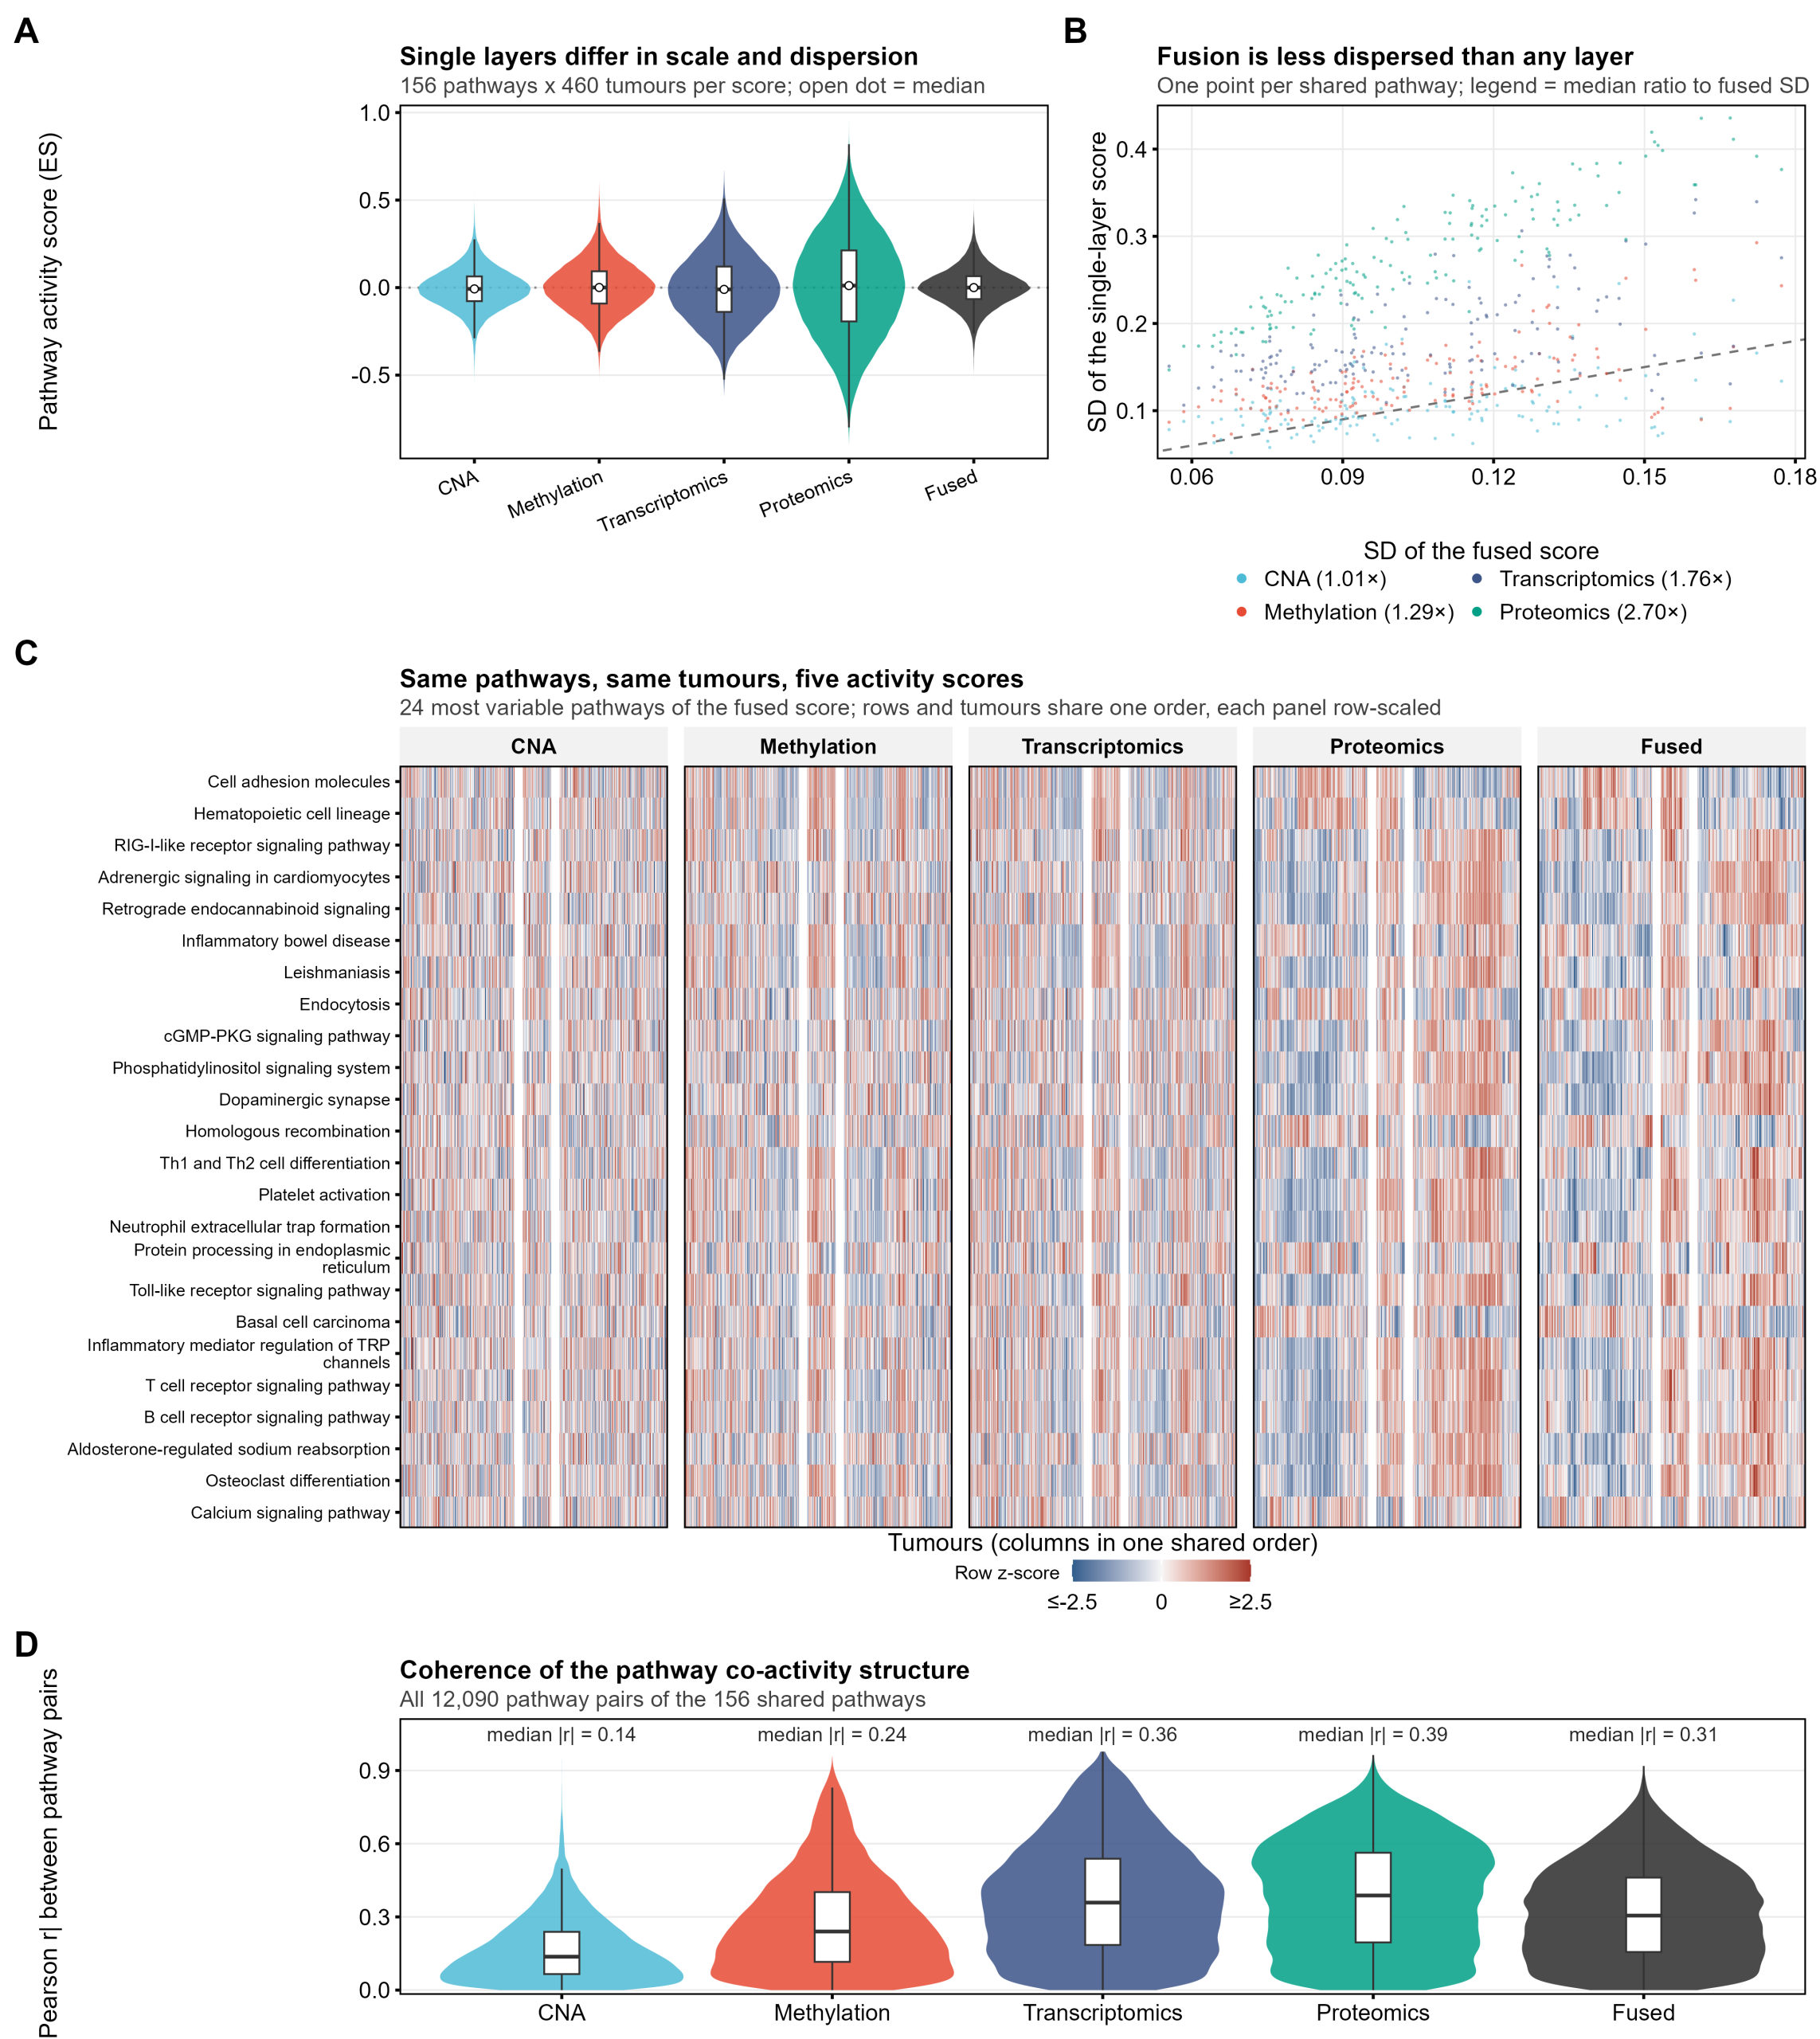
估计阅读时长: 14 分钟460 个乳腺癌、四个组学层、335 条 KEGG 通路。融合分数到底比"逐层算完再平均"强在哪?这篇文章把该泼的冷水泼完,再讲清楚它真正的价值。 面向:生物信息 / 计算生物学方向的研究生 | 预计阅读 30 分钟 数据:TCGA-BRCA(PanCanAtlas 处理版) | 配套:上篇讲数学,本篇讲实证 目录 先看数据:460 个肿瘤怎么变成四个矩阵 疾病背景:乳腺癌根本不是一种病 […]
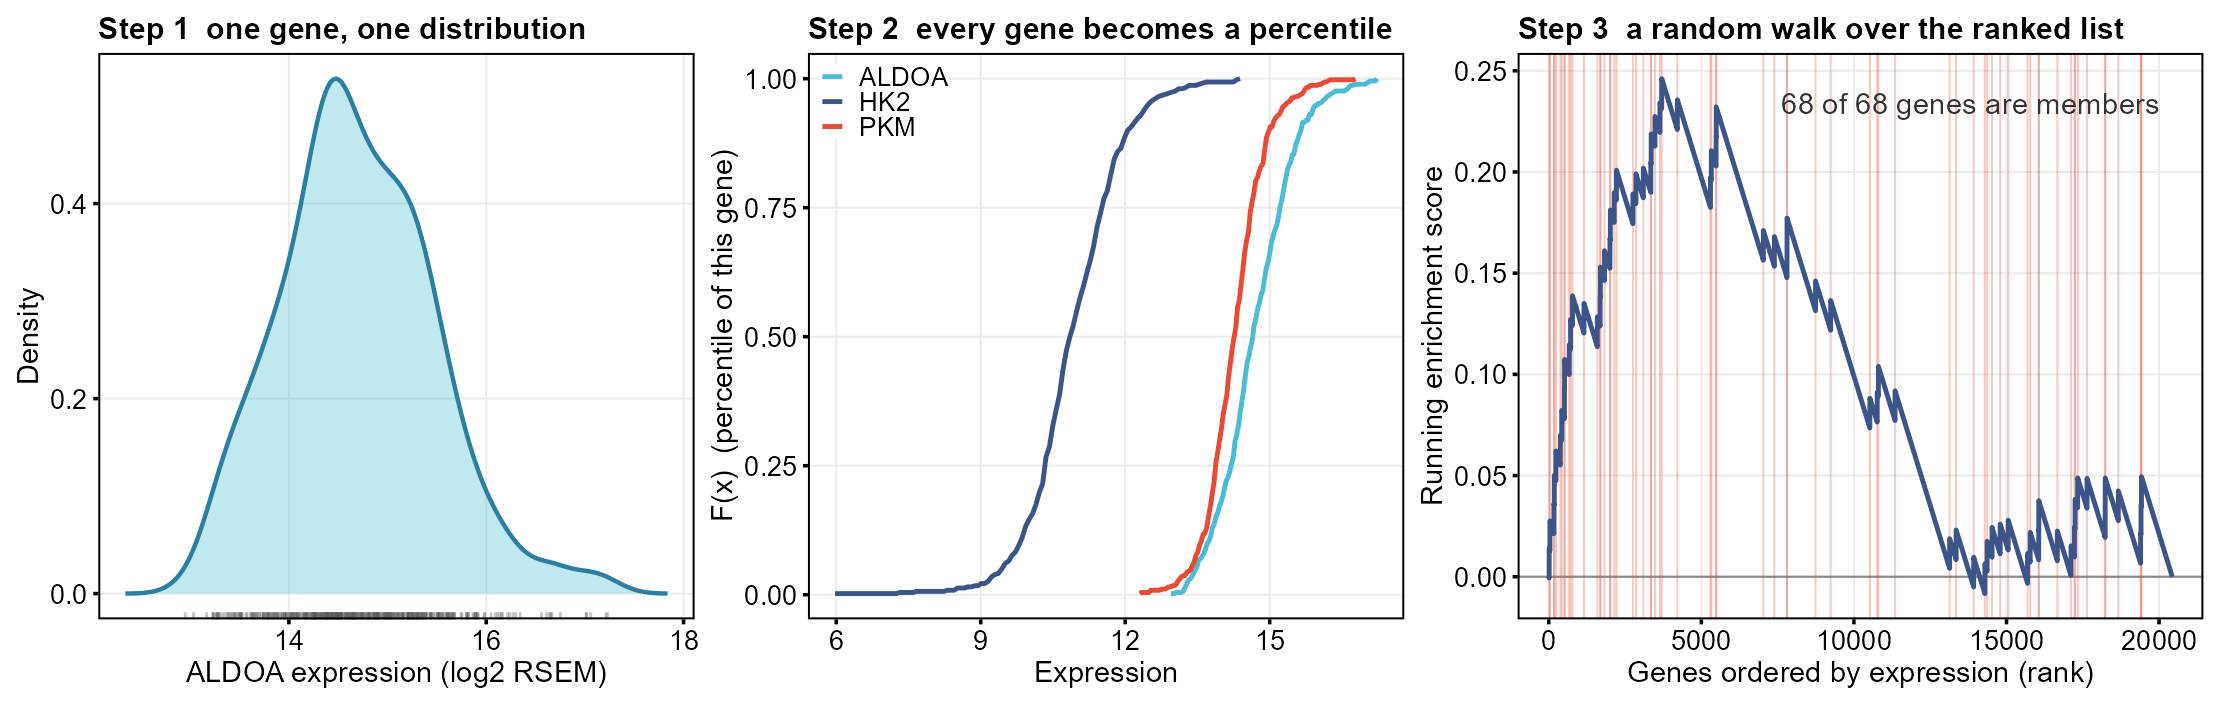
估计阅读时长: 27 分钟单样本的通路打分怎么做?四个组学层又怎么揉成一个数?这篇文章从 KDE 讲到加权融合,全程配伪代码,顺便把 mogsva.R 和它吐出来的十张表拆开讲一遍,尽量让公式看起来不像天书。 面向:生物信息 / 计算生物学方向的研究生 | 预计阅读 25 分钟 目录 一个让审稿人皱眉的问题 GSVA 第一步:给每个基因配一把自己的尺子 GSVA 第二步:把表达量换成"分位数" […]
估计阅读时长: 20 分钟用 GCModeller 做泛基因组分析(二):801 个大肠杆菌基因组实战 面向读者:具有一定 R 语言编程基础的生物信息学初学者、实验室里的微生物研究者。 本篇是系列的实战篇:从 GenBank 原始注释文件出发,用两条 R# 脚本跑完大肠杆菌的泛基因组分析, 并结合真实运行产出的结果文件逐项解读。算法原理(CD-HIT 聚类、PAV 矩阵、香农信息熵等) 请先阅读系列第一篇《用 […]
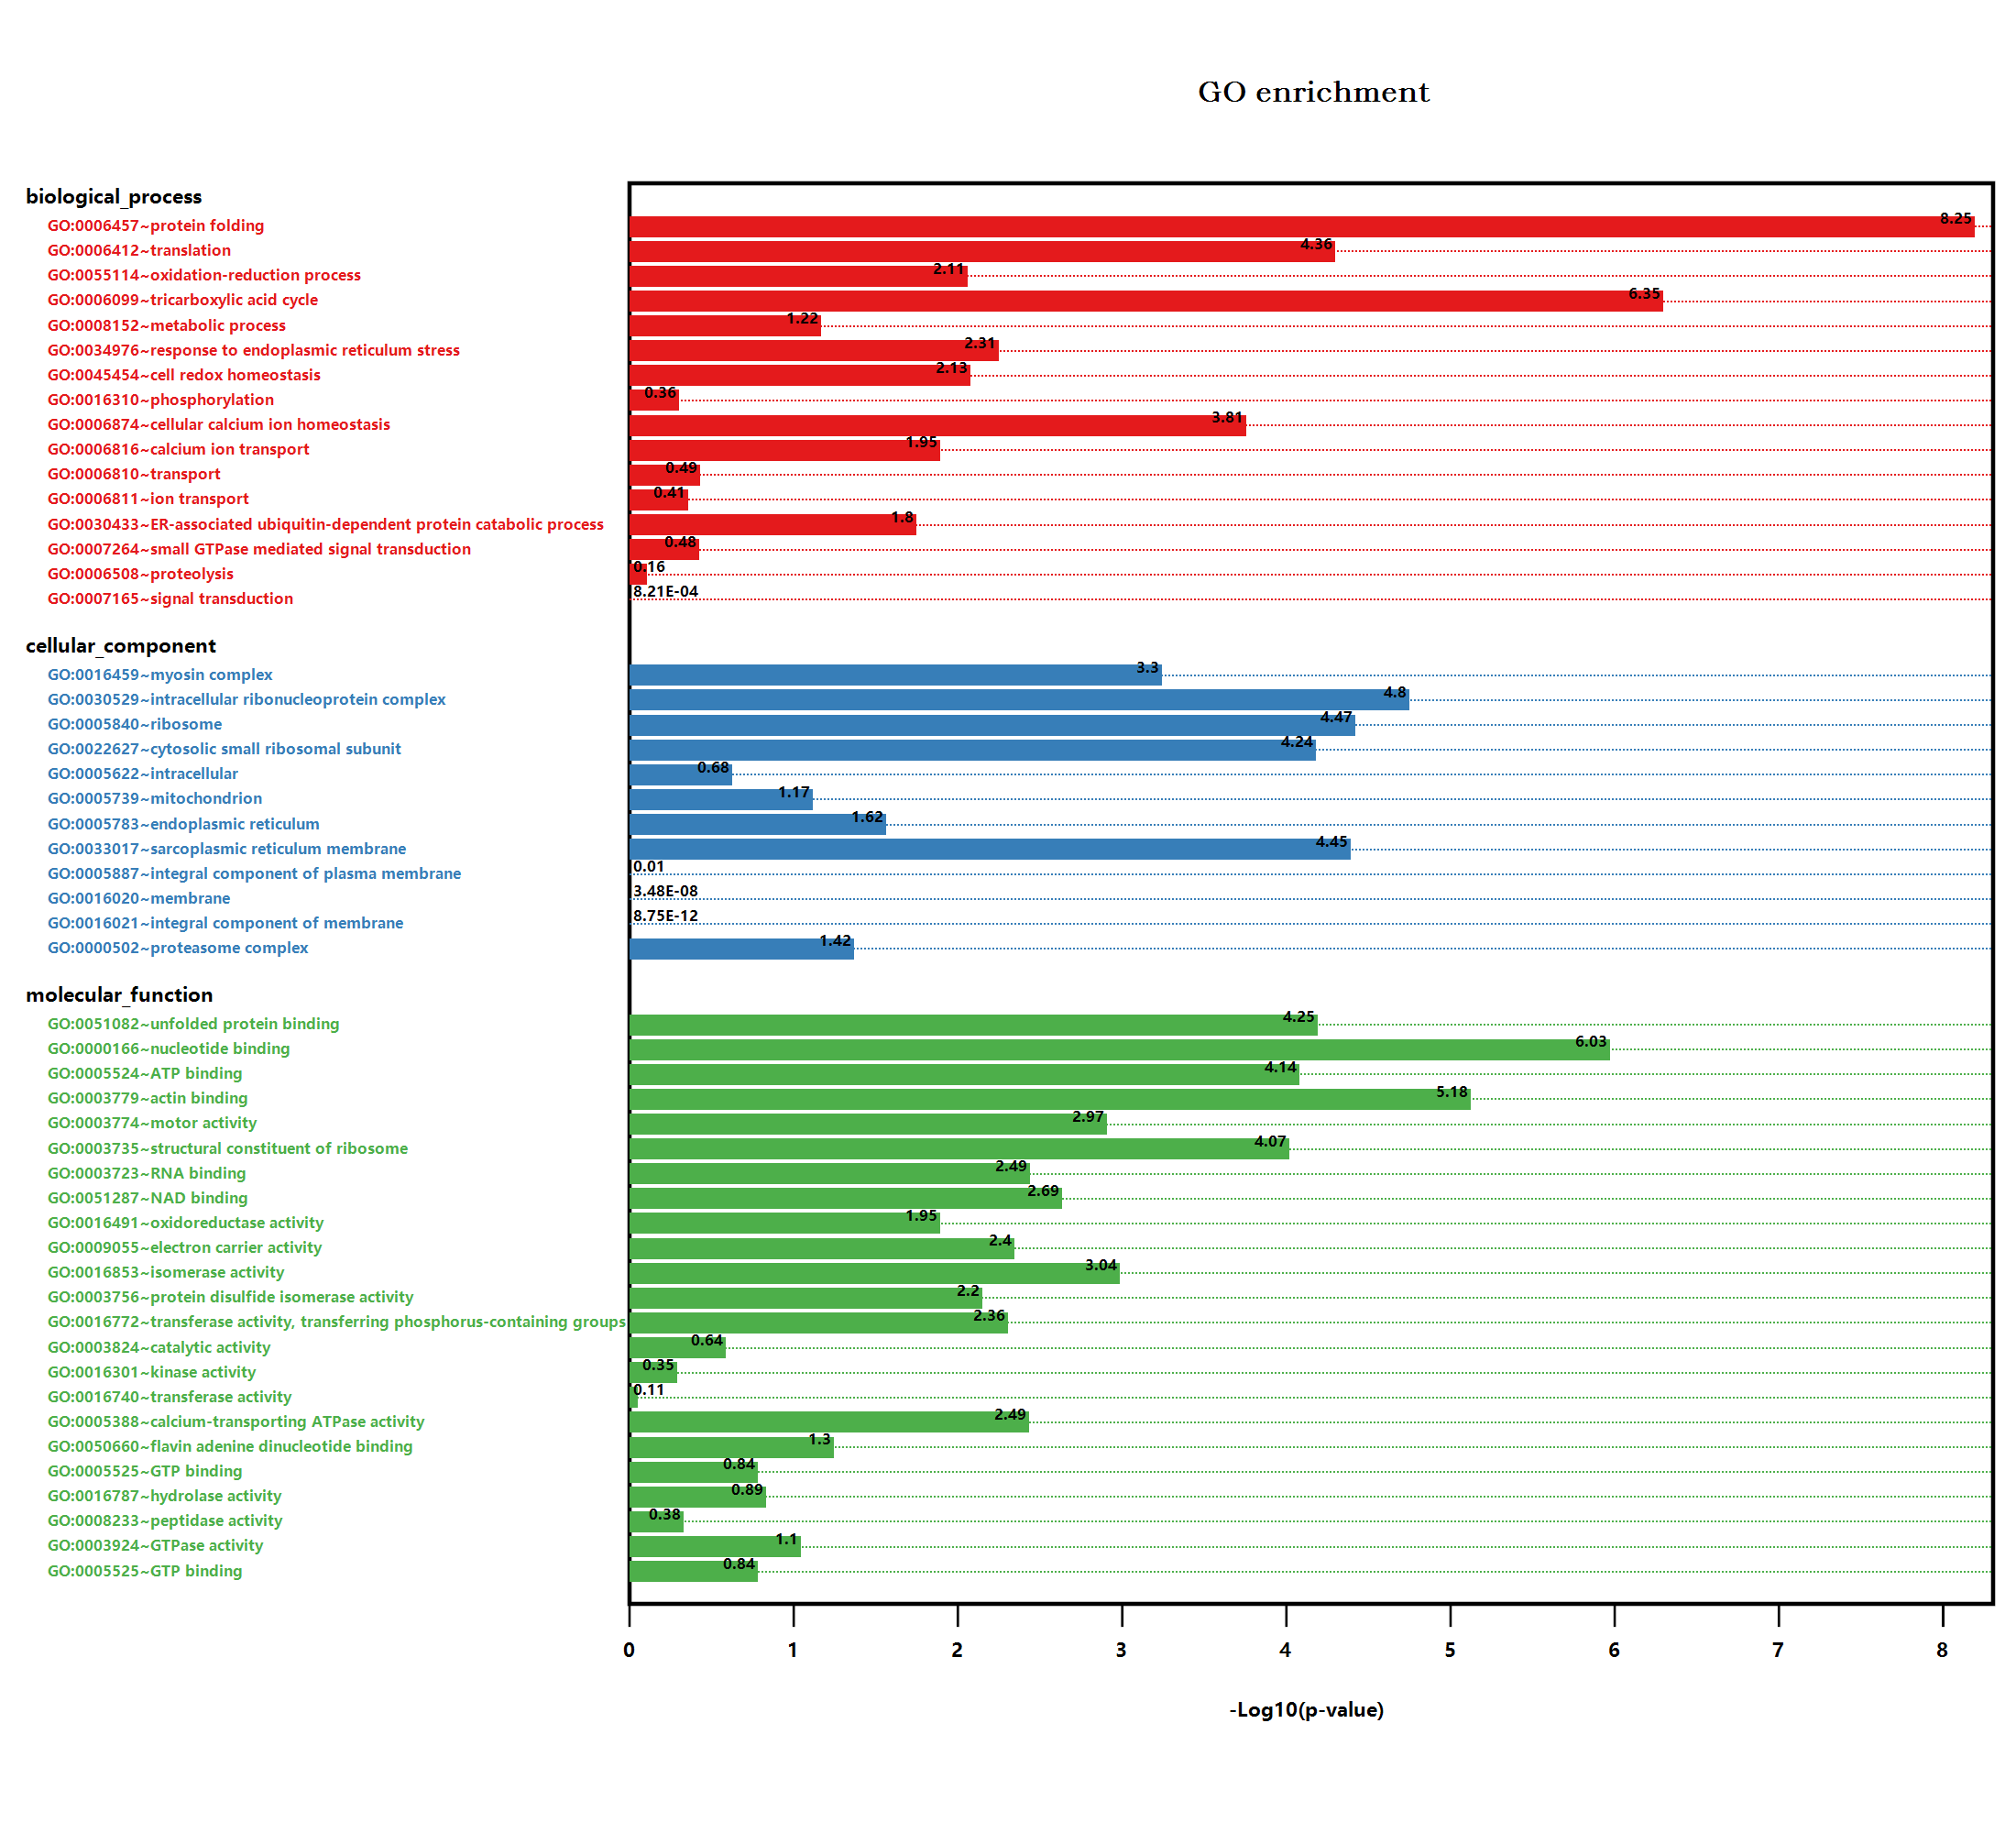
估计阅读时长: 20 分钟最近的工作中我需要按照之前的这篇博客文章《基因组功能注释(EC Number)的向量化嵌入》中所描述的流程,将好几十万个微生物基因组的功能蛋白进行酶编号的比对注释,然后基于注释结果进行向量化嵌入然后进行数据可视化。通过R#脚本对这些微生物基因组的蛋白fasta序列的提取操作,最终得到了一个大约是58GB的蛋白序列。然后将这个比较大型的蛋白序列比对到自己所收集到的ec number注释的蛋白序列参考数据库之上。
估计阅读时长: 2 分钟Github项目:https://github.com/xieguigang/marker 本程序包是一个基于R语言的综合性机器学习工具集,专门设计用于生物标志物发现和疾病预测模型的构建。该工具整合了多种机器学习算法,提供了从数据预处理、特征选择到模型构建与验证的完整工作流程,特别适用于代谢组学、基因组学等高维生物数据的分析研究。在这个程序包中,主要是通过marker函数来封装了从数据与处理到模型建立的每一个步骤,主要将程序包划分为了以下的工作步骤模块: 数据加载和预处理 初始可视化(PCA图)和统计分析(线性模型、描述性统计) 特征选择(如果未提供预选特征,则使用LASSO、随机森林和SVM-RFE三种方法) 数据分割为训练集和测试集 模型集成训练(逻辑回归、XGBoost、随机森林) 结果可视化(ROC曲线、特征重要性、SHAP分析等) 大家在这里可以通过下面的技术路线图来了解在所编写的程序包中所涉及到的分析内容与步骤: 所主要涉及到的模型算法原理 机器学习方法 数学原理 使用场景 应用 LASSO回归 LASSO(Least […]
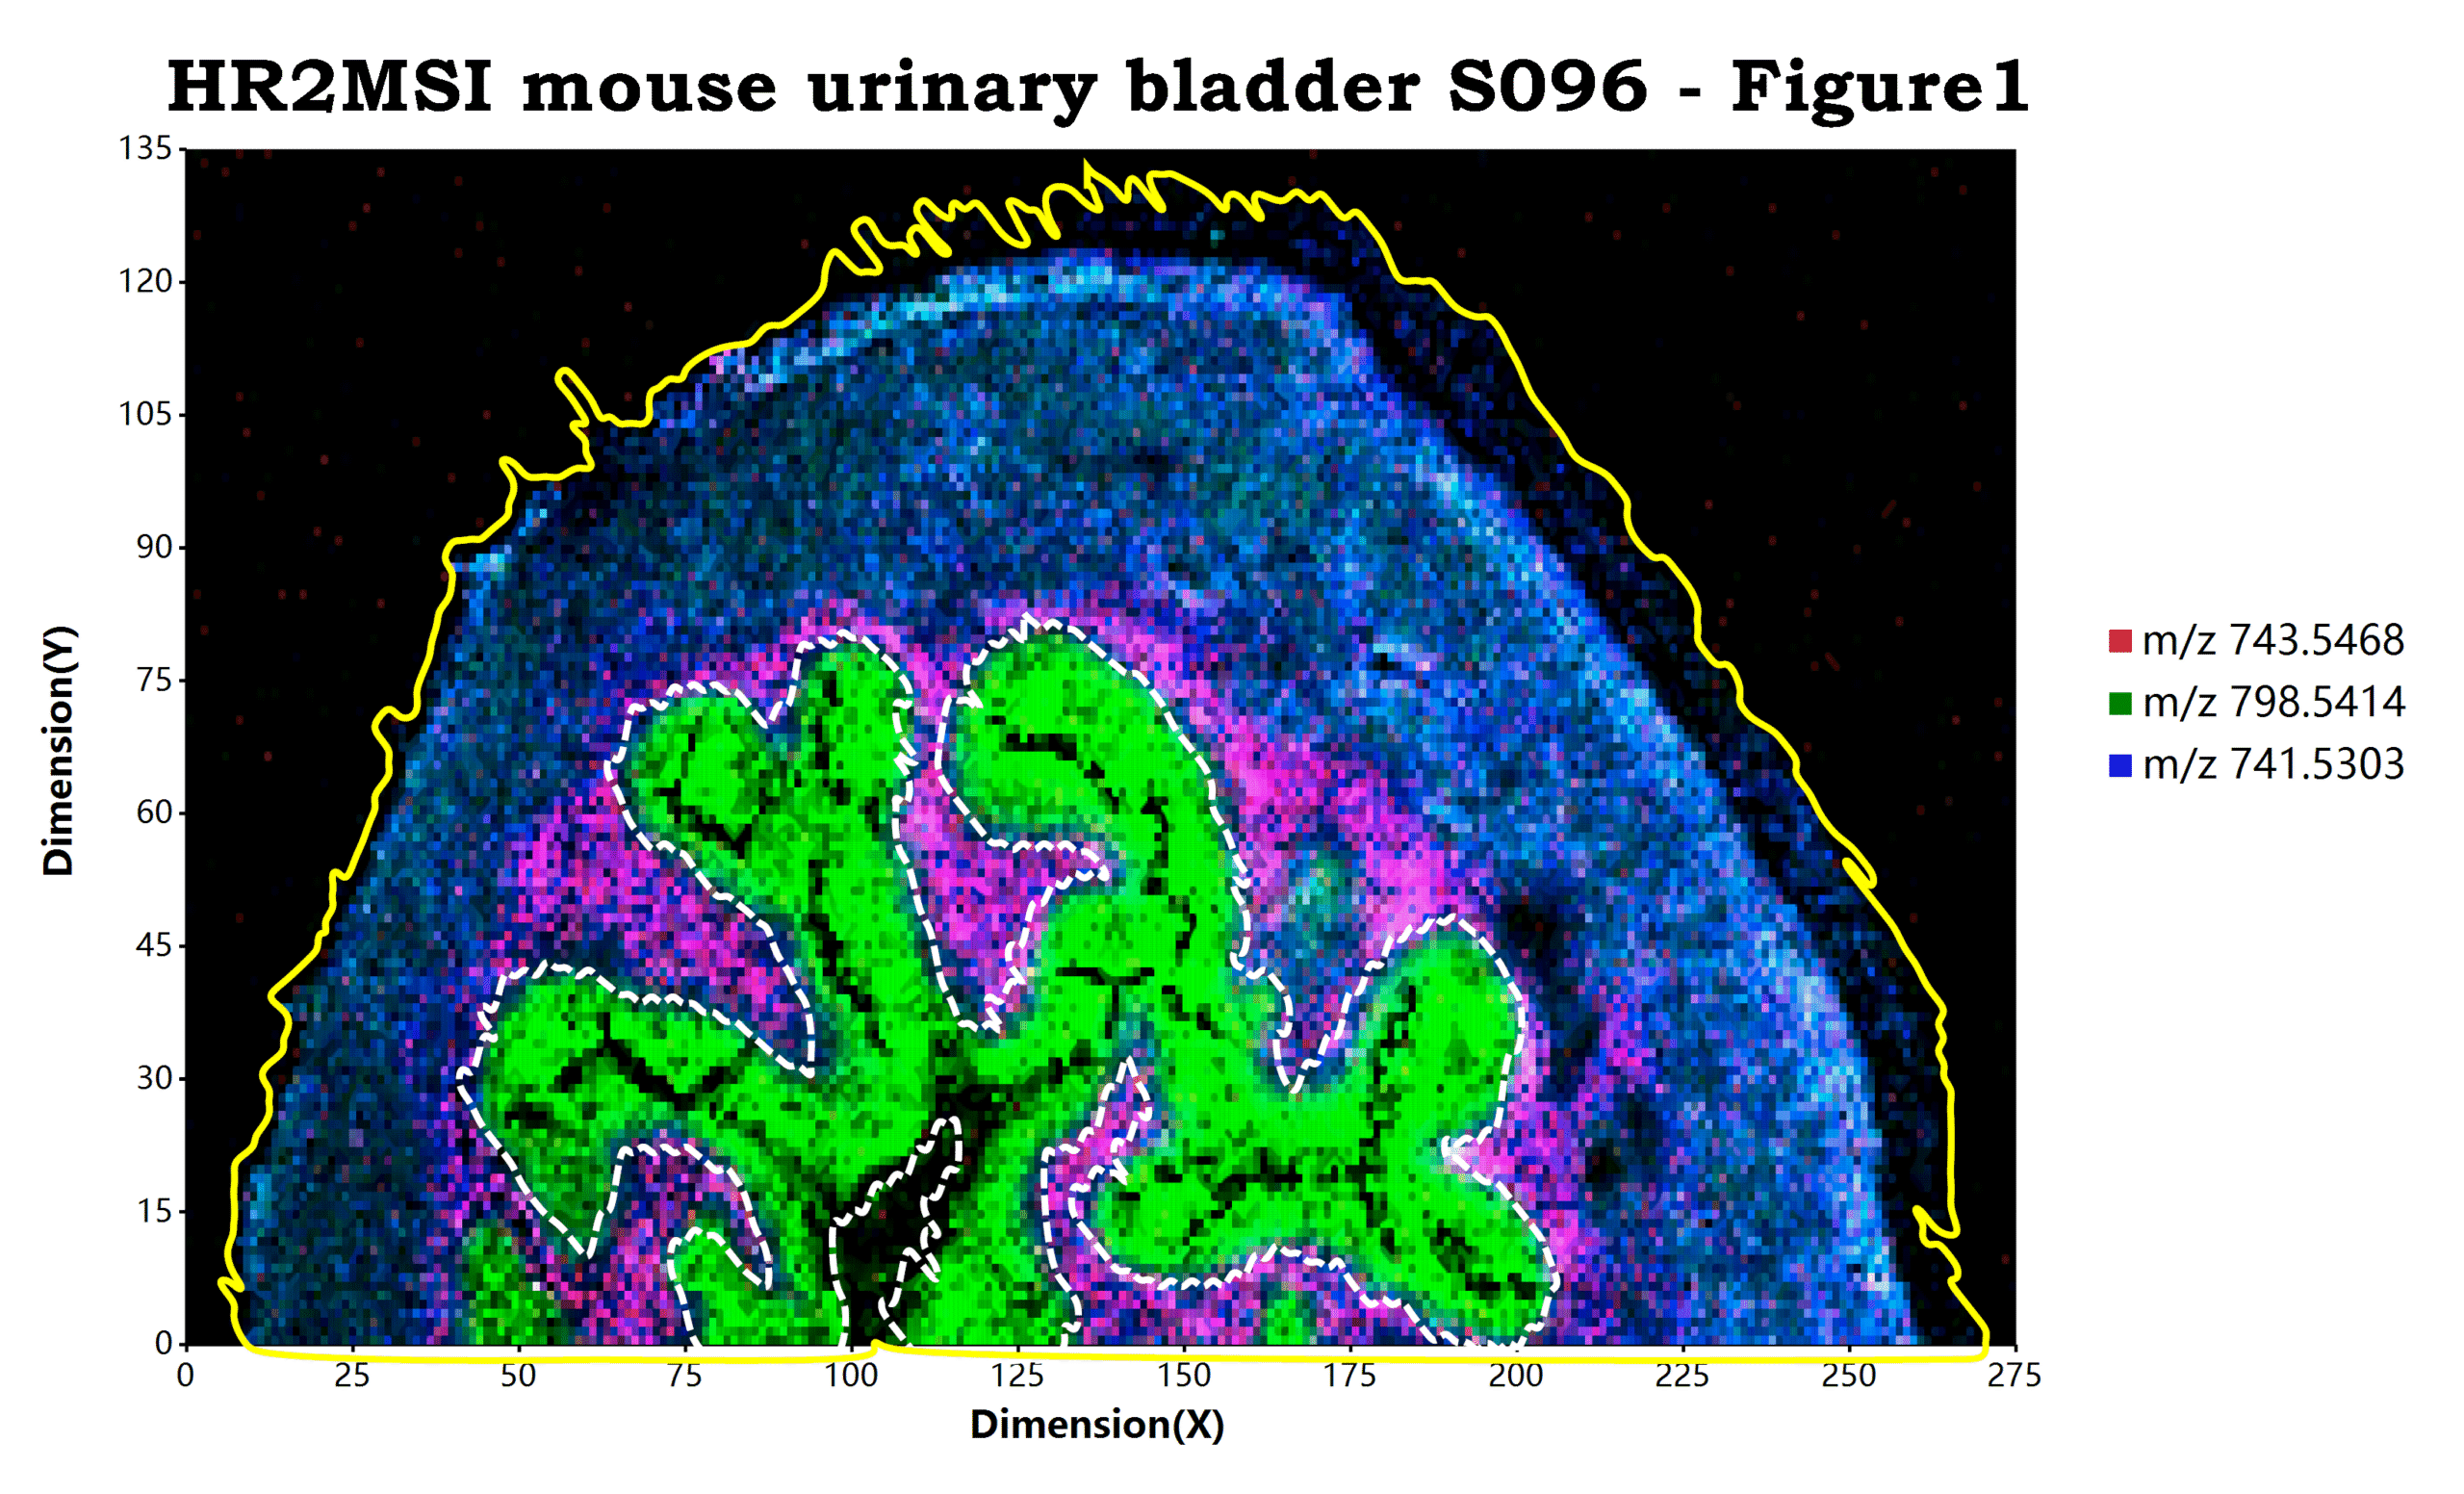
估计阅读时长: 10 分钟目前经过改进和优化之后的基于mzkit代码库底层的msimaging质谱成像软件包在样本可视化上进行了非常多的改进,诸如: 添加样本原始背景叠加 目前进行质谱成像可视化,程序包不仅仅可以使用任意rgb纯色来作为可视化的背景。目前还可以支持直接使用原始数据的背景作为质谱成像的显示背景。进行这个显示的秘诀就在于简单的在脚本中添加一个TIC背景图层:geom_MSIbackground("TIC") ggplot(msi_data, padding = "padding: 200px 600px 200px 250px;") + geom_MSIbackground("TIC") # rendering of […]
估计阅读时长: 8 分钟为了能够稳定的使用Ubuntu系统作为我的测试环境,我专门安装了Ubuntu的2404 LTS版本。但是发现虽然是LTS版本,仍然会因为系统更新而出现各种莫名奇妙的BUG。例如,在今天我为了安装软件,使用apt upgrade更新系统环境之后,出现了下面的消息:
估计阅读时长: 10 分钟 https://github.com/rsharp-lang/athena 在这博客篇文章中的Idea来自于最近进行AI Agent的开发:希望可以有一个方便的框架,能够让我像写普通的R#程序包的方式,为大语言模型编写对应的工具包,实现AI Agent功能。经过了大概一天的摸索,搞定了这样子的AI Agent的框架。我将这个框架取名为雅典娜系统。关于这个系统的名称,我们首先来看看DeepSeek是怎么说的: “我现在正在开发一个和大语言模型助手相关的工具,这个工具可以完成通过自然语言聊天的方式调用相应的工具完成生信数据分析,我需要为这个项目取一个名称,要求这个项目的名称应该是符合下面的需求的:女孩英文名称,和智慧相关的,和科学相关的。为我列举一些候选名称” 根据你的需求(女孩英文名、智慧与科学相关),结合搜索结果中的历史文化名人和寓意,以下是推荐的候选名称及来源解析: 名字 寓意 关联 Athena 源自希腊神话的智慧女神,象征智慧与科学战略。 雅典娜不仅是智慧化身,也代表理性思维,适合强调数据分析与策略的项目。 Clara 拉丁语“明亮、清晰”,象征清晰的科学思维。 […]
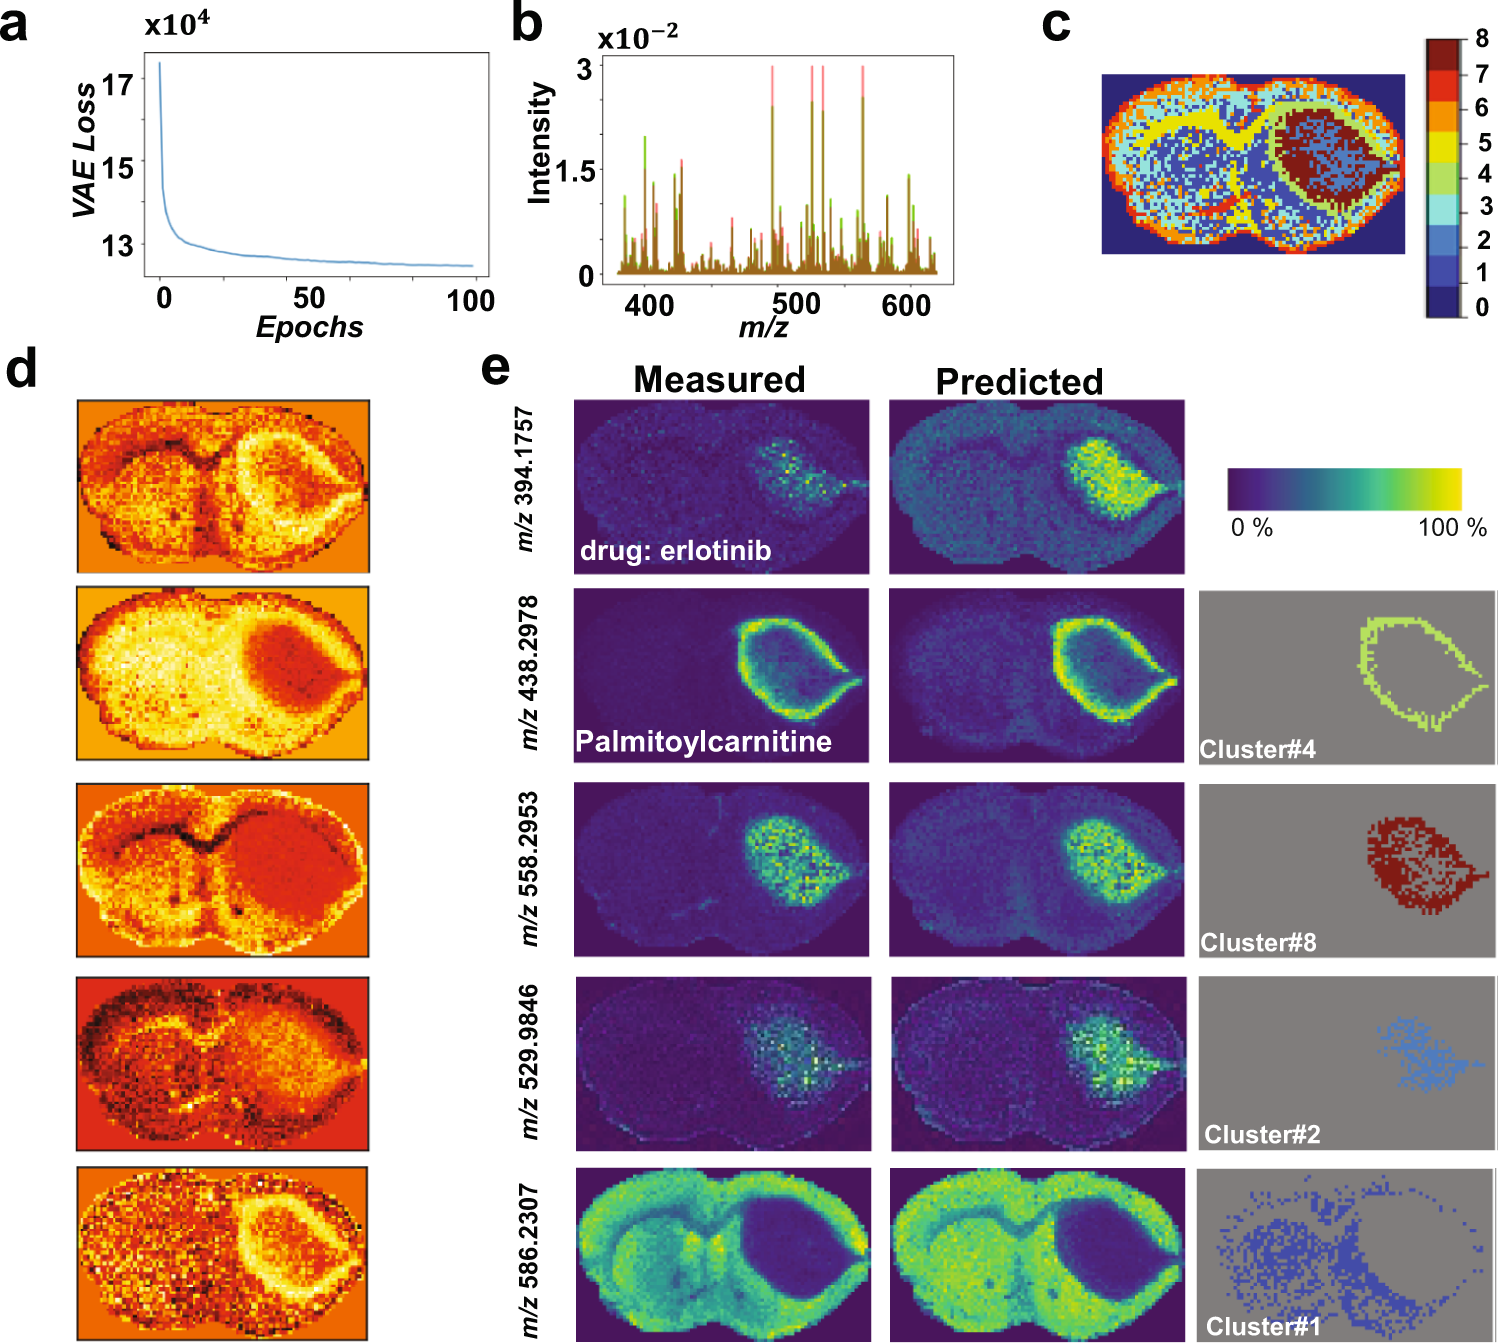
估计阅读时长: 4 分钟基于UMAP工具进行简单的自动化组织分区操作 在这里我们假设已经可以正常的将空间代谢数据导入至MZKit工作站软件之中。假若需要借助于MZKit工作站软件进行切片组织样本的自动化分区操作,相关的功能可以在【MSI Analysis】菜单栏中寻找到。在这里我们打开【Show Map Layer】按钮,选择【UMAP and clustering】功能。 基于降维的组织自动化分区原理 因为降维操作一般是一种特征提取操作,所以经过降维之后,在高维度空间上无法显现的特征,在低维度会呈现出来。在高维度空间散落的相近的数据点,在经过特征提取之后,低维度上会产生相似的特征信息,相互聚集在一簇。这样子我们就可以在低维度空间上通过一些聚类算法讲这些特征进行聚类,最后将聚类特征结果标记到各个散点上的对应的原始成像空间上,我们就可以看见组织分区的结果了。 Abdelmoula, W.M., Lopez, B.GC., Randall, E.C. et […]

代谢组学那堆名词我上次查资料时也手抄过一页,QC 样本、保留时间、m/z 这些混在一张表里,来回对照着看特别费劲。你这篇把英文缩写和中文解释排在一起,省了我不少翻文献的功夫,尤其是代谢物鉴定那几段。
文中提出的"能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢?"让我想到一个需要先厘清的问题:把Family层级的分类当作细胞分群标签时,功能相似性与亲缘关系可能会混在一起,图上的聚集未必能直接解释为代谢功能接近。如果借用单细胞分析中的降维流程,是否可以同时标注物种分类和基因组注释完整度,看看分离主要对应哪一种差异?尤其是这里用的是EC注释的TF-IDF矩阵,缺少某项注释究竟代表功能缺失还是未被识别,也可能影响对分群结果的判断。
这个角度之前没想到,零分布原理及其在生物信息学中的应用 确实值得深入了解。刚好之前看过,可以对照着看看。
Greetings! I stumbled upon this really useful site and figured I'd thanks for you post at here.
This content speaks to hearts