
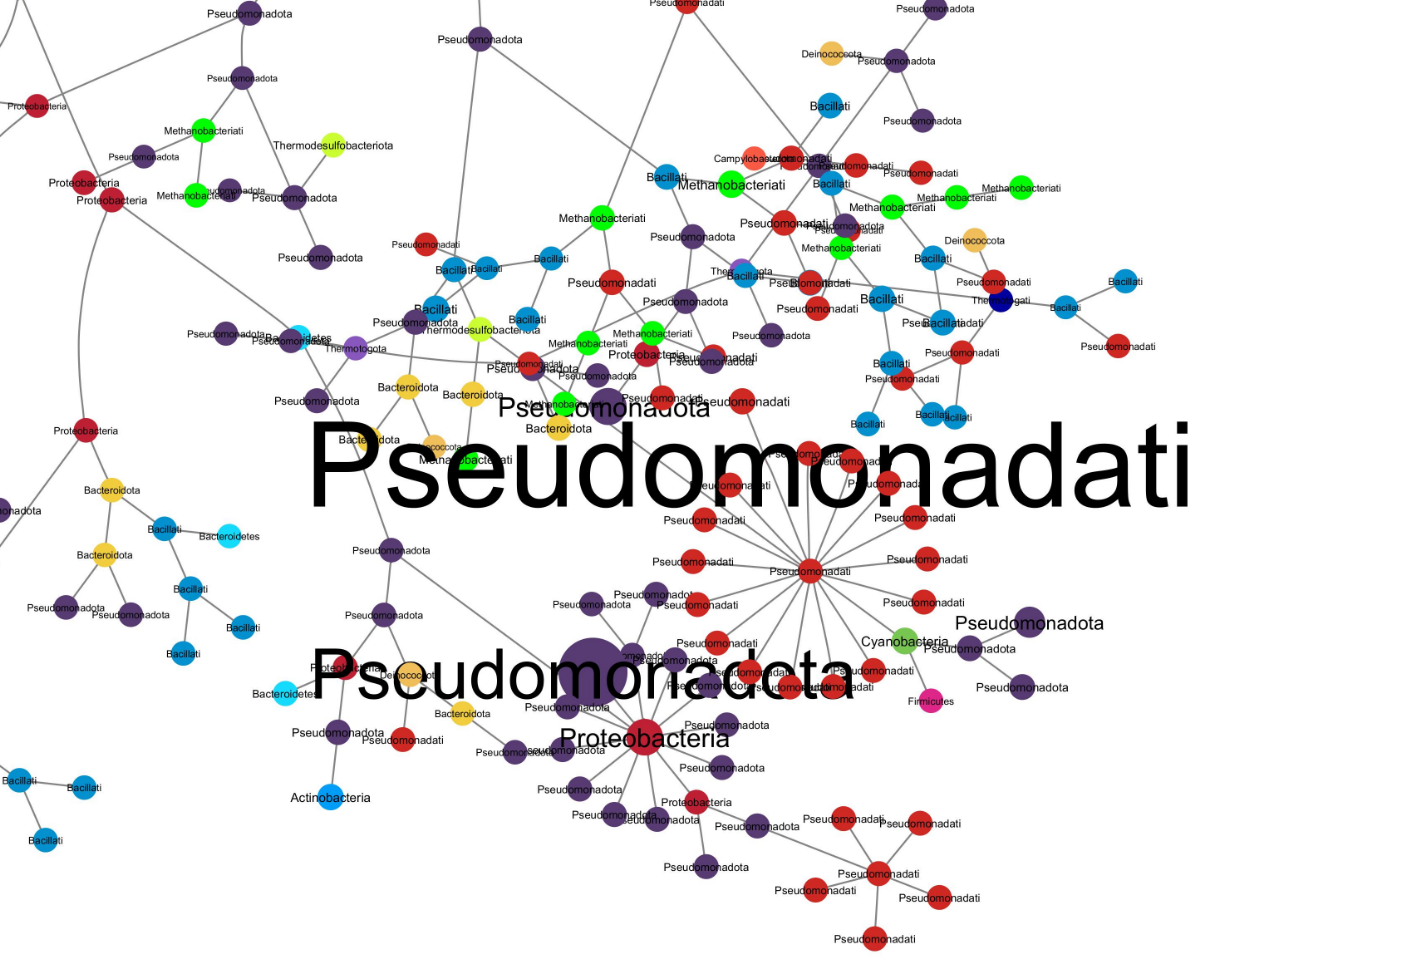
估计阅读时长: 18 分钟在前面的一篇《基因组功能注释(EC Number)的向量化嵌入》博客文章中,针对所注释得到的微生物基因组代谢信息,进行基于TF-IDF的向量化嵌入之后。为了可视化向量化嵌入的效果,通过UMAP进行降维,然后基于降维的结果进行散点图可视化。通过散点图可视化可以发现向量化的嵌入结果可以比较好的将不同物种分类来源的微生物基因组区分开来。除了针对降维后的数据进行散点图可视化,我们还可以直接针对向量化嵌入后的原始嵌入矩阵进行聚类,完成聚类结果的可视化。在这里我们主要是基于嵌入的原始结果进行二叉树聚类可视化。
估计阅读时长: < 1 分钟UPGMA(Unweighted Pair Group Method with Arithmetic Mean,非加权配对组平均法)是一种经典的基于距离矩阵构建系统发育树的聚类算法。其核心思想是假设进化速率恒定(分子钟假说),通过迭代合并距离最近的两个类群(或序列)来构建树。UPGMA算法具有原理简单,计算速度快,易于理解和实现。对于符合分子钟假说(即所有分支进化速率相同)的数据,能给出正确的拓扑结构这些优点。但是其“进化速率恒定”的假设在现实中常常不成立。如果数据存在明显的速率差异(即存在长枝),UPGMA可能会构建出错误的树(拓扑结构错误)。因此,它更适用于进化速率相对均匀的近缘物种或基因的比较。
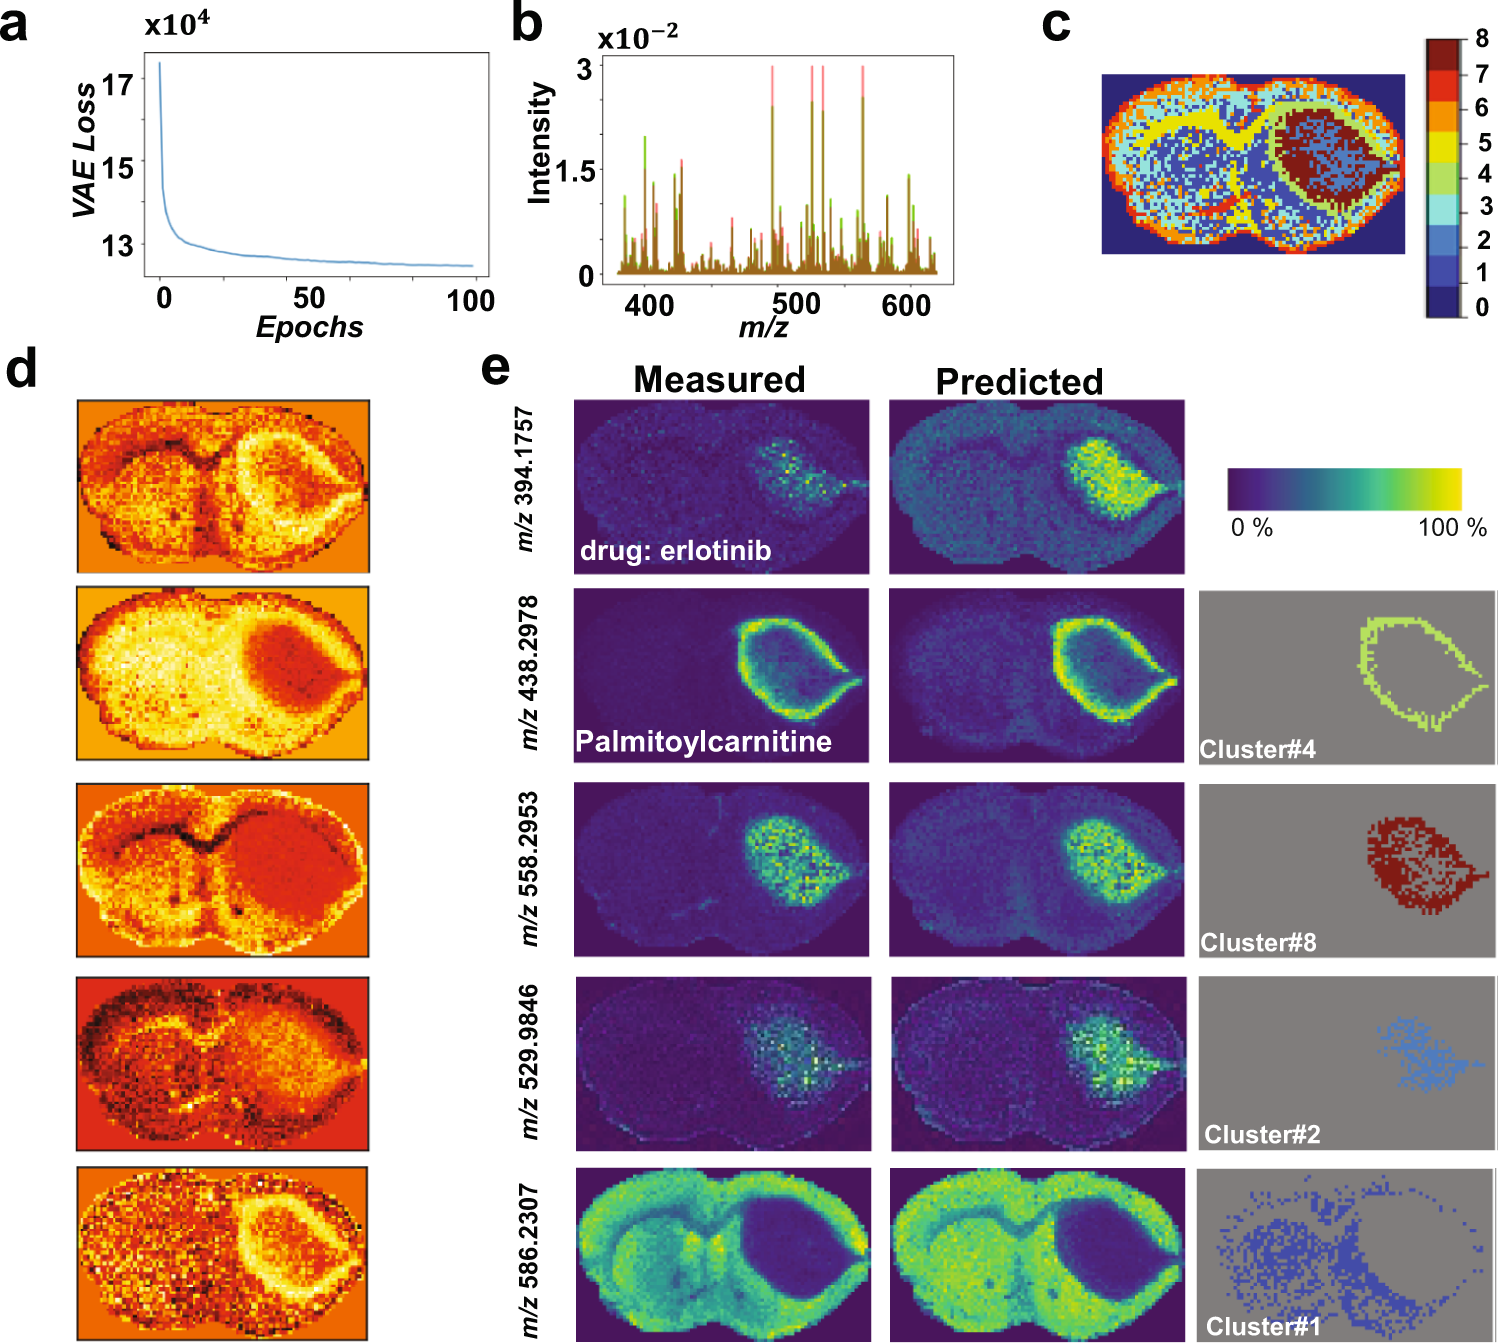
估计阅读时长: 4 分钟基于UMAP工具进行简单的自动化组织分区操作 在这里我们假设已经可以正常的将空间代谢数据导入至MZKit工作站软件之中。假若需要借助于MZKit工作站软件进行切片组织样本的自动化分区操作,相关的功能可以在【MSI Analysis】菜单栏中寻找到。在这里我们打开【Show Map Layer】按钮,选择【UMAP and clustering】功能。 基于降维的组织自动化分区原理 因为降维操作一般是一种特征提取操作,所以经过降维之后,在高维度空间上无法显现的特征,在低维度会呈现出来。在高维度空间散落的相近的数据点,在经过特征提取之后,低维度上会产生相似的特征信息,相互聚集在一簇。这样子我们就可以在低维度空间上通过一些聚类算法讲这些特征进行聚类,最后将聚类特征结果标记到各个散点上的对应的原始成像空间上,我们就可以看见组织分区的结果了。 Abdelmoula, W.M., Lopez, B.GC., Randall, E.C. et […]

估计阅读时长: 24 分钟假若现在有两条Fasta序列放在你面前,现在需要你进行这两条Fasta序列的相似度计算分析。如果对于我而言,大学刚毕业刚入门生物信息学的时候,可能只能够想到通过blast比对的方式进行序列相似性计算分析。基于blast比对方式可以找到生物学意义上的序列相似性结果,但是计算的效率会比较低。假设现在让你使用这些序列进行机器学习建模分析,或者基于传统数学意义上的基于相似度的无监督聚类分析的时候,面对这些长度上长短不一的生物序列数据,可能会比较蒙圈,因为传统的数学分析方法都要求我们分析的目标至少应该是等长的向量数据。
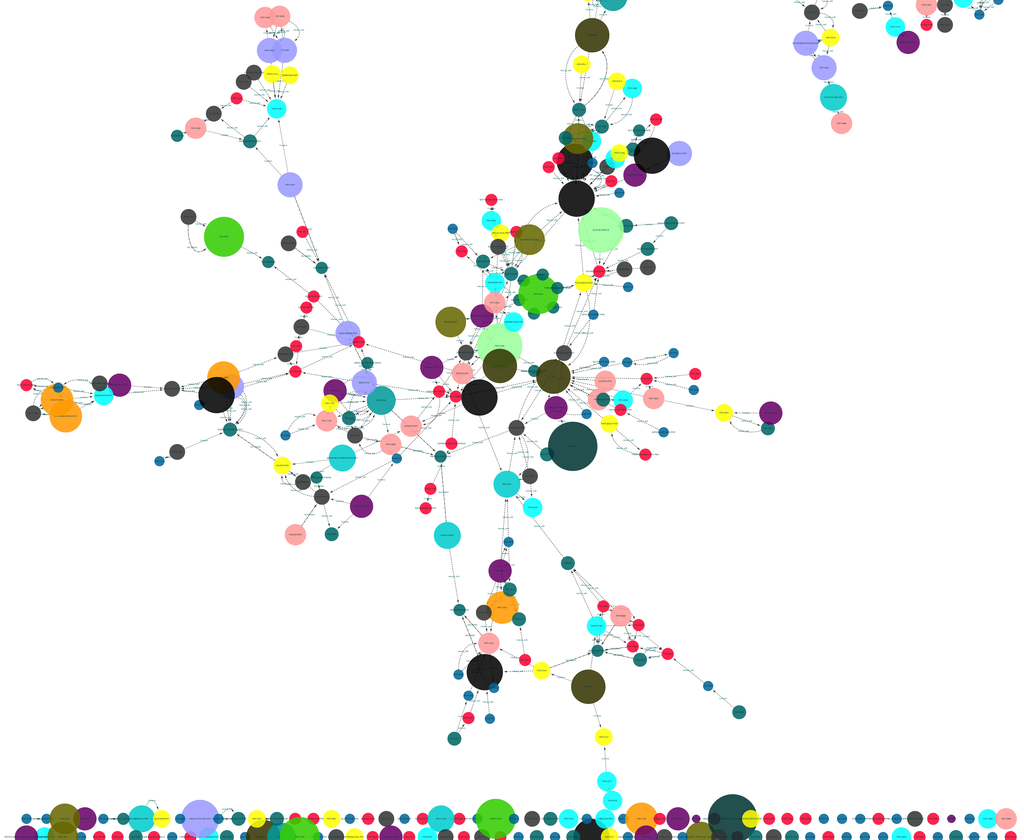
估计阅读时长: 7 分钟一般而言,进行全基因组的转录表达调控网络的建立,我们需要基于两个数据结果来完成: 目标基因的转录调控位点信息(Motif搜索结果,构成网络之中的节点) 转录调控位点相应的转录调控因子(Motif位点相关的转录调控因子,构成网络之中的边连接)
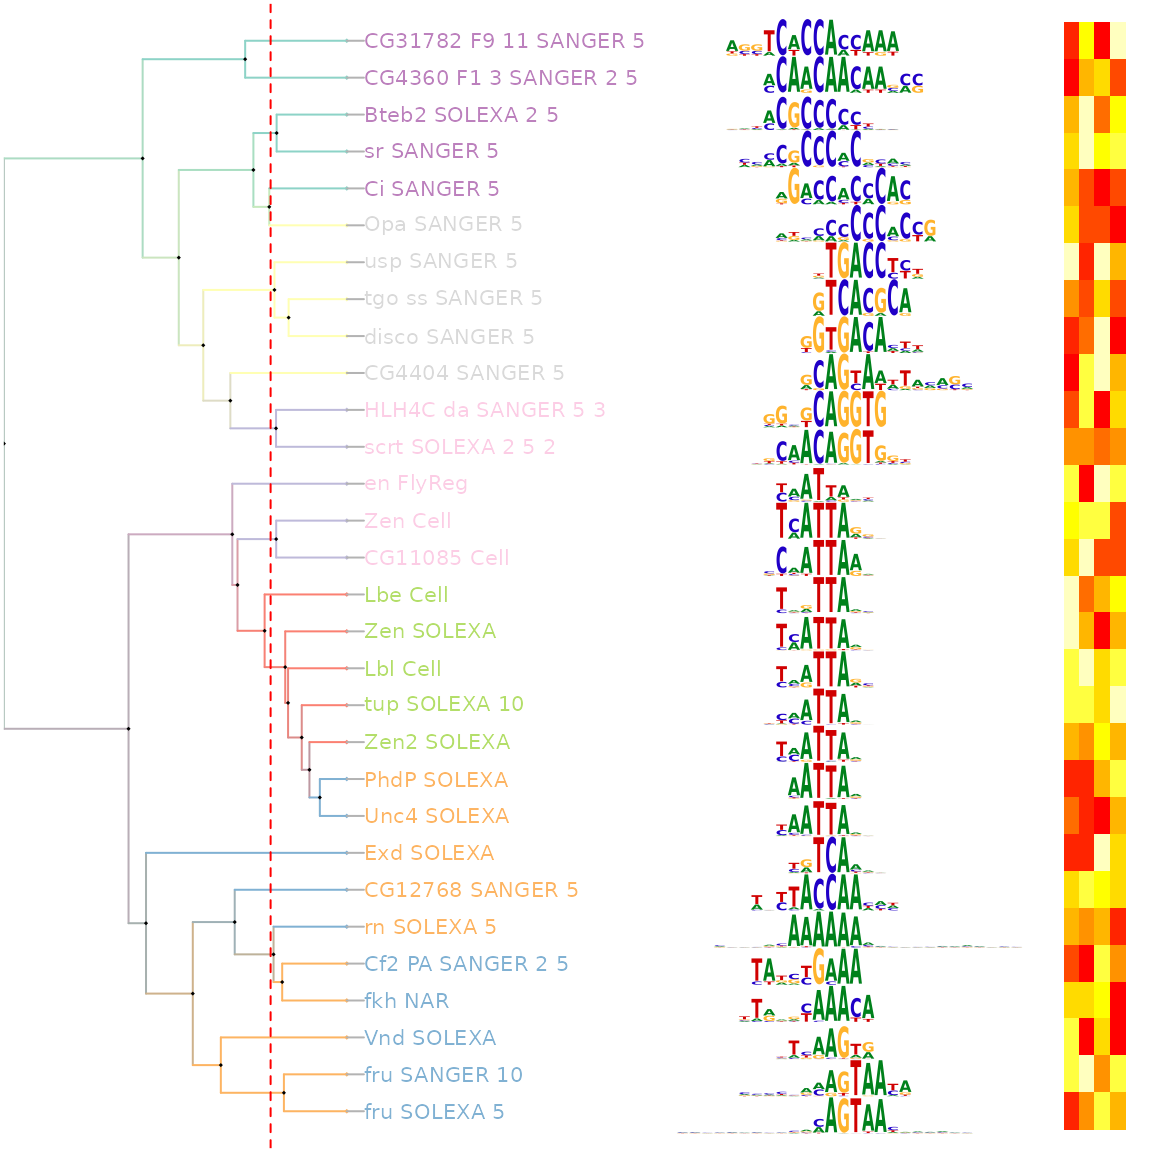
估计阅读时长: 12 分钟Motif是一段典型的序列或者一个结构。一般情况下是指构成任何一种特征序列的基本结构。通俗来讲,即是有特征的短序列,一般认为它是拥有生物学功能的保守序列,可能包含特异性的结合位点,或者是涉及某一个特定生物学过程的有共性的序列区段。比如蛋白质的序列特异性结合位点,如核酸酶和转录因子。
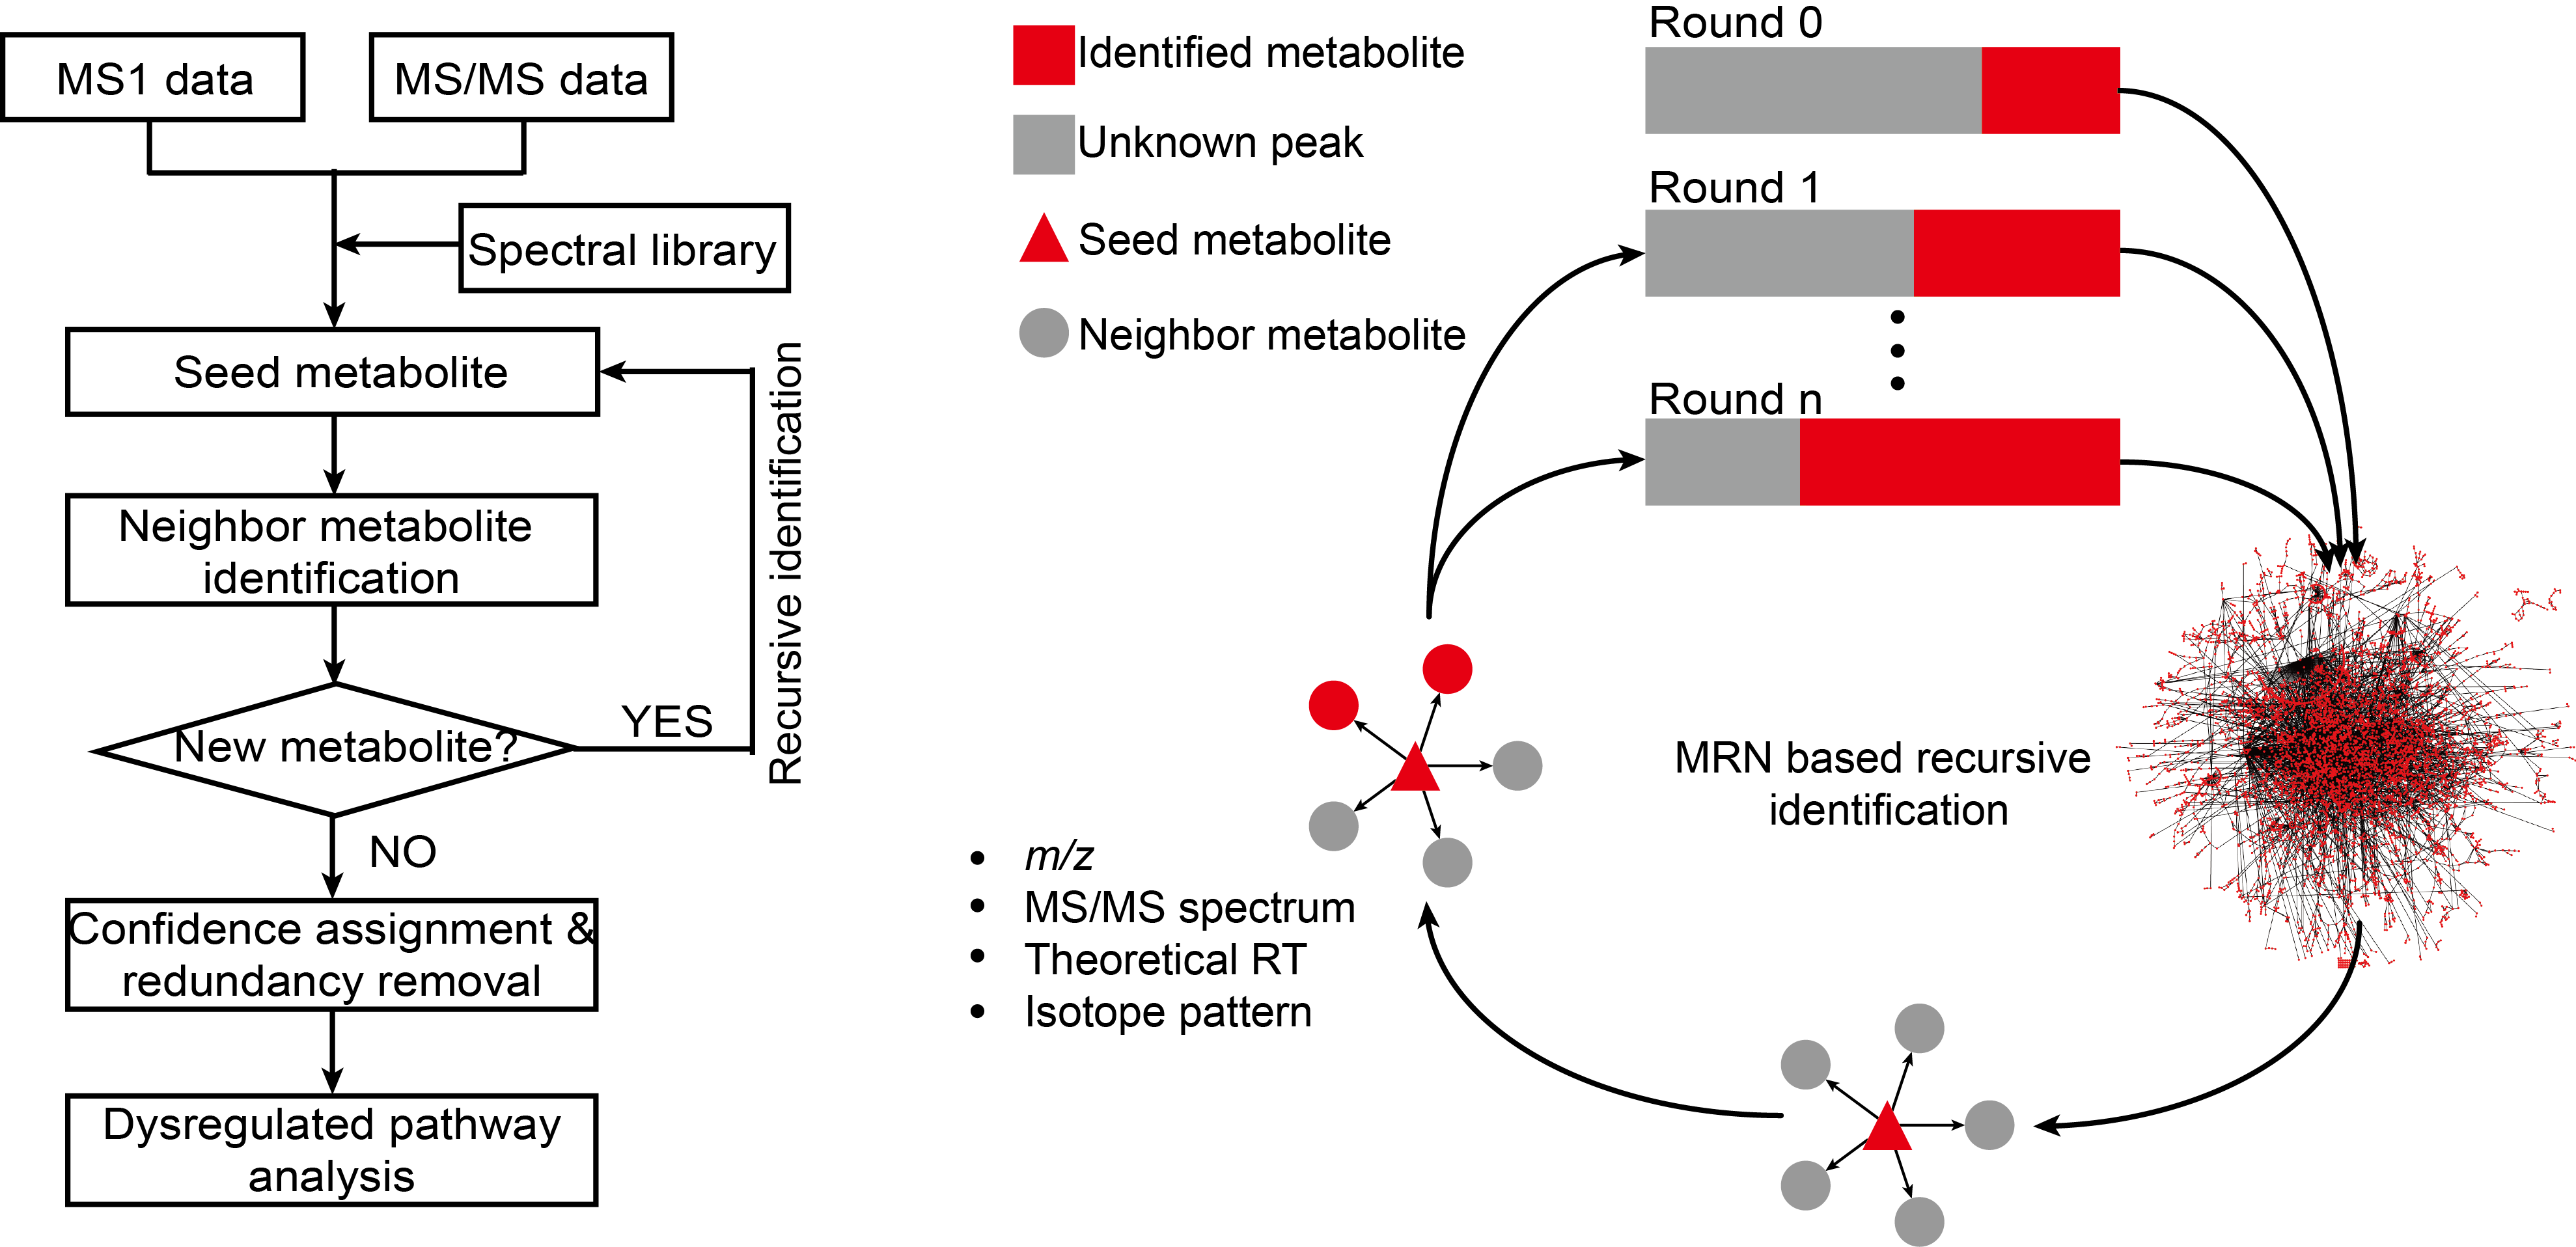
估计阅读时长: 6 分钟访问在线服务: http://metdna.zhulab.cn/ Metabolite identification is the long-standing challenge for liquid chromatography-mass spectrometry (LC-MS)-based untargeted metabolomics. Here, […]
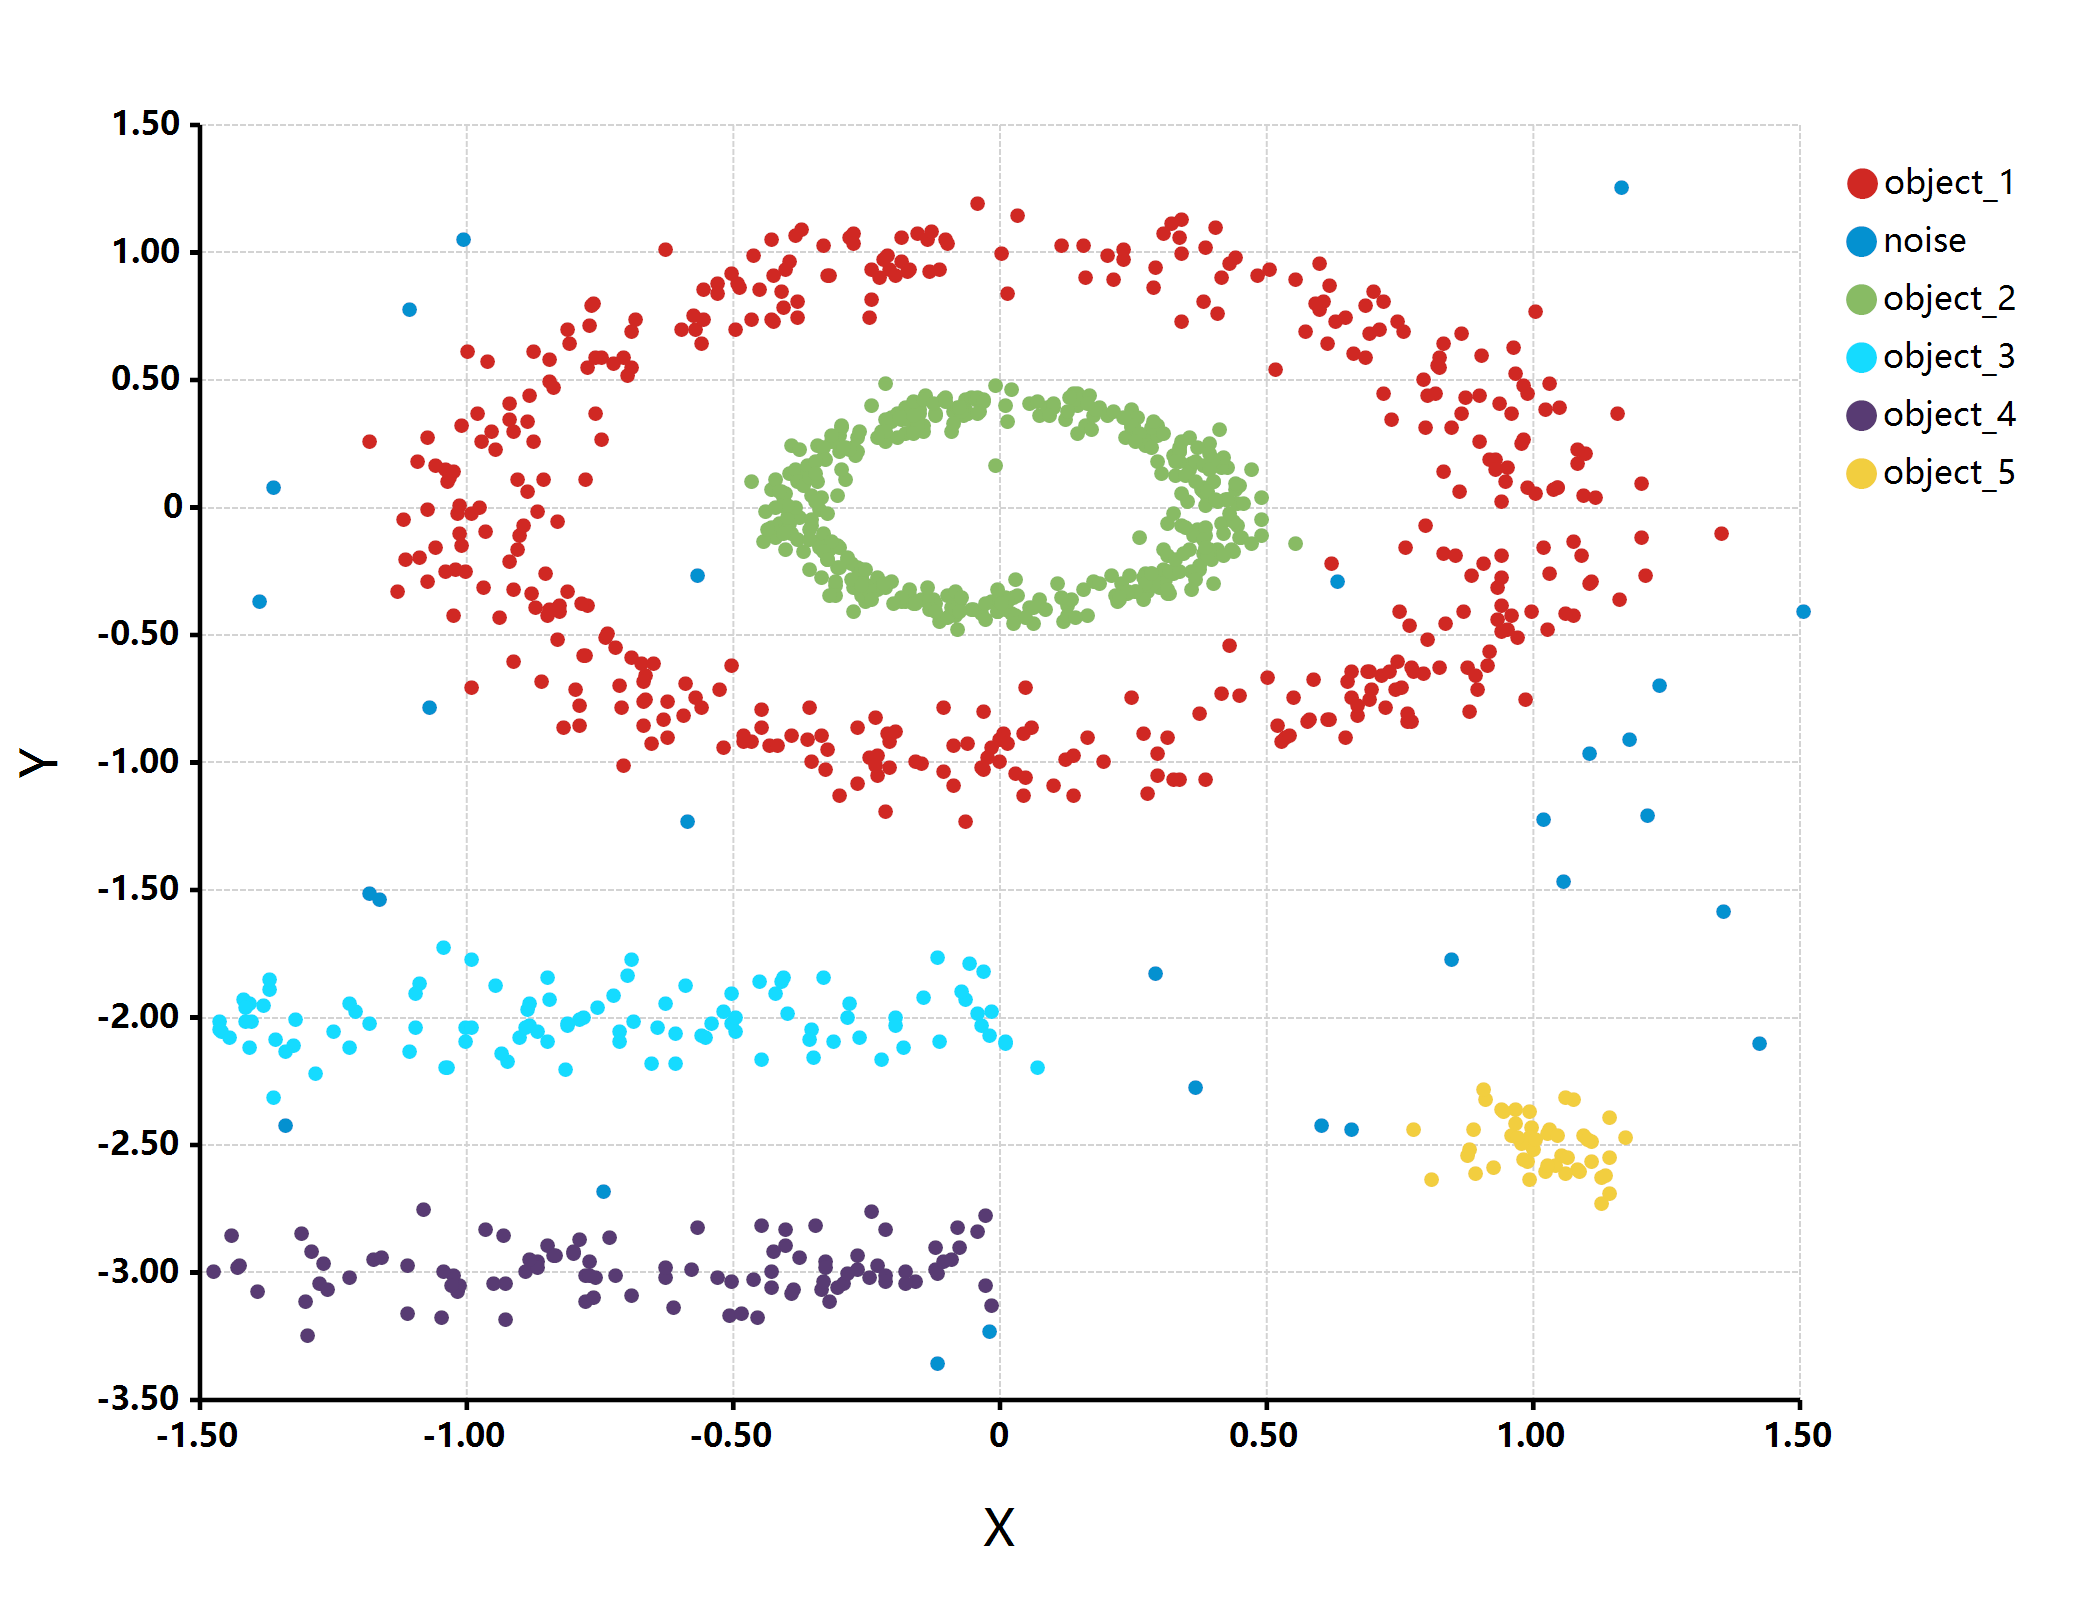
估计阅读时长: 2 分钟imports "clustering" from "MLkit"; require(graphics2D); multishapes = read.csv("./multishapes.csv"); [x, y] = list(multishapes[, "x"], multishapes[, "y"]); print(multishapes, […]
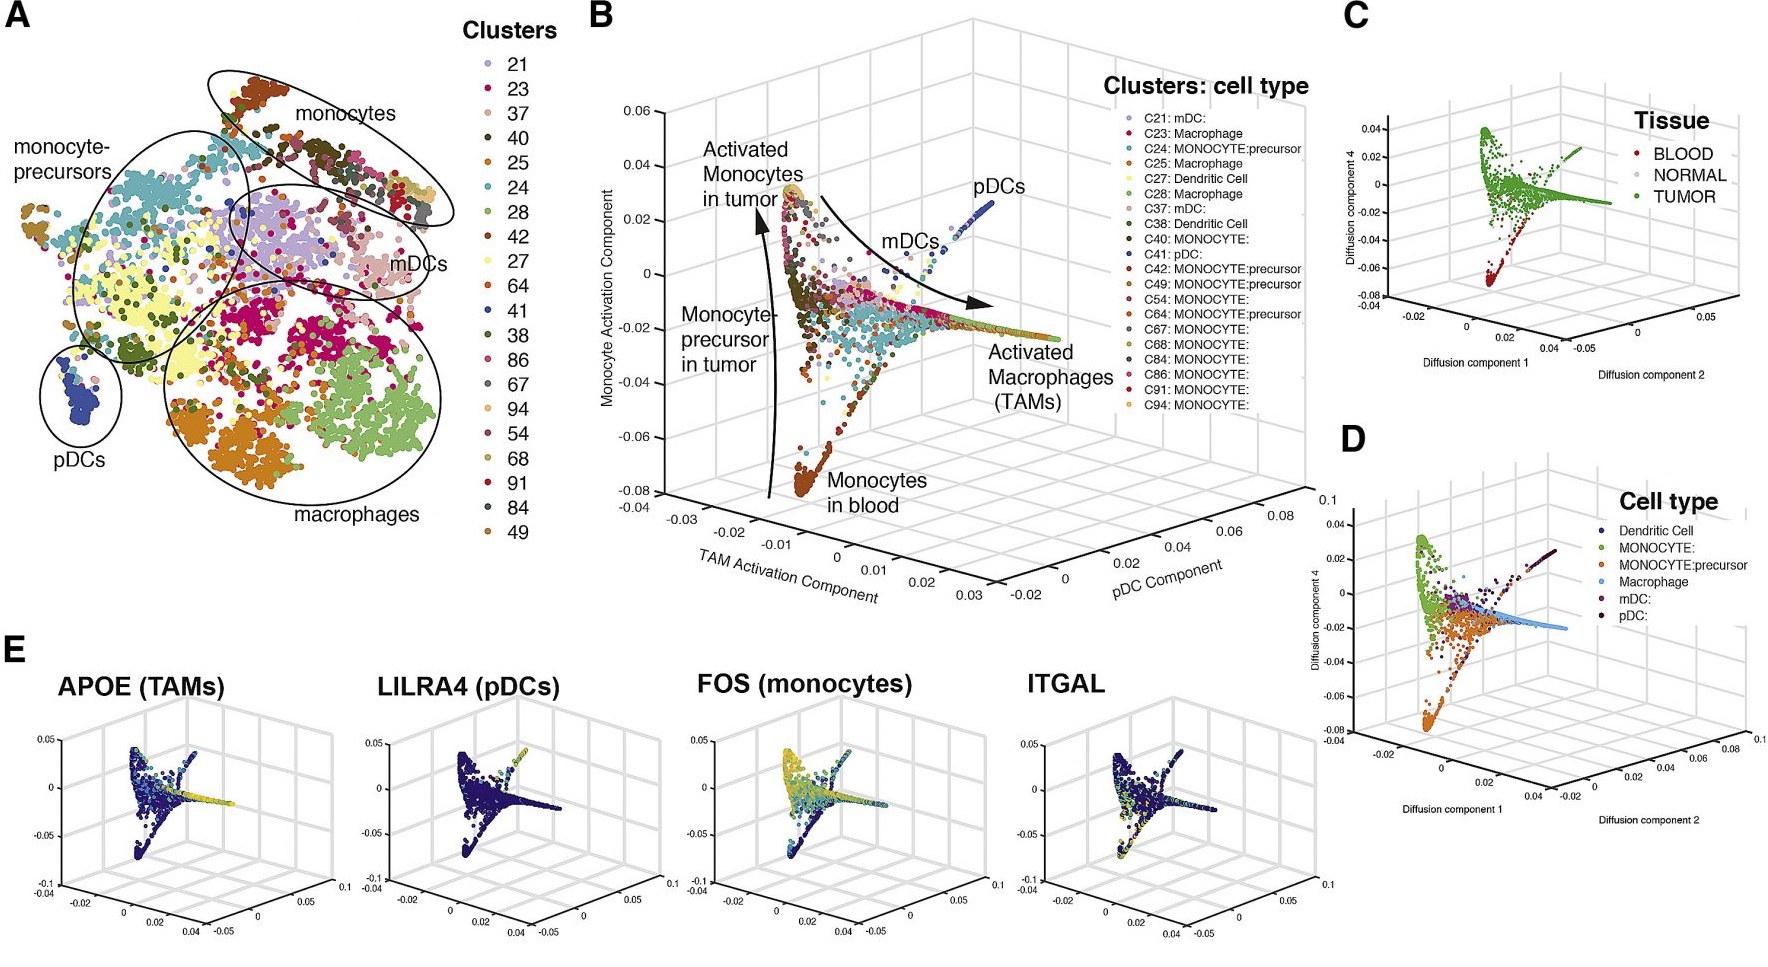
估计阅读时长: 14 分钟https://github.com/rsharp-lang/ggplot 之前在阅读一篇单细胞组学数据分析的文献,觉得在文献之中有一些三维散点图用于展示降维聚类结果的效果非常的好看。于是自己在R#语言之中的ggplot程序包的2D绘图的功能基础之上,进行了三维图形数据可视化功能的开发。 (A) t-SNE map projecting myeloid cells from BC1-8 patients (all tissues). Cells are colored […]
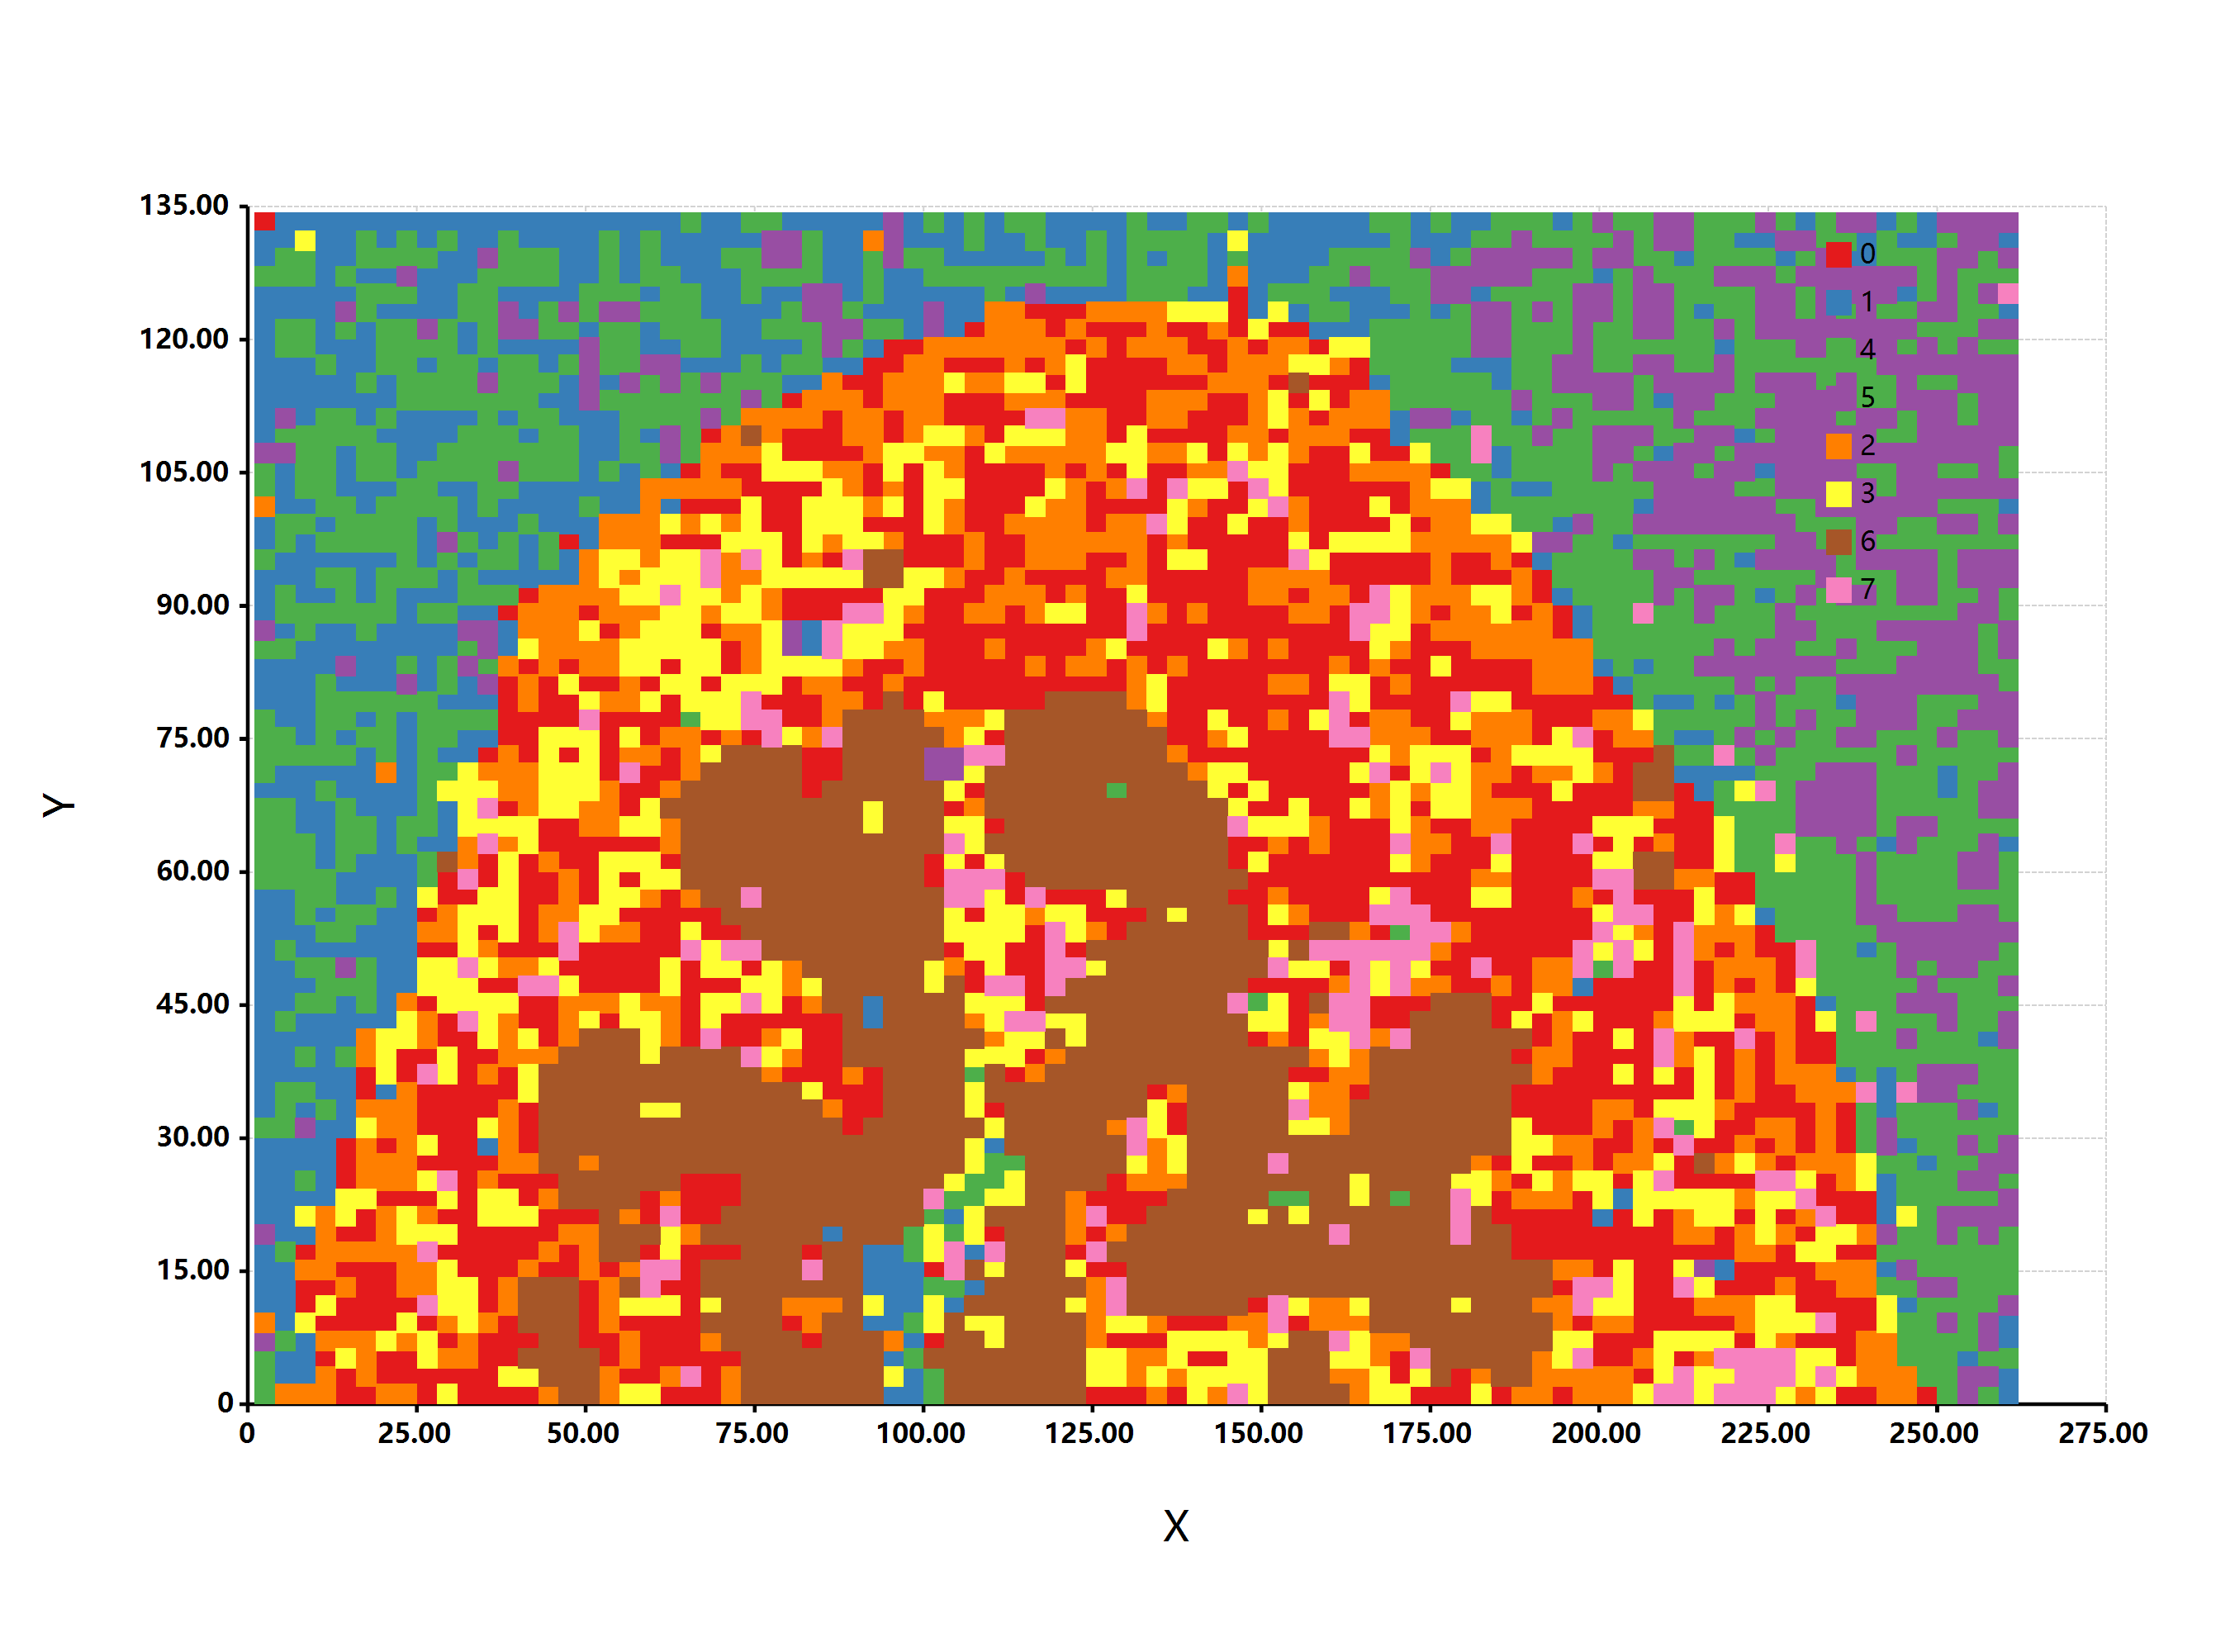
估计阅读时长: 15 分钟https://gcmodeller.org 在这篇博客文章之中,我主要是来详细介绍一下是如何从头开始实现Phenograph单细胞分型算法的。在之前的一篇博客文章《【单细胞组学】PhenoGraph单细胞分型》之中,我们介绍了Phenograph算法的简单原理,以及一个在R语言之中所实现的Phenograph算法的程序包Rphenograph。在这里我主要是详细介绍在GCModeller软件之中所实现的VisualBasic语言版本的Phenograph单细胞分型算法。

代谢组学那堆名词我上次查资料时也手抄过一页,QC 样本、保留时间、m/z 这些混在一张表里,来回对照着看特别费劲。你这篇把英文缩写和中文解释排在一起,省了我不少翻文献的功夫,尤其是代谢物鉴定那几段。
文中提出的"能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢?"让我想到一个需要先厘清的问题:把Family层级的分类当作细胞分群标签时,功能相似性与亲缘关系可能会混在一起,图上的聚集未必能直接解释为代谢功能接近。如果借用单细胞分析中的降维流程,是否可以同时标注物种分类和基因组注释完整度,看看分离主要对应哪一种差异?尤其是这里用的是EC注释的TF-IDF矩阵,缺少某项注释究竟代表功能缺失还是未被识别,也可能影响对分群结果的判断。
这个角度之前没想到,零分布原理及其在生物信息学中的应用 确实值得深入了解。刚好之前看过,可以对照着看看。
Greetings! I stumbled upon this really useful site and figured I'd thanks for you post at here.
This content speaks to hearts