
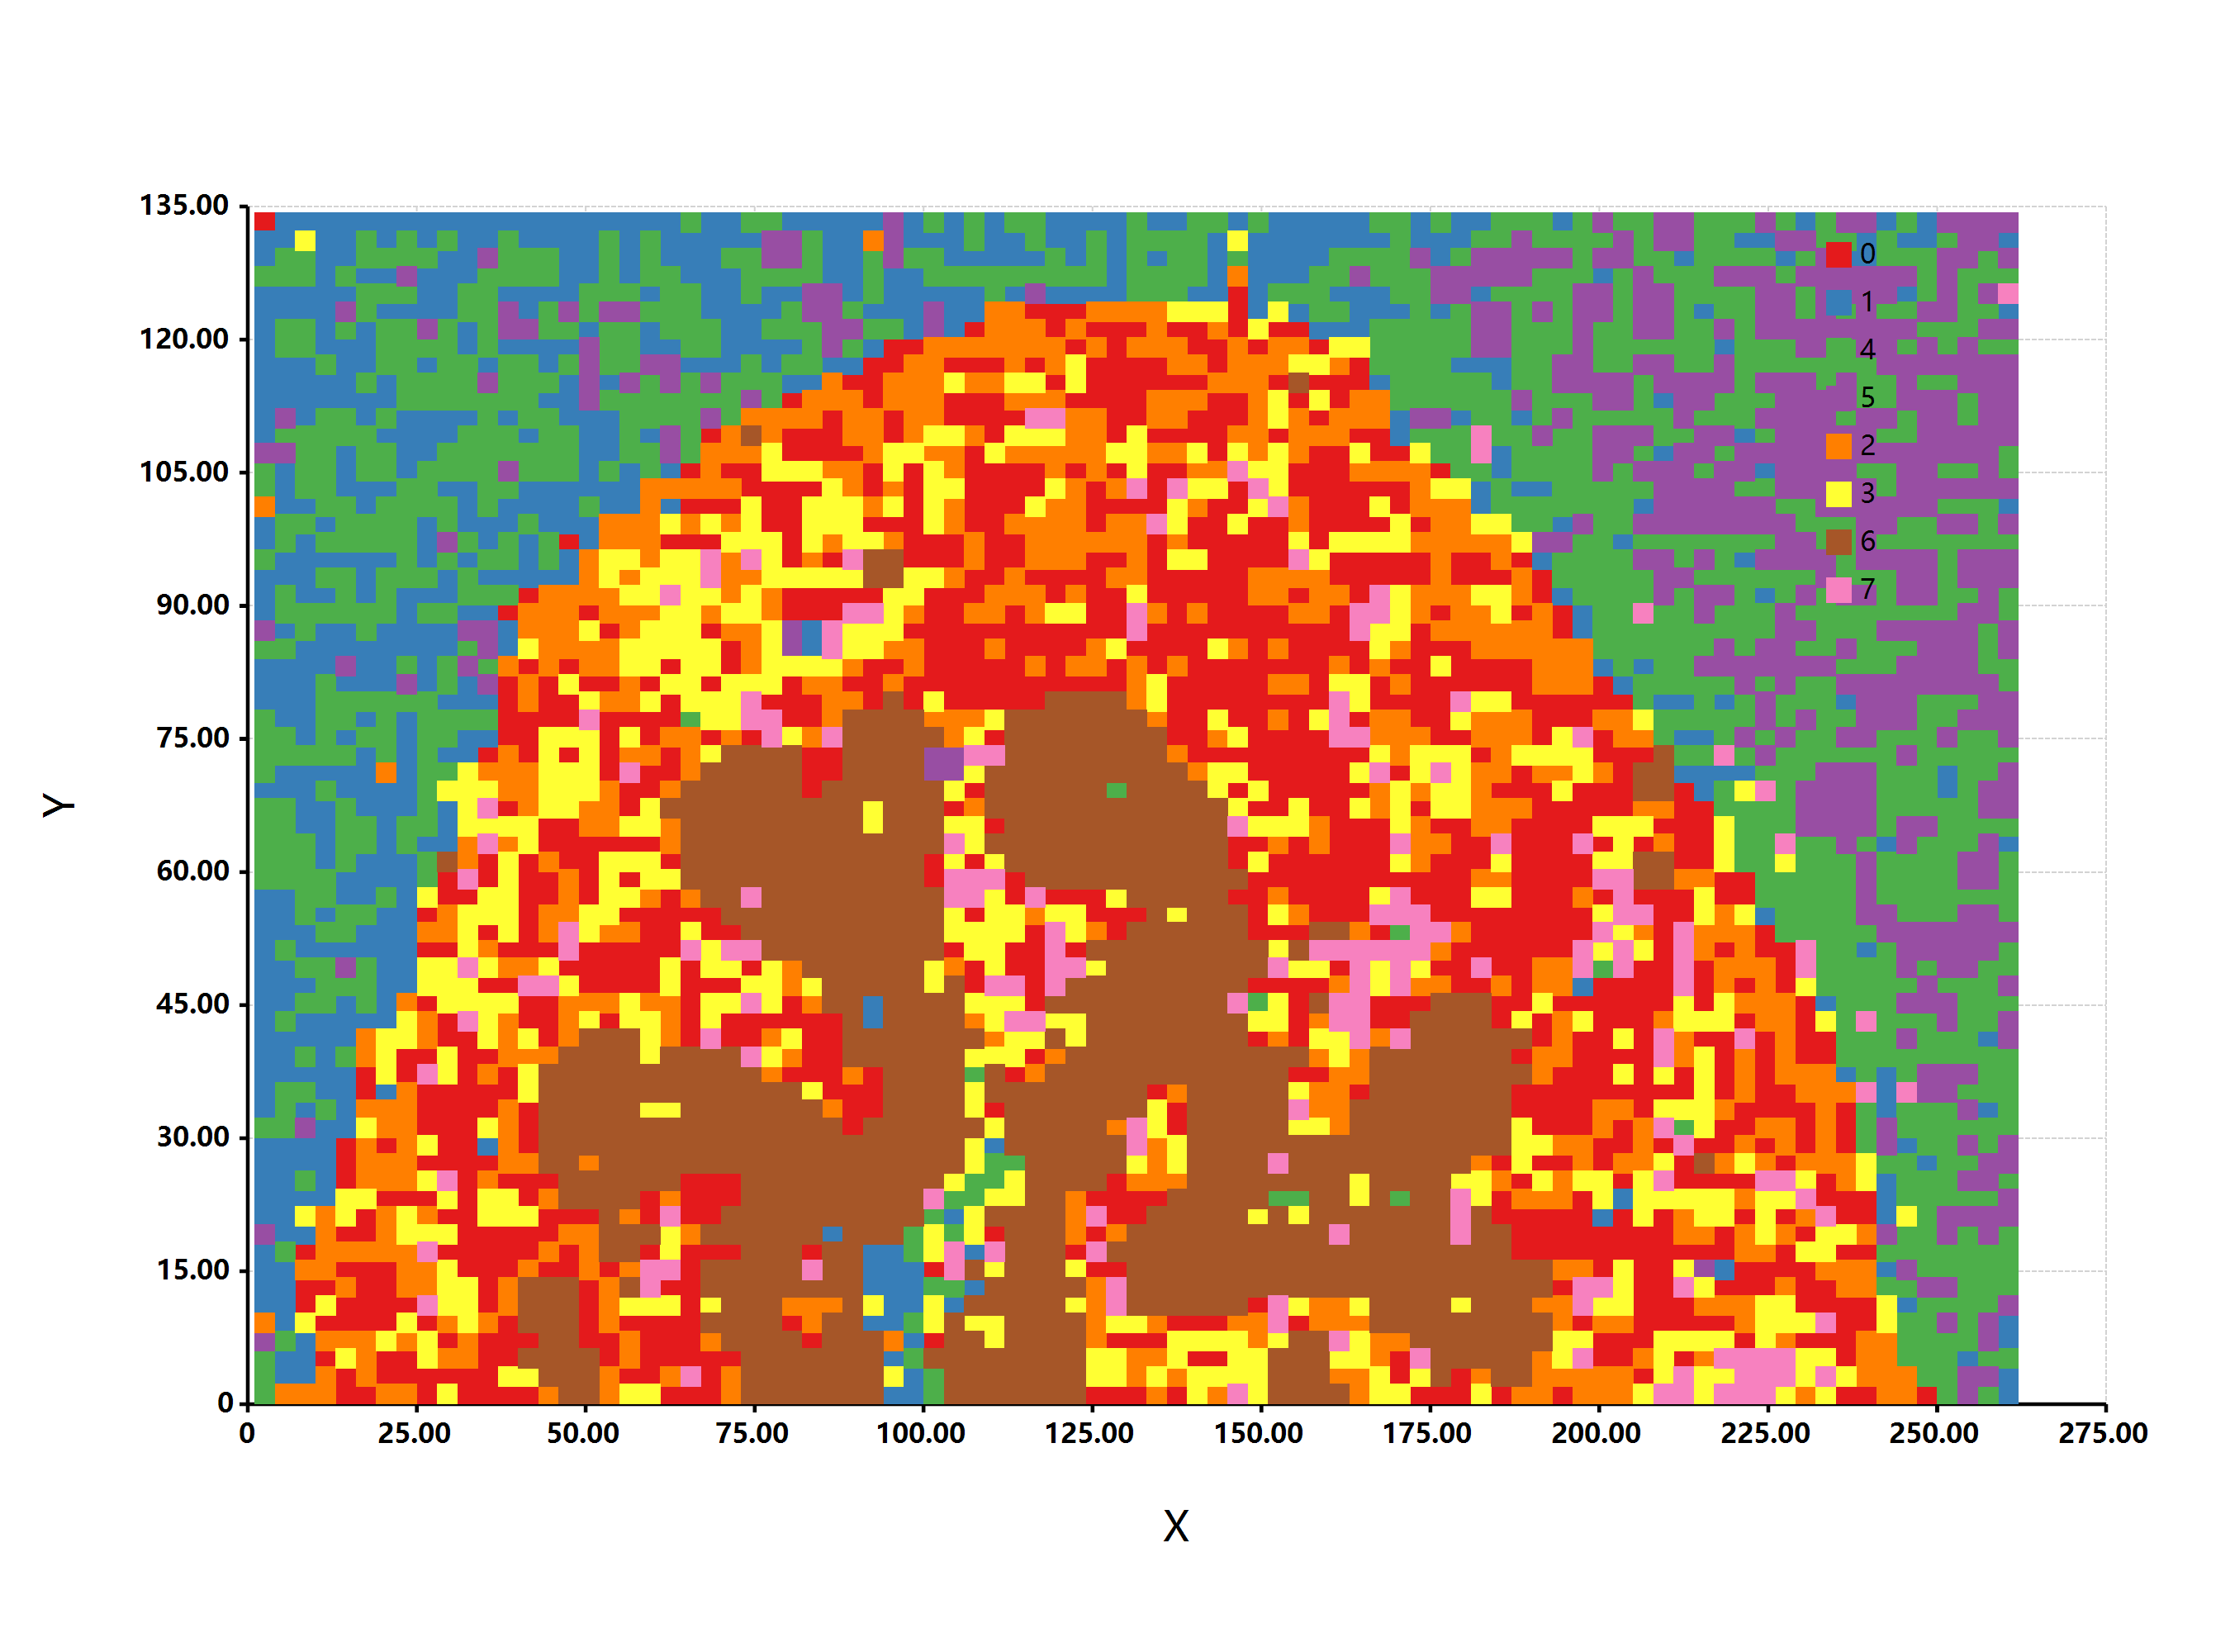
估计阅读时长: 15 分钟https://gcmodeller.org 在这篇博客文章之中,我主要是来详细介绍一下是如何从头开始实现Phenograph单细胞分型算法的。在之前的一篇博客文章《【单细胞组学】PhenoGraph单细胞分型》之中,我们介绍了Phenograph算法的简单原理,以及一个在R语言之中所实现的Phenograph算法的程序包Rphenograph。在这里我主要是详细介绍在GCModeller软件之中所实现的VisualBasic语言版本的Phenograph单细胞分型算法。
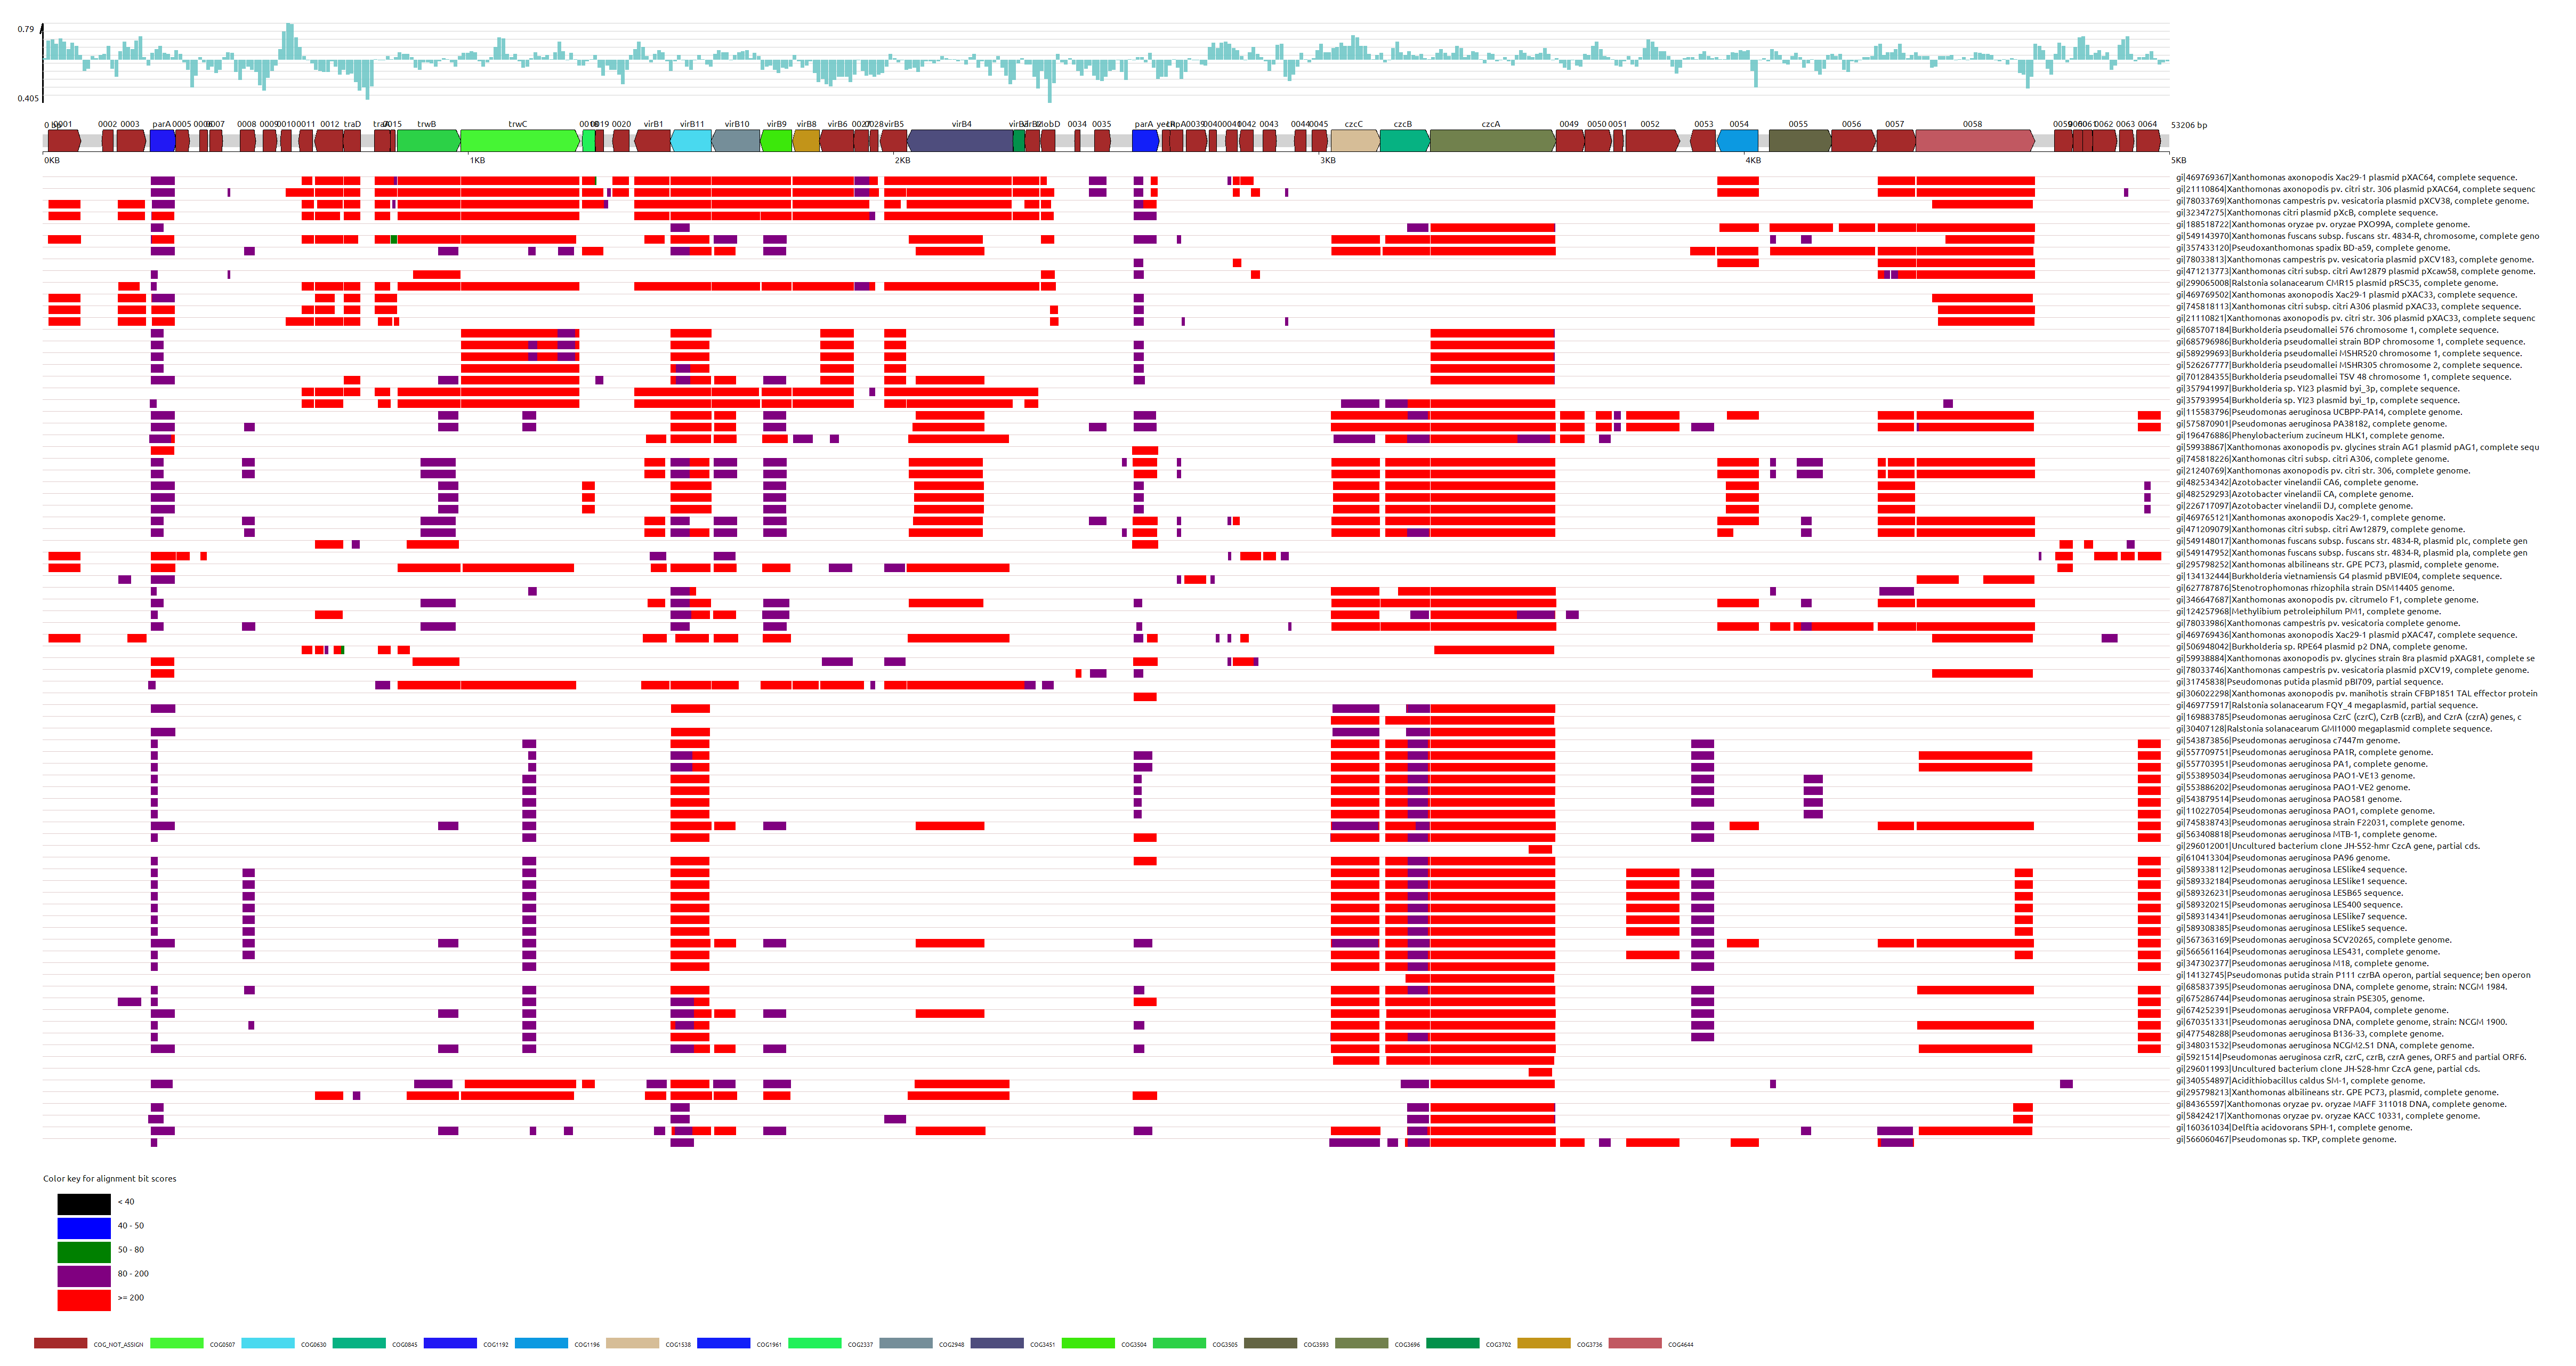
估计阅读时长: 14 分钟在基因组学研究中,将新测序的基因或者针对目标基因组进行基于KEGG代谢通路体系的虚拟细胞建模,都会需要将目标基因组与已知功能基因进行比对注释。KEGG(Kyoto Encyclopedia of Genes and Genomes)数据库通过其KEGG Orthology (KO)系统,为基因功能注释提供了一个强大的平台。KO系统将功能上保守的直系同源基因归为一类,每个KO条目(K编号)代表一个直系同源基因群,这些基因在不同物种中通常执行相似的生物学功能。因此,将新基因的序列与KEGG数据库中的已知基因进行比对,可以推断其可能的KO编号,从而将其功能映射到KEGG通路图或功能层级中。
估计阅读时长: 10 分钟https://gcmodeller.org/ 流平衡分析(flux balance analysis)是一种可以用来构建和模拟分析基因组级别的代谢网络的数学方法。流平衡分析是系统生物学(system biology)的一个重要的分析手段。不同于以湿实验的代谢通量分析(metabolic flux analysis, MFA),FBA是用数学方法对代谢网络里的代谢流进行拟合分析。
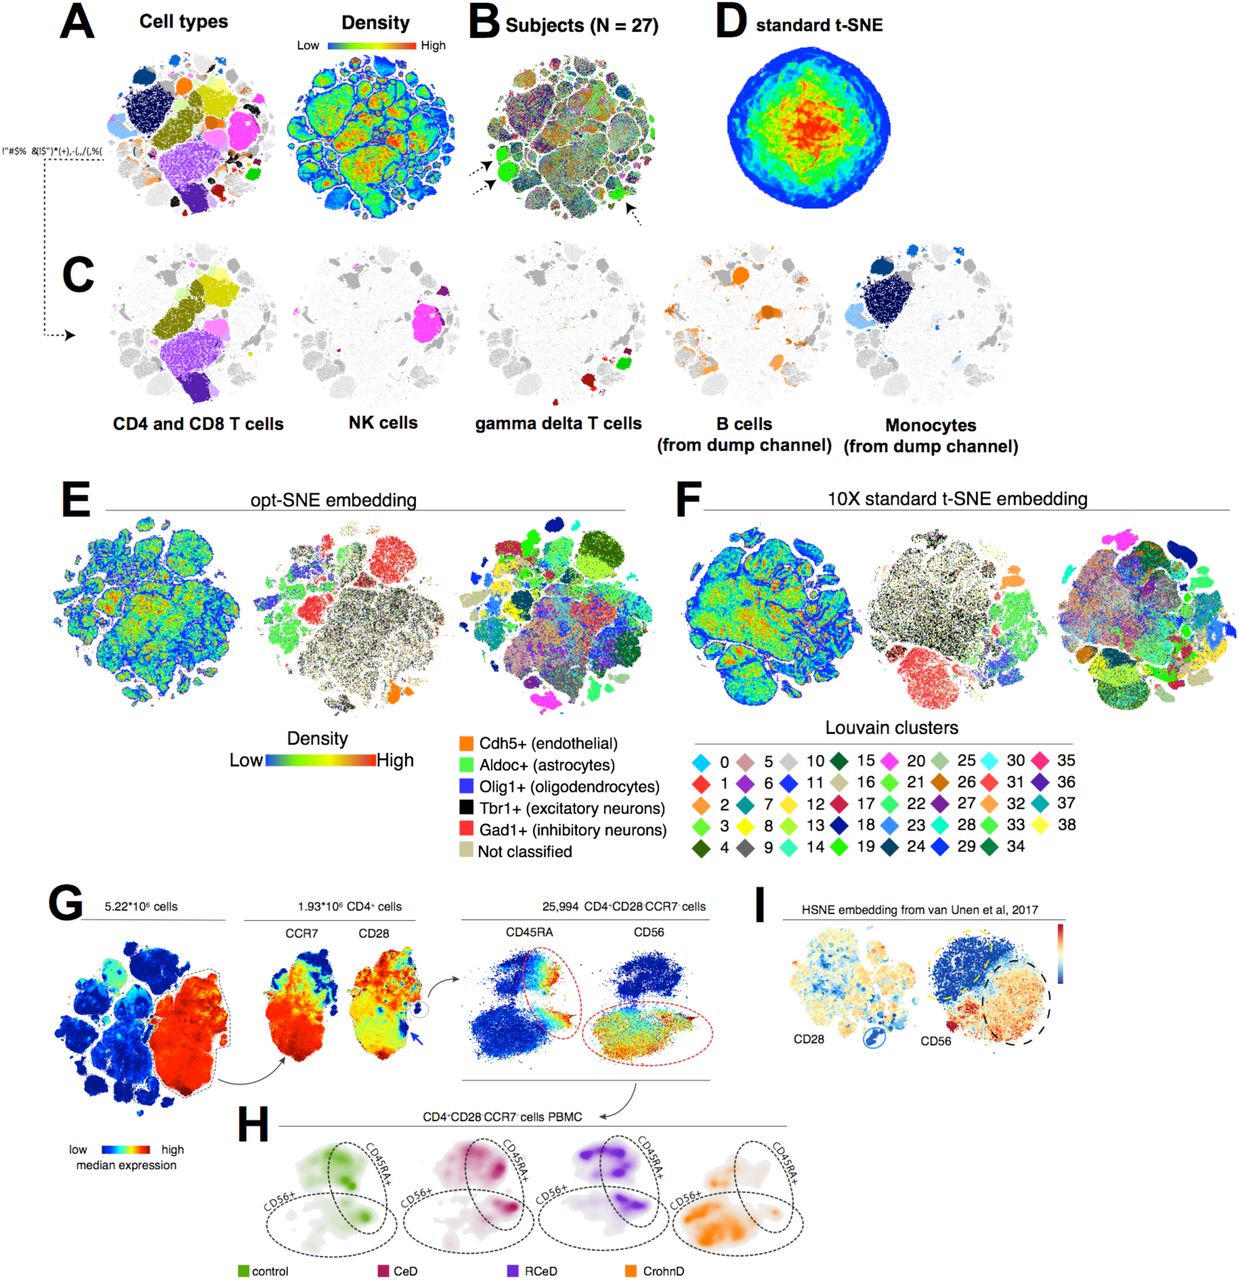
估计阅读时长: 11 分钟PhenoGraph提供了与UMAP类似的算法过程进行单细胞组学数据的细胞分型处理操作。与UMAP方法相比,PhenoGraph并不会产生数据降维效果,仅仅产生数据点Cluster信息。如果需要将数据进行可视化,还需要借助于t-SNE算法将PhenoGraph的分型结果数据投影到一个二维平面上完成。
估计阅读时长: 15 分钟进行生物化学代谢反应网络的模拟计算,可以分为三种技术路线:基于线性规划做优化的FBA方法,基于常微分方程组求解的动力学模拟方法,以及最近发展的基于图神经网络做模拟计算的深度学习计算方法。在下面的表格中,在这里进行比较和总结了上面所提到的三种计算分析方法各自的计算原理和应用领域: 计算方法 原理 优势 适用场景 通量平衡分析(FBA) 基于约束条件(如化学计量矩阵、酶容量限制)和线性规划,在假设代谢网络处于稳态(即代谢物浓度不变)的前提下,计算代谢通量的分布,通常以最大化特定目标(如生物量生长)进行优化 1. 无需详细的酶动力学参数,特别适合大规模网络研究。2. 计算速度快,可系统性地预测基因敲除或环境扰动下的表型变化。3. 广泛应用于指导代谢工程,优化目标产物合成。 追求快速评估和全局优化:如果你的研究目标是在基因组尺度上快速评估微生物在不同条件下的生长或产物合成潜力,并且难以获取详细的动力学参数,FBA是一个非常实用的起点 动力学模拟 基于质量作用定律等构建常微分方程组(ODEs),描述每个代谢物浓度随时间变化的动力学过程,通过数值方法求解方程组 1. 能够捕捉代谢物浓度和通量的瞬态动态变化,揭示更精细的调控机制2. […]
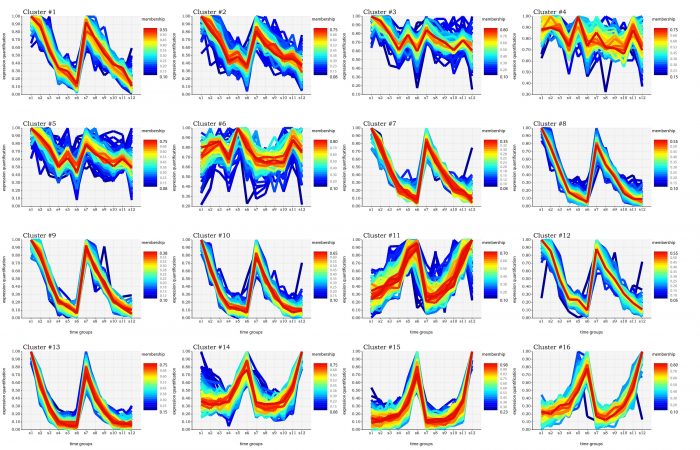
估计阅读时长: 11 分钟https://github.com/SMRUCC/GCModeller 在R语言之中,存在着一个用于进行表达数据的时间序列分析的程序包:TCseq。TCseq的全称为Time course sequencing,即时间序列分析,通过对表达矩阵进行时间上的模糊CMeans聚类,得到表达变化趋势一致的基因列表,进行基因表达的时间趋势分析。 在GCModeller之中,我仿照着TCseq程序包,自己编写了一个时间序列的聚类与可视化分析的R#程序包模块,在这里介绍给大家。
估计阅读时长: 5 分钟https://github.com/rsharp-lang/R-sharp 今天在这里给大家介绍的是一些在R#脚本语言编程之中的一些高级语法,关于R#语言的一些基础语法,大家可以阅读R#语言教程系列的第一篇《R#语言简明教程》 对于R#脚本与R脚本语言之间的关系,大家可以将R#语言看作为R语言的一个超集,相似于TypeScript语言与JavaScript语言之间的关系。在这篇文章中,我主要向大家介绍在R#语言之中针对R语言的一些不足进行的改进部分。
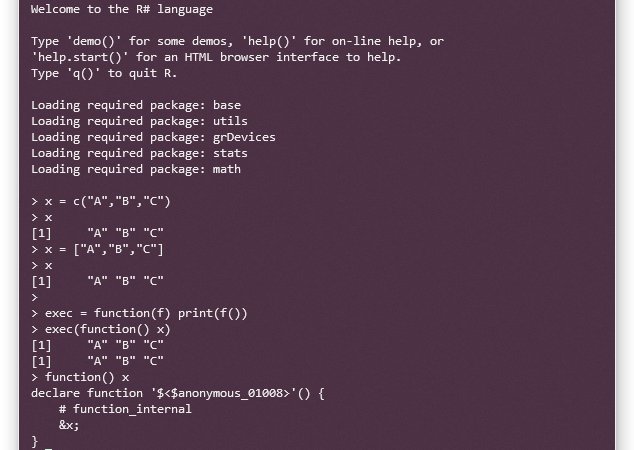
估计阅读时长: 8 分钟https://github.com/rsharp-lang/R-sharp R#语言的语法主要来自于R语言,其在保留了很多的R语言特性的同时,也添加了很多新语法特性。对于R#与R语言之间相同的语法特性,在本简明教程中我就不再叙述了,在这里主要是给大家说明一下R#语言相对于R语言新增的一些语法特性。 R#语言中的向量 R#语言任然保持着和其前辈R语言一样的向量化编程的特性。对于声明一个向量,在R语言之中,需要使用c函数进行申明,而对于R#语言而言,除了使用c函数,还可以直接使用方括号进行申明,例如: x = c("A","B","C") # x # [1] "A" "B" "C" x = […]
估计阅读时长: 3 分钟在BILIBILI上观看视频:《【GCModeller教程】基因组GO功能注释原理》 哈喽,各位小伙伴们好啊,你们可爱的六神无主鸠今天又开新课了。今天主要为大家讲解的内容是GO基因功能注释的原理和操作。在开始今天的新视频前,我先为大家来讲一个圣经中的神话: 大洪水过去后, 诺亚的三个儿子的后裔形成了人类的三大支系,居住在世界各地,遍布地面。那时候人们的语言、口音都没有分别。他们在往东边迁移的时候,在示拿这个地方遇见一片平原,就在那里住下。因为在平原上,用作建筑的石料很不易得到,他们就发明了制造砖的方法,用泥作成方块,再用火烧透,他们就拿砖当石头,又拿石漆当灰泥,建造起繁华的巴比伦城。 人们为自己的业绩感到骄傲,他们决定在巴比伦修一座通天的高塔,来传颂自己的赫赫威名,并作为集合全天下弟兄的标记,以免分散。因为大家语言相通,同心协力,阶梯式的通天塔修建得非常顺利,很快就高耸入云。 上帝是不允许凡人达到自己的高度的。他看到人们这样统一强大,心想,他们语言都一样,如果真修成宏伟的通天塔,那以后还有什么事干不成呢? 必须制止人类接近自己的狂妄。上帝就离开天国到人间,变乱了人们的语言。人们各自操起不同的语言,感情无法交流,思想很难统一。修造工程因语言纷争而停止了,通天塔的建造终于半途而废了。

代谢组学那堆名词我上次查资料时也手抄过一页,QC 样本、保留时间、m/z 这些混在一张表里,来回对照着看特别费劲。你这篇把英文缩写和中文解释排在一起,省了我不少翻文献的功夫,尤其是代谢物鉴定那几段。
文中提出的"能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢?"让我想到一个需要先厘清的问题:把Family层级的分类当作细胞分群标签时,功能相似性与亲缘关系可能会混在一起,图上的聚集未必能直接解释为代谢功能接近。如果借用单细胞分析中的降维流程,是否可以同时标注物种分类和基因组注释完整度,看看分离主要对应哪一种差异?尤其是这里用的是EC注释的TF-IDF矩阵,缺少某项注释究竟代表功能缺失还是未被识别,也可能影响对分群结果的判断。
这个角度之前没想到,零分布原理及其在生物信息学中的应用 确实值得深入了解。刚好之前看过,可以对照着看看。
Greetings! I stumbled upon this really useful site and figured I'd thanks for you post at here.
This content speaks to hearts