
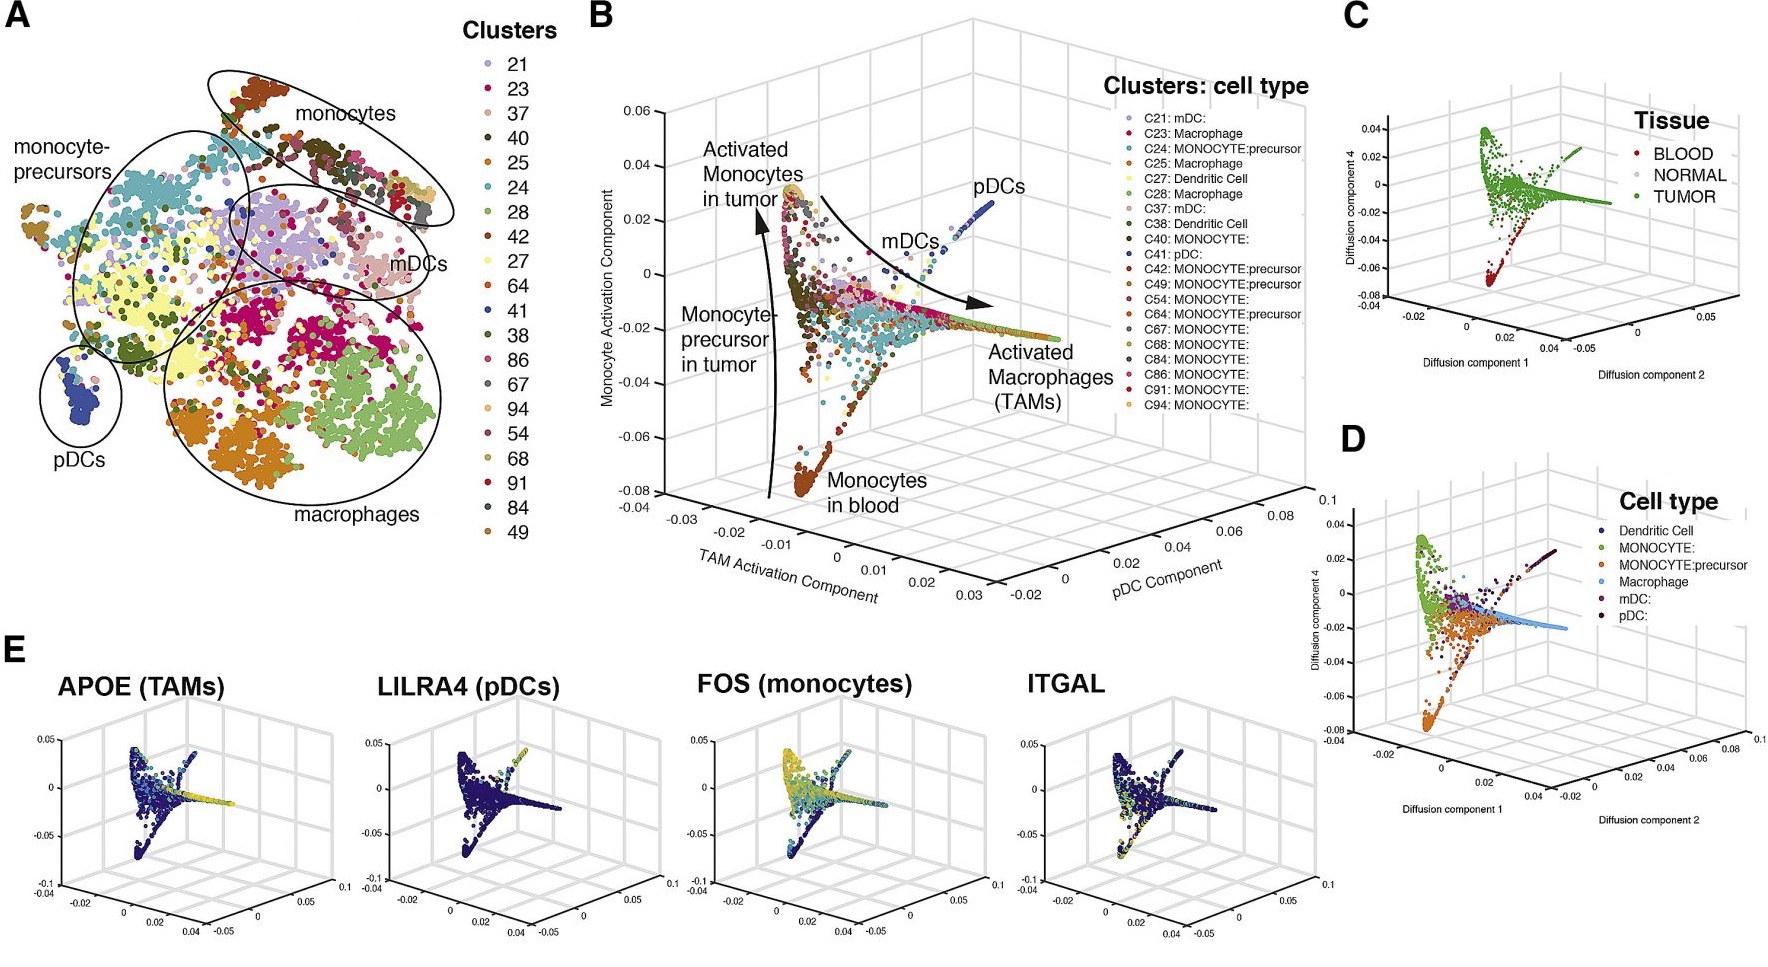
估计阅读时长: 14 分钟https://github.com/rsharp-lang/ggplot 之前在阅读一篇单细胞组学数据分析的文献,觉得在文献之中有一些三维散点图用于展示降维聚类结果的效果非常的好看。于是自己在R#语言之中的ggplot程序包的2D绘图的功能基础之上,进行了三维图形数据可视化功能的开发。 (A) t-SNE map projecting myeloid cells from BC1-8 patients (all tissues). Cells are colored […]
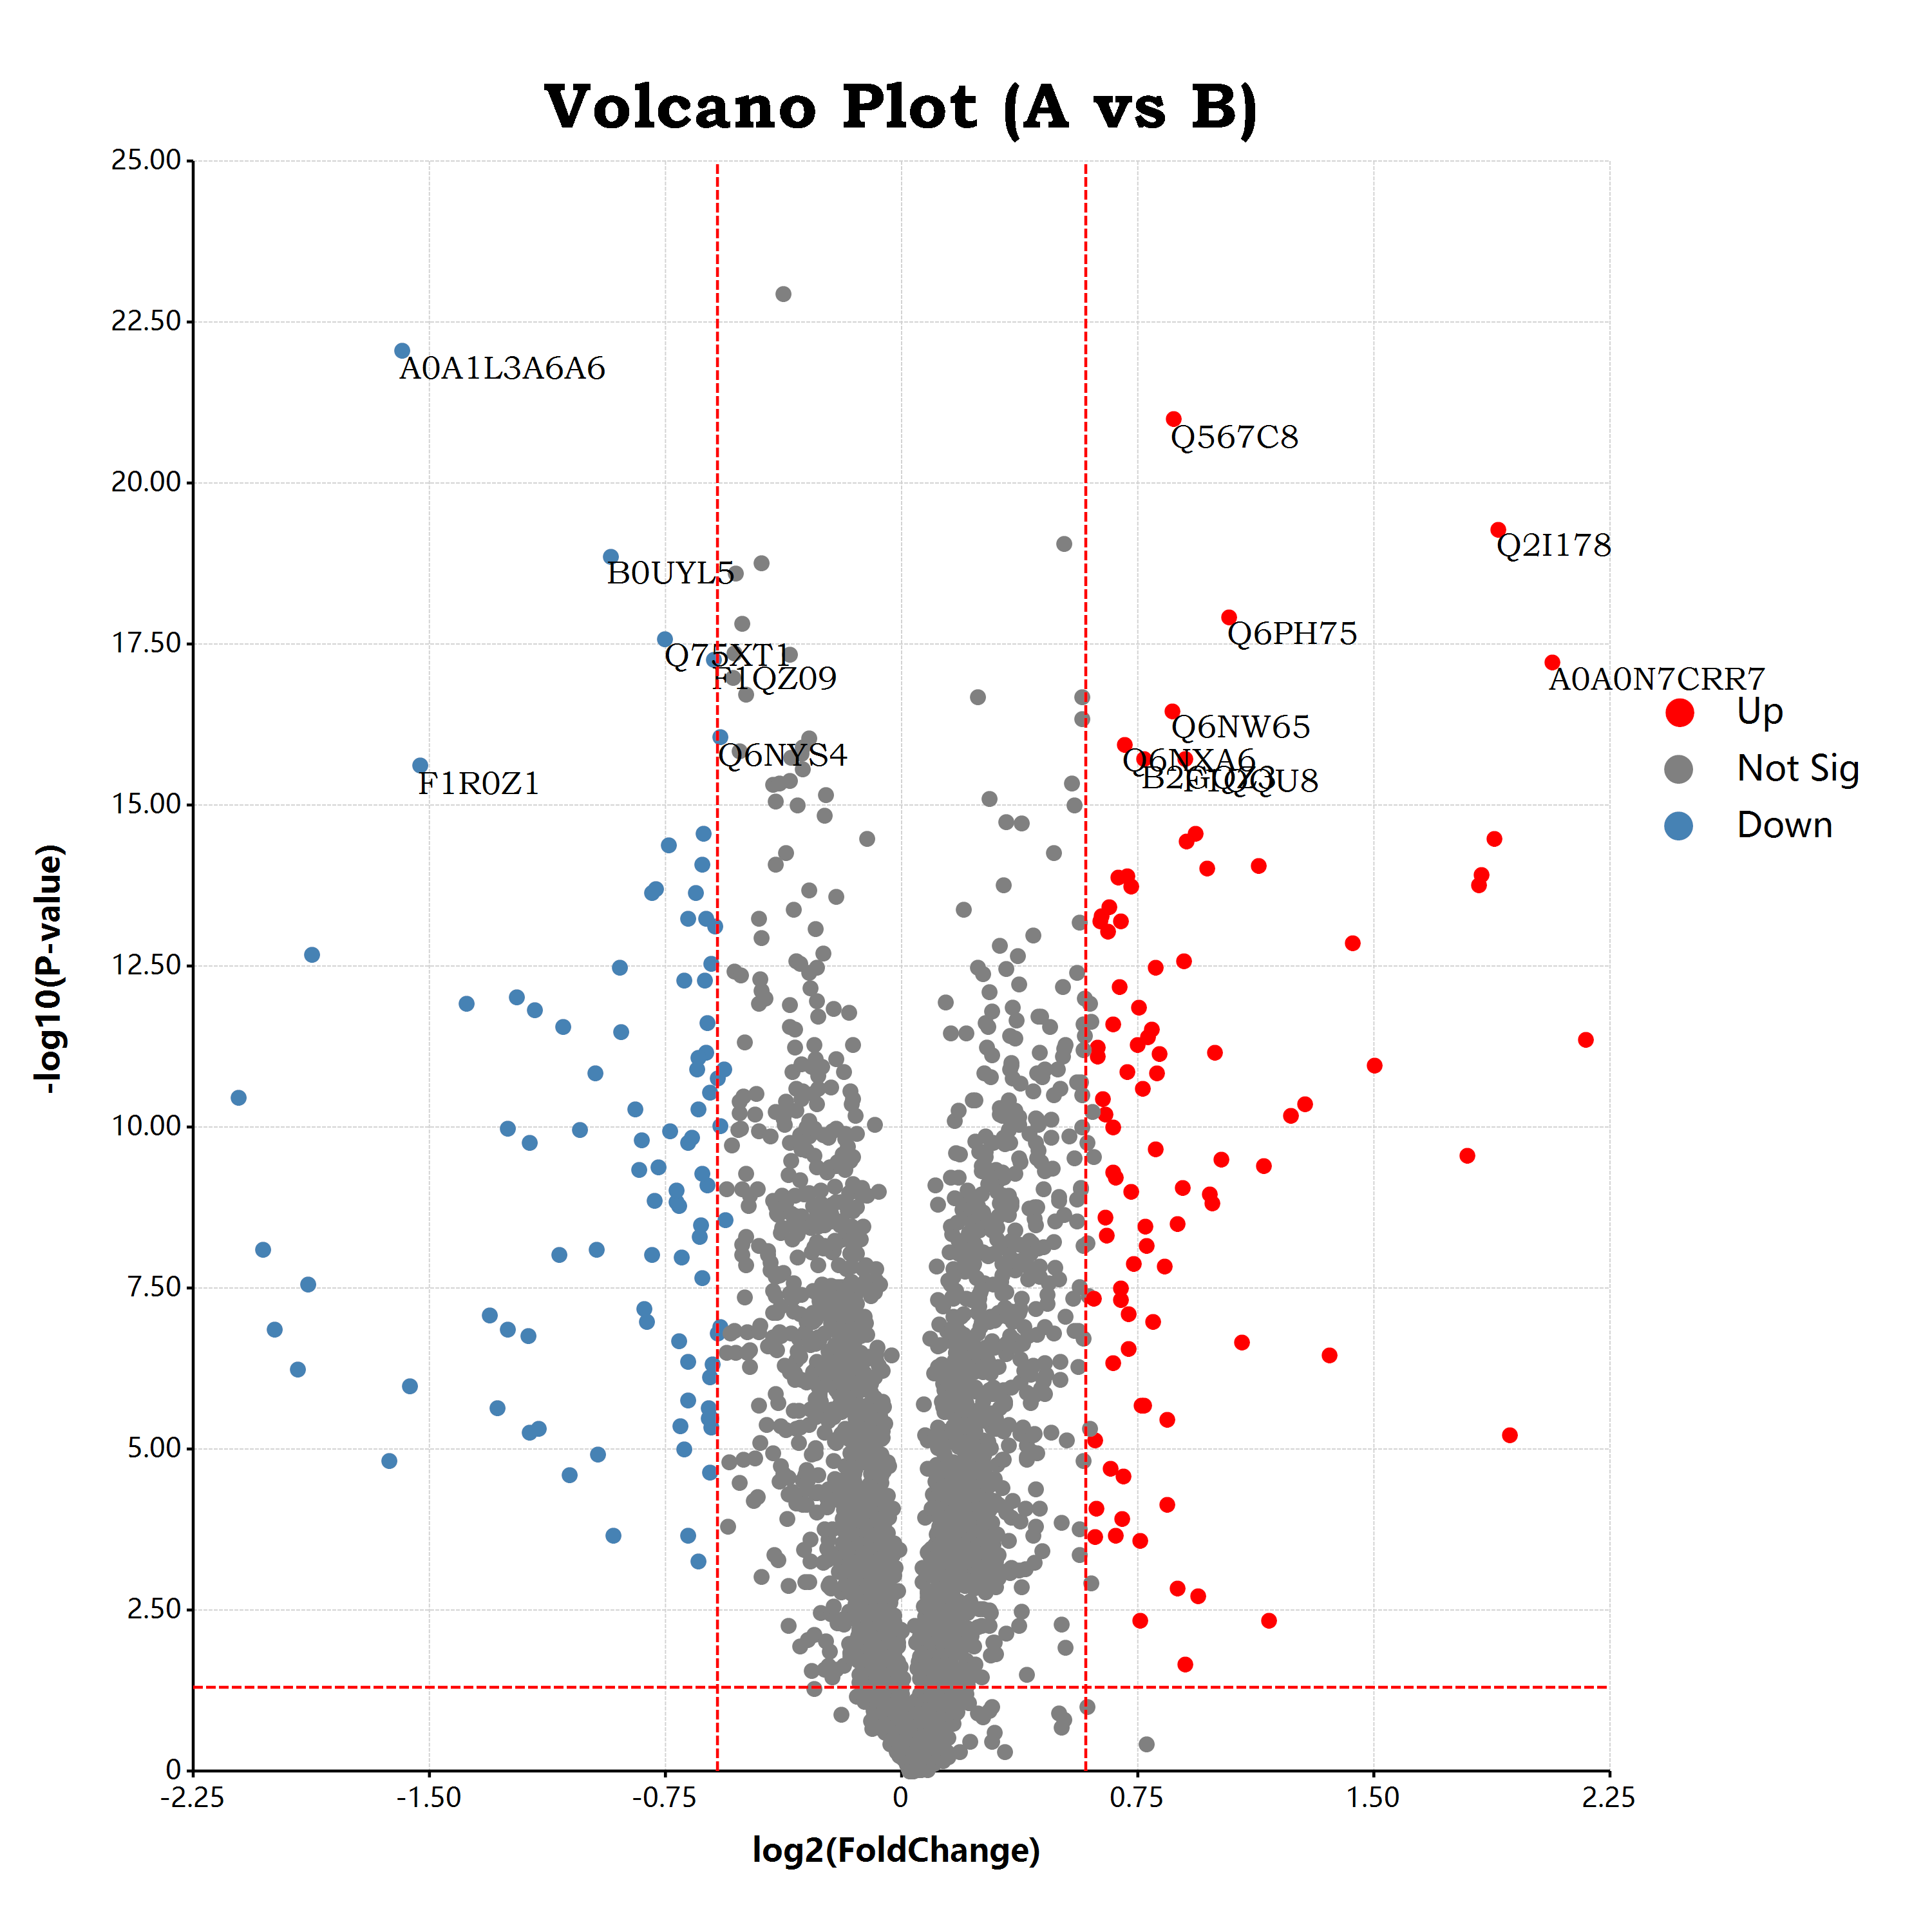
估计阅读时长: 17 分钟https://github.com/rsharp-lang/ggplot 接上一篇博客文章中谈到,我们已经通过R#语言之中的ggplot程序包绘制出了一个可以使用的火山图。在这里,我们将会通过在火山图上添加更多的可视化元素来为大家介绍R#语言之中的ggplot程序包的进阶使用方式。
估计阅读时长: 11 分钟https://github.com/rsharp-lang/ggplot 在生物信息学中的组学数据分析领域内,有一个非常常见的数据可视化图表:应用于可视化两两组别比对结果的火山图。在火山图之中,X坐标轴一般是log2FC,纵坐标Y轴,则一般是t检验的pvalue的-log10转换之后的值。由于fold change有大于1的值,A/B大于1,表示A的表达量高于B的表达量,反之小于一表示A的表达量低于B的表达量。这样子fold change经过log2转换之后,就会出现负数,散点一般呈轴对称分布在X=0的位置周围。这样子绘制出来的散点图就有点类似于火山喷发的样子了。
估计阅读时长: 7 分钟https://github.com/rsharp-lang/ggplot 一张统计图形就是从数据到几何对象(geometric object, 缩写为geom, 包括点、线、条形等)的图形属性(aesthetic attributes, 缩写为aes, 包括颜色、形状、大小等)的一个映射。此外, 图形中还可能包含数据的统计变换(statistical transformation, 缩写为stats), 最后绘制在某个特定的坐标系(coordinate system, 缩写为coord)中, 而分面(facet, 指将绘图窗口划分为若干个子窗口)则可以用来生成数据中不同子集的图形。 […]
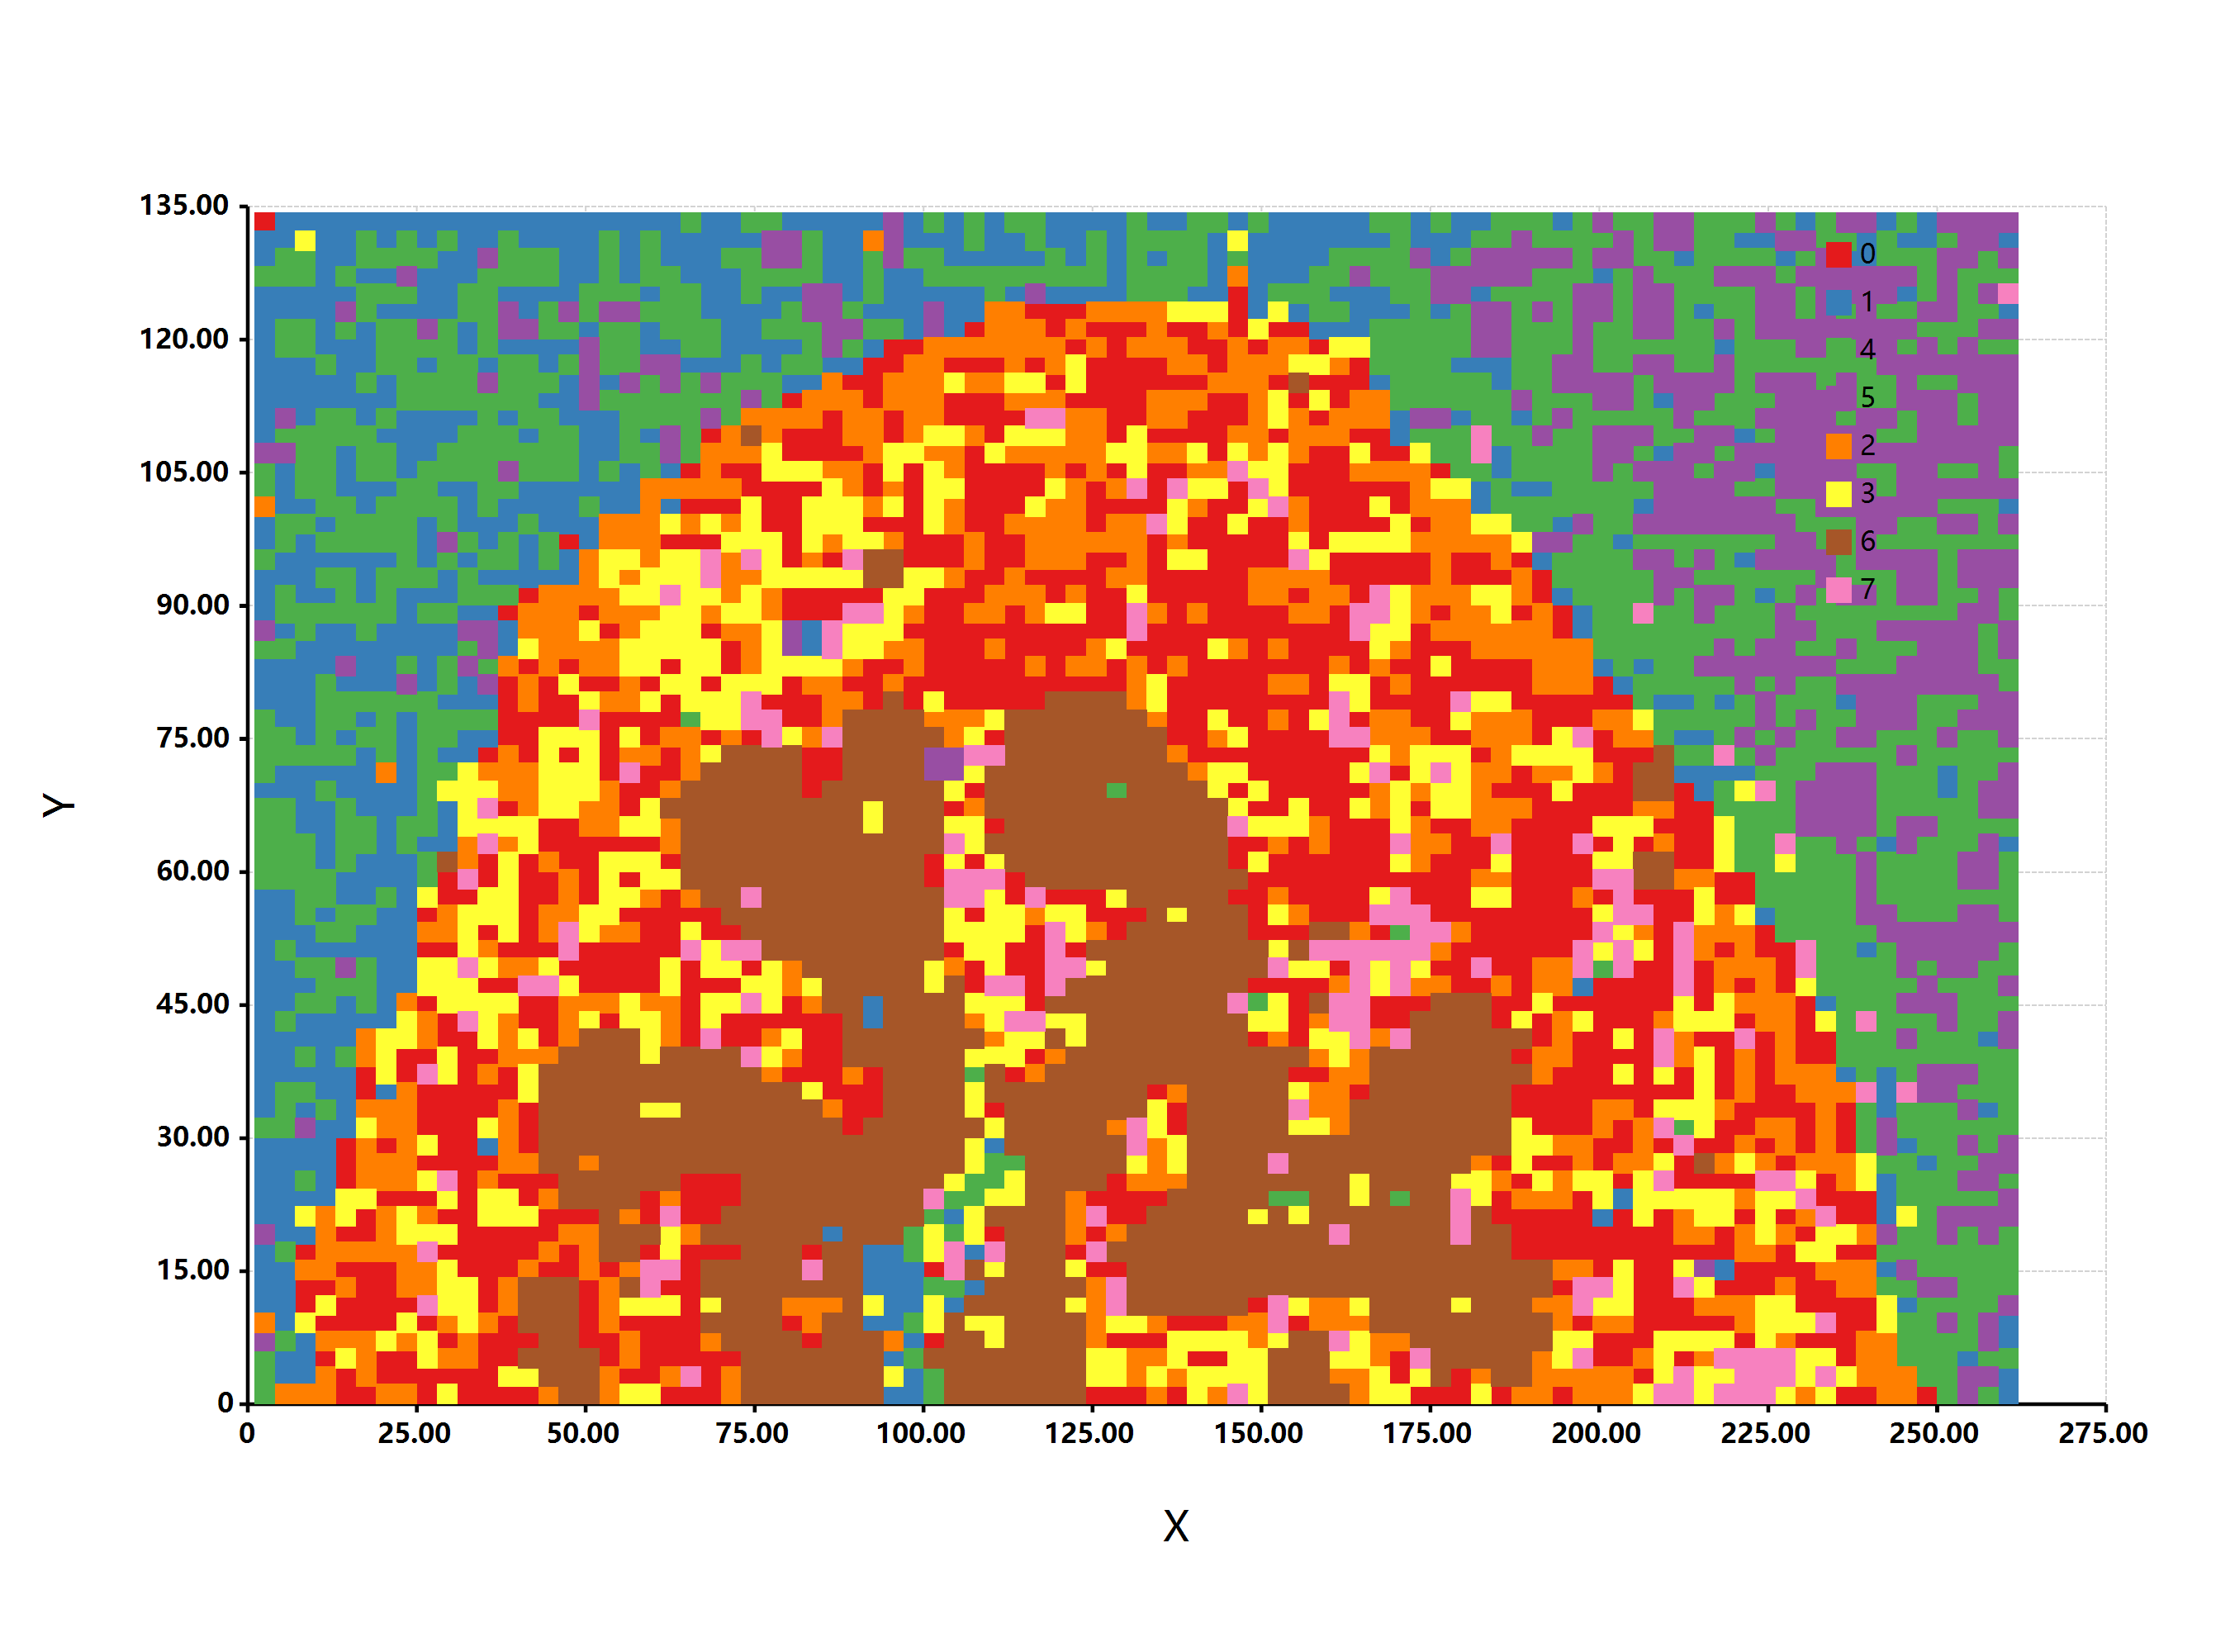
估计阅读时长: 15 分钟https://gcmodeller.org 在这篇博客文章之中,我主要是来详细介绍一下是如何从头开始实现Phenograph单细胞分型算法的。在之前的一篇博客文章《【单细胞组学】PhenoGraph单细胞分型》之中,我们介绍了Phenograph算法的简单原理,以及一个在R语言之中所实现的Phenograph算法的程序包Rphenograph。在这里我主要是详细介绍在GCModeller软件之中所实现的VisualBasic语言版本的Phenograph单细胞分型算法。
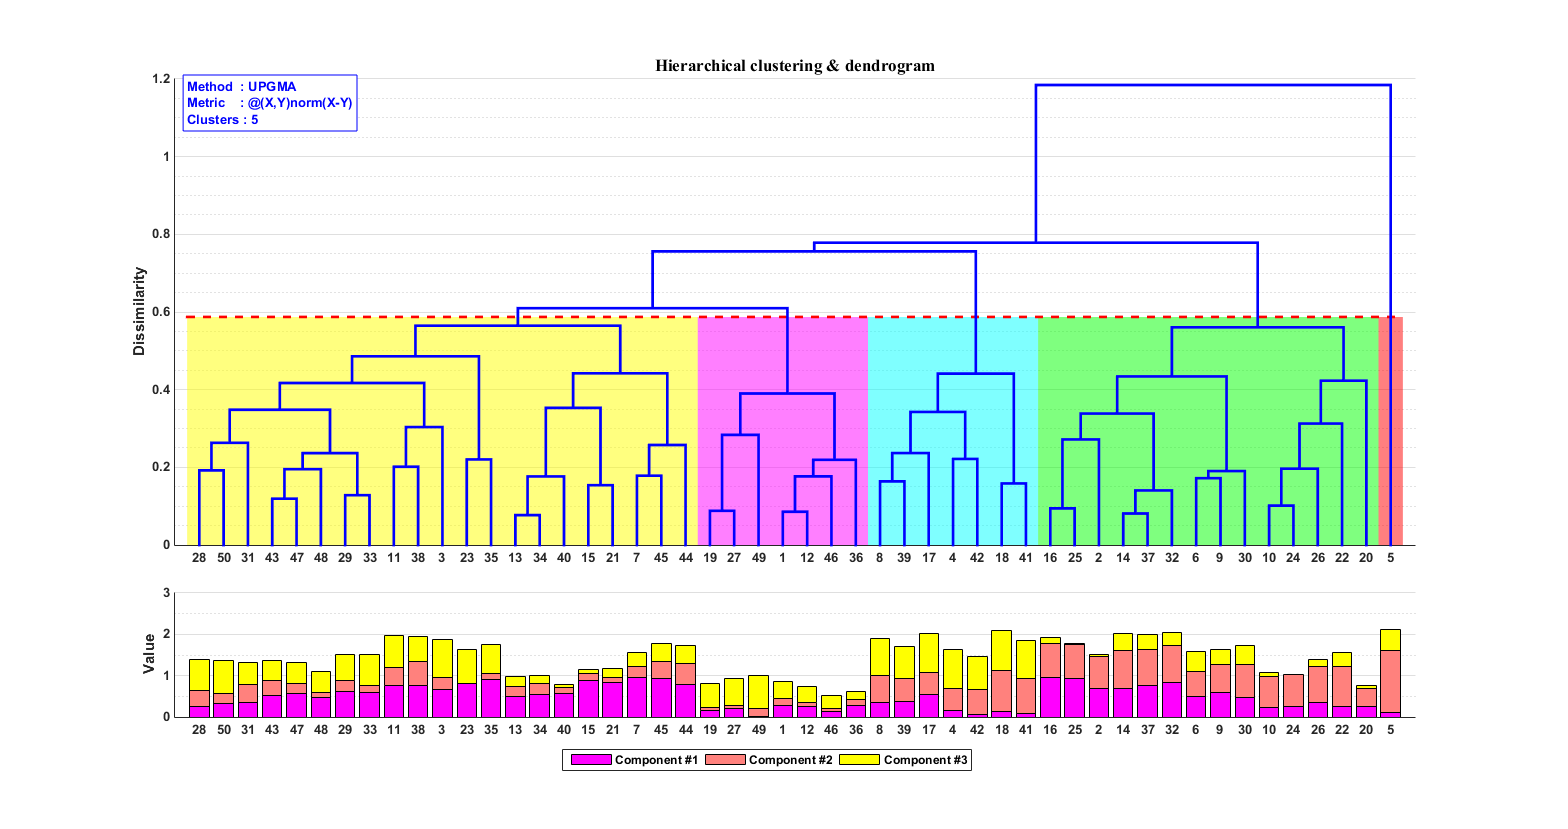
估计阅读时长: 14 分钟https://github.com/xieguigang/sciBASIC 层次聚类通过计算不同类别数据点间的相似度来创建一棵有层次的嵌套聚类树。基于层次聚类分析,我们可以初步可视化我们的一些原始数据: 例如对样本的层次聚类分类,可以让我们了解到样本在分组之间以及分组内的异质性。 对生物序列进行基于相似度的层次聚类分析,我们可以了解到序列之间的相似性程度或者进化关系
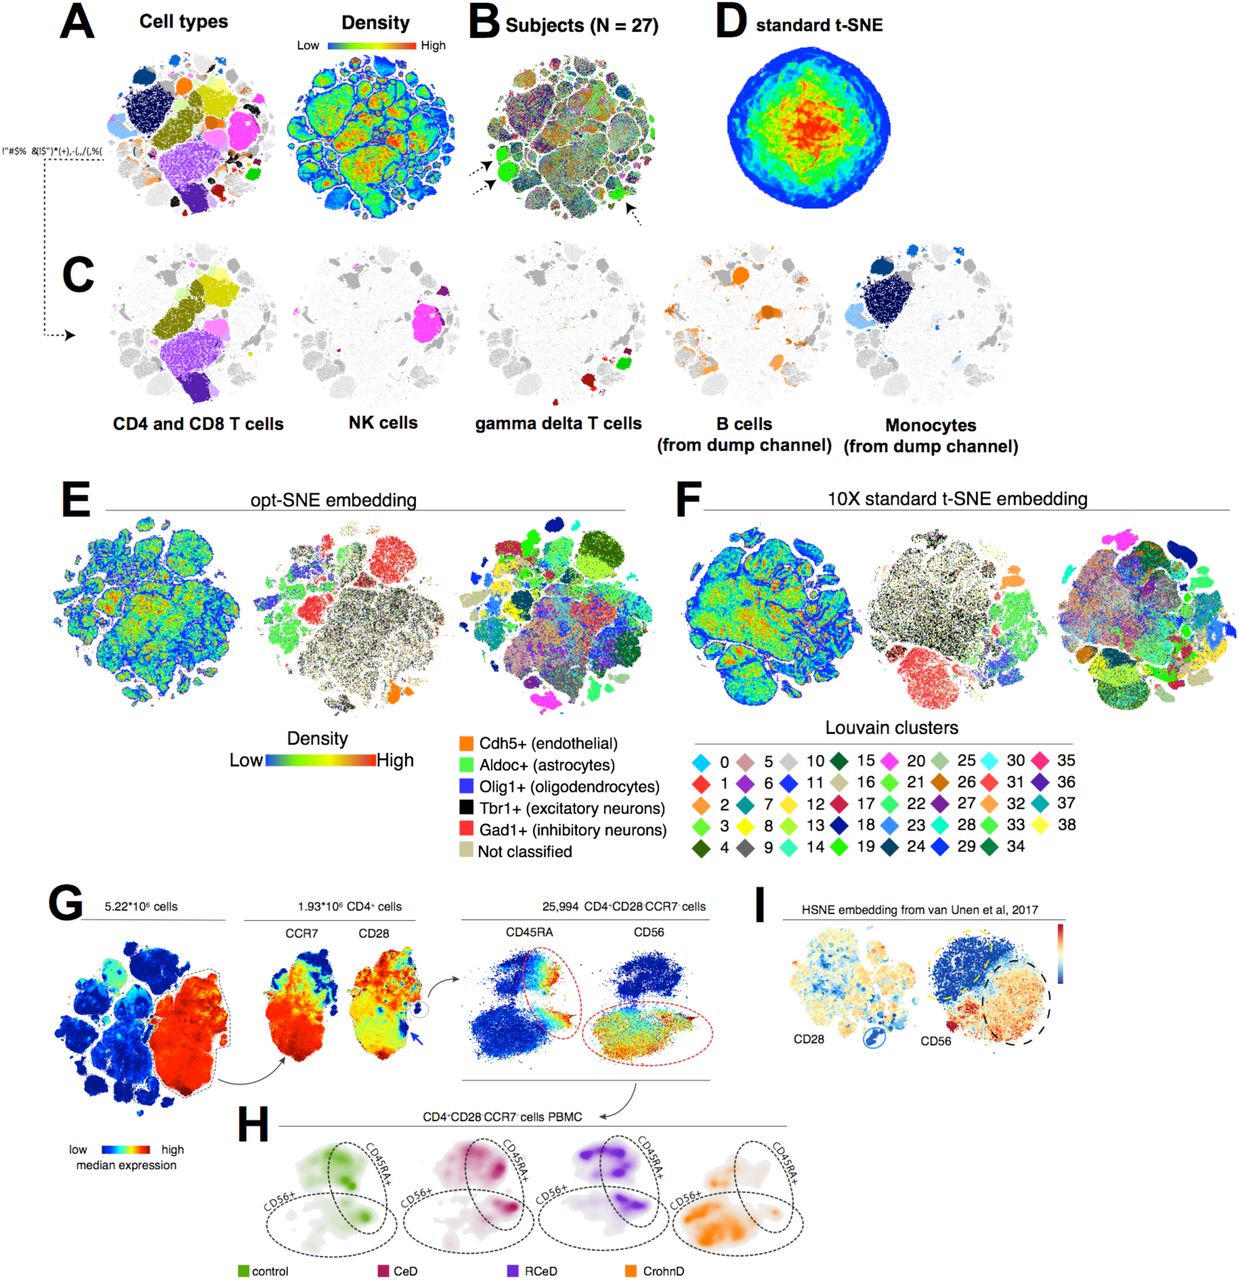
估计阅读时长: 11 分钟PhenoGraph提供了与UMAP类似的算法过程进行单细胞组学数据的细胞分型处理操作。与UMAP方法相比,PhenoGraph并不会产生数据降维效果,仅仅产生数据点Cluster信息。如果需要将数据进行可视化,还需要借助于t-SNE算法将PhenoGraph的分型结果数据投影到一个二维平面上完成。
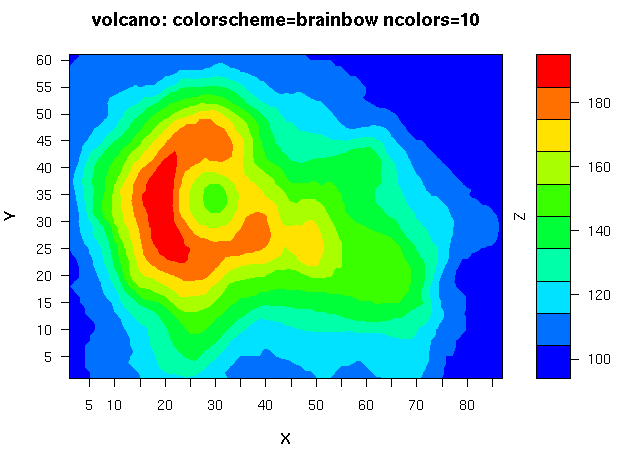
估计阅读时长: 16 分钟https://github.com/xieguigang/sciBASIC 等高线指的是地形图上高程相等的相邻各点所连成的闭合曲线。把地面上海拔高度相同的点连成的闭合曲线,并垂直投影到一个水平面上,并按比例缩绘在图纸上,就得到等高线。
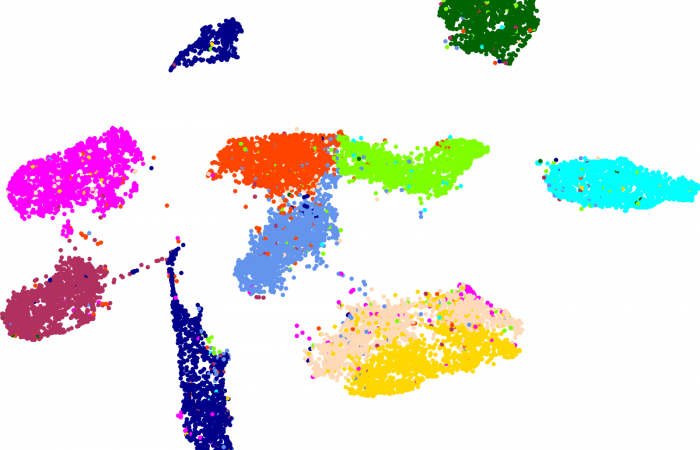
估计阅读时长: 23 分钟https://github.com/rsharp-lang/R-sharp 降维是将数据由高维约减到低维的过程而用来揭示数据的本质低维结构。它作为克服“维数灾难”的途径在这些相关领域中扮演着重要的角色。在过去的几十年里,有大量的降维方法被不断地提出并被深入研究,其中常用的包括传统的降维算法如PCA和MDS;流形学习算法如UMAP、t-SNE、ISOMAP、LE以及LTSA等。
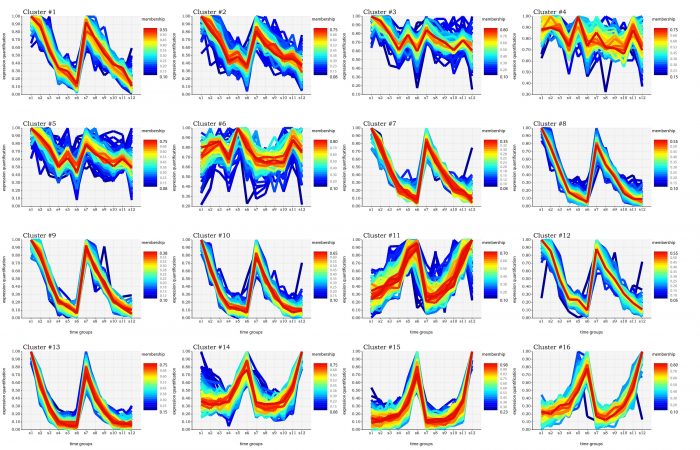
估计阅读时长: 11 分钟https://github.com/SMRUCC/GCModeller 在R语言之中,存在着一个用于进行表达数据的时间序列分析的程序包:TCseq。TCseq的全称为Time course sequencing,即时间序列分析,通过对表达矩阵进行时间上的模糊CMeans聚类,得到表达变化趋势一致的基因列表,进行基因表达的时间趋势分析。 在GCModeller之中,我仿照着TCseq程序包,自己编写了一个时间序列的聚类与可视化分析的R#程序包模块,在这里介绍给大家。

代谢组学那堆名词我上次查资料时也手抄过一页,QC 样本、保留时间、m/z 这些混在一张表里,来回对照着看特别费劲。你这篇把英文缩写和中文解释排在一起,省了我不少翻文献的功夫,尤其是代谢物鉴定那几段。
文中提出的"能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢?"让我想到一个需要先厘清的问题:把Family层级的分类当作细胞分群标签时,功能相似性与亲缘关系可能会混在一起,图上的聚集未必能直接解释为代谢功能接近。如果借用单细胞分析中的降维流程,是否可以同时标注物种分类和基因组注释完整度,看看分离主要对应哪一种差异?尤其是这里用的是EC注释的TF-IDF矩阵,缺少某项注释究竟代表功能缺失还是未被识别,也可能影响对分群结果的判断。
这个角度之前没想到,零分布原理及其在生物信息学中的应用 确实值得深入了解。刚好之前看过,可以对照着看看。
Greetings! I stumbled upon this really useful site and figured I'd thanks for you post at here.
This content speaks to hearts