
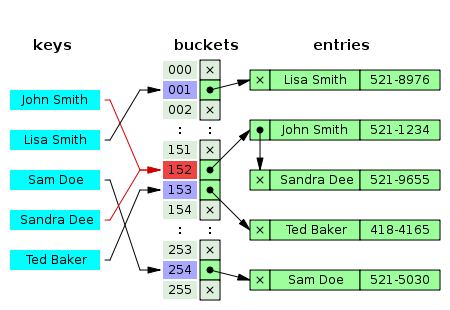
估计阅读时长: 8 分钟在之前的BioDeep代谢物数据库整合工作之中,所提取的代谢物注释信息的唯一编码是来自于数据库表之中的递增主键。由于数据库之中的递增主键的唯一编码值是与数据内容完全无关的数据,所以在基于图数据库做数据库整合的结果在两次整合操作之后,可能会因为先后输出顺序不一致的原因,得到的在关系型数据库中的唯一递增编号可能会完全不一样了。这个问题会对数据库更新操作造成非常大的困扰。 AttachmentsSort by:DefaultDateName 450px-Hash_table_5_0_1_1_1_1_1_LL • 25 KB • 1021 click 16.04.2022metadata-table • 57 KB • 1070 […]
估计阅读时长: 7 分钟https://github.com/rsharp-lang/bing-academic 我们在进行一个新的课题项目开始之前,会需要经历过一个开题立项的报告过程。在这个过程之中,我们需要收集与课题相关的信息,例如相关的知识背景信息,建立出一个与课题相关的知识网络。基于此知识网络进行课题的技术相关概念的梳理。 AttachmentsSort by:DefaultDateName v2-8119594eef2838042df8fb5af0523c0c_720w • 125 KB • 1117 click 15.08.2021v2-96d82f034d4084cf1ed6eb4784f36ed4_r • 246 KB • […]
估计阅读时长: 9 分钟https://github.com/rsharp-lang/bing-academic 必应学术是由微软必应团队联合微软研究院打造的免费学术搜索产品。旨在为广大研究人员提供海量的学术资源,并提供智能的语义搜索服务。目前已涵盖多学科学术论文、国际会议、权威期刊、知名学者等方面。搜索位置:http://cn.bing.com/academic。 AttachmentsSort by:DefaultDateName Bing_Logo • 13 KB • 982 click 14.08.2021html-compression • 135 KB • […]

This content speaks to hearts
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 对于基于ec number来生成层级数据,我们直接使用《酶EC编号结构解析》文章末尾所展示的层级数据生成函数来实现。 […]
[…] 在前面的一篇《基因组功能注释(EC Number)的向量化嵌入》博客文章中,针对所注释得到的微生物基因组代谢信息,进行基于TF-IDF的向量化嵌入之后。为了可视化向量化嵌入的效果,通过UMAP进行降维,然后基于降维的结果进行散点图可视化。通过散点图可视化可以发现向量化的嵌入结果可以比较好的将不同物种分类来源的微生物基因组区分开来。 […]