
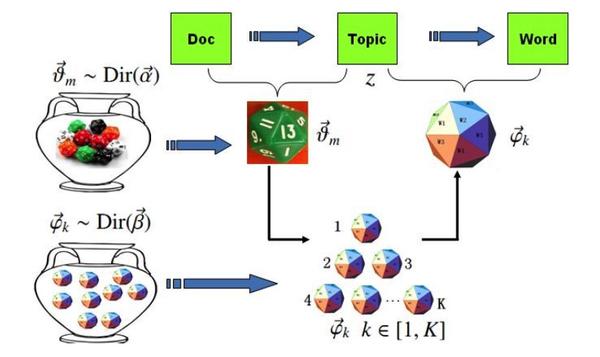
估计阅读时长: 20 分钟LDA(Latent Dirichlet Allocation,潜在狄利克雷分配)是一种用于发现文档集合中潜在主题的生成式概率模型。它假设文档是由多个主题混合而成的,而每个主题又是通过一定的概率分布选择词语生成的。LDA模型包含词、主题和文档三层结构,通过概率生成过程模拟文档的形成。Gibbs LDA 的核心在于使用吉布斯采样方法来推断这些隐藏的主题分布。
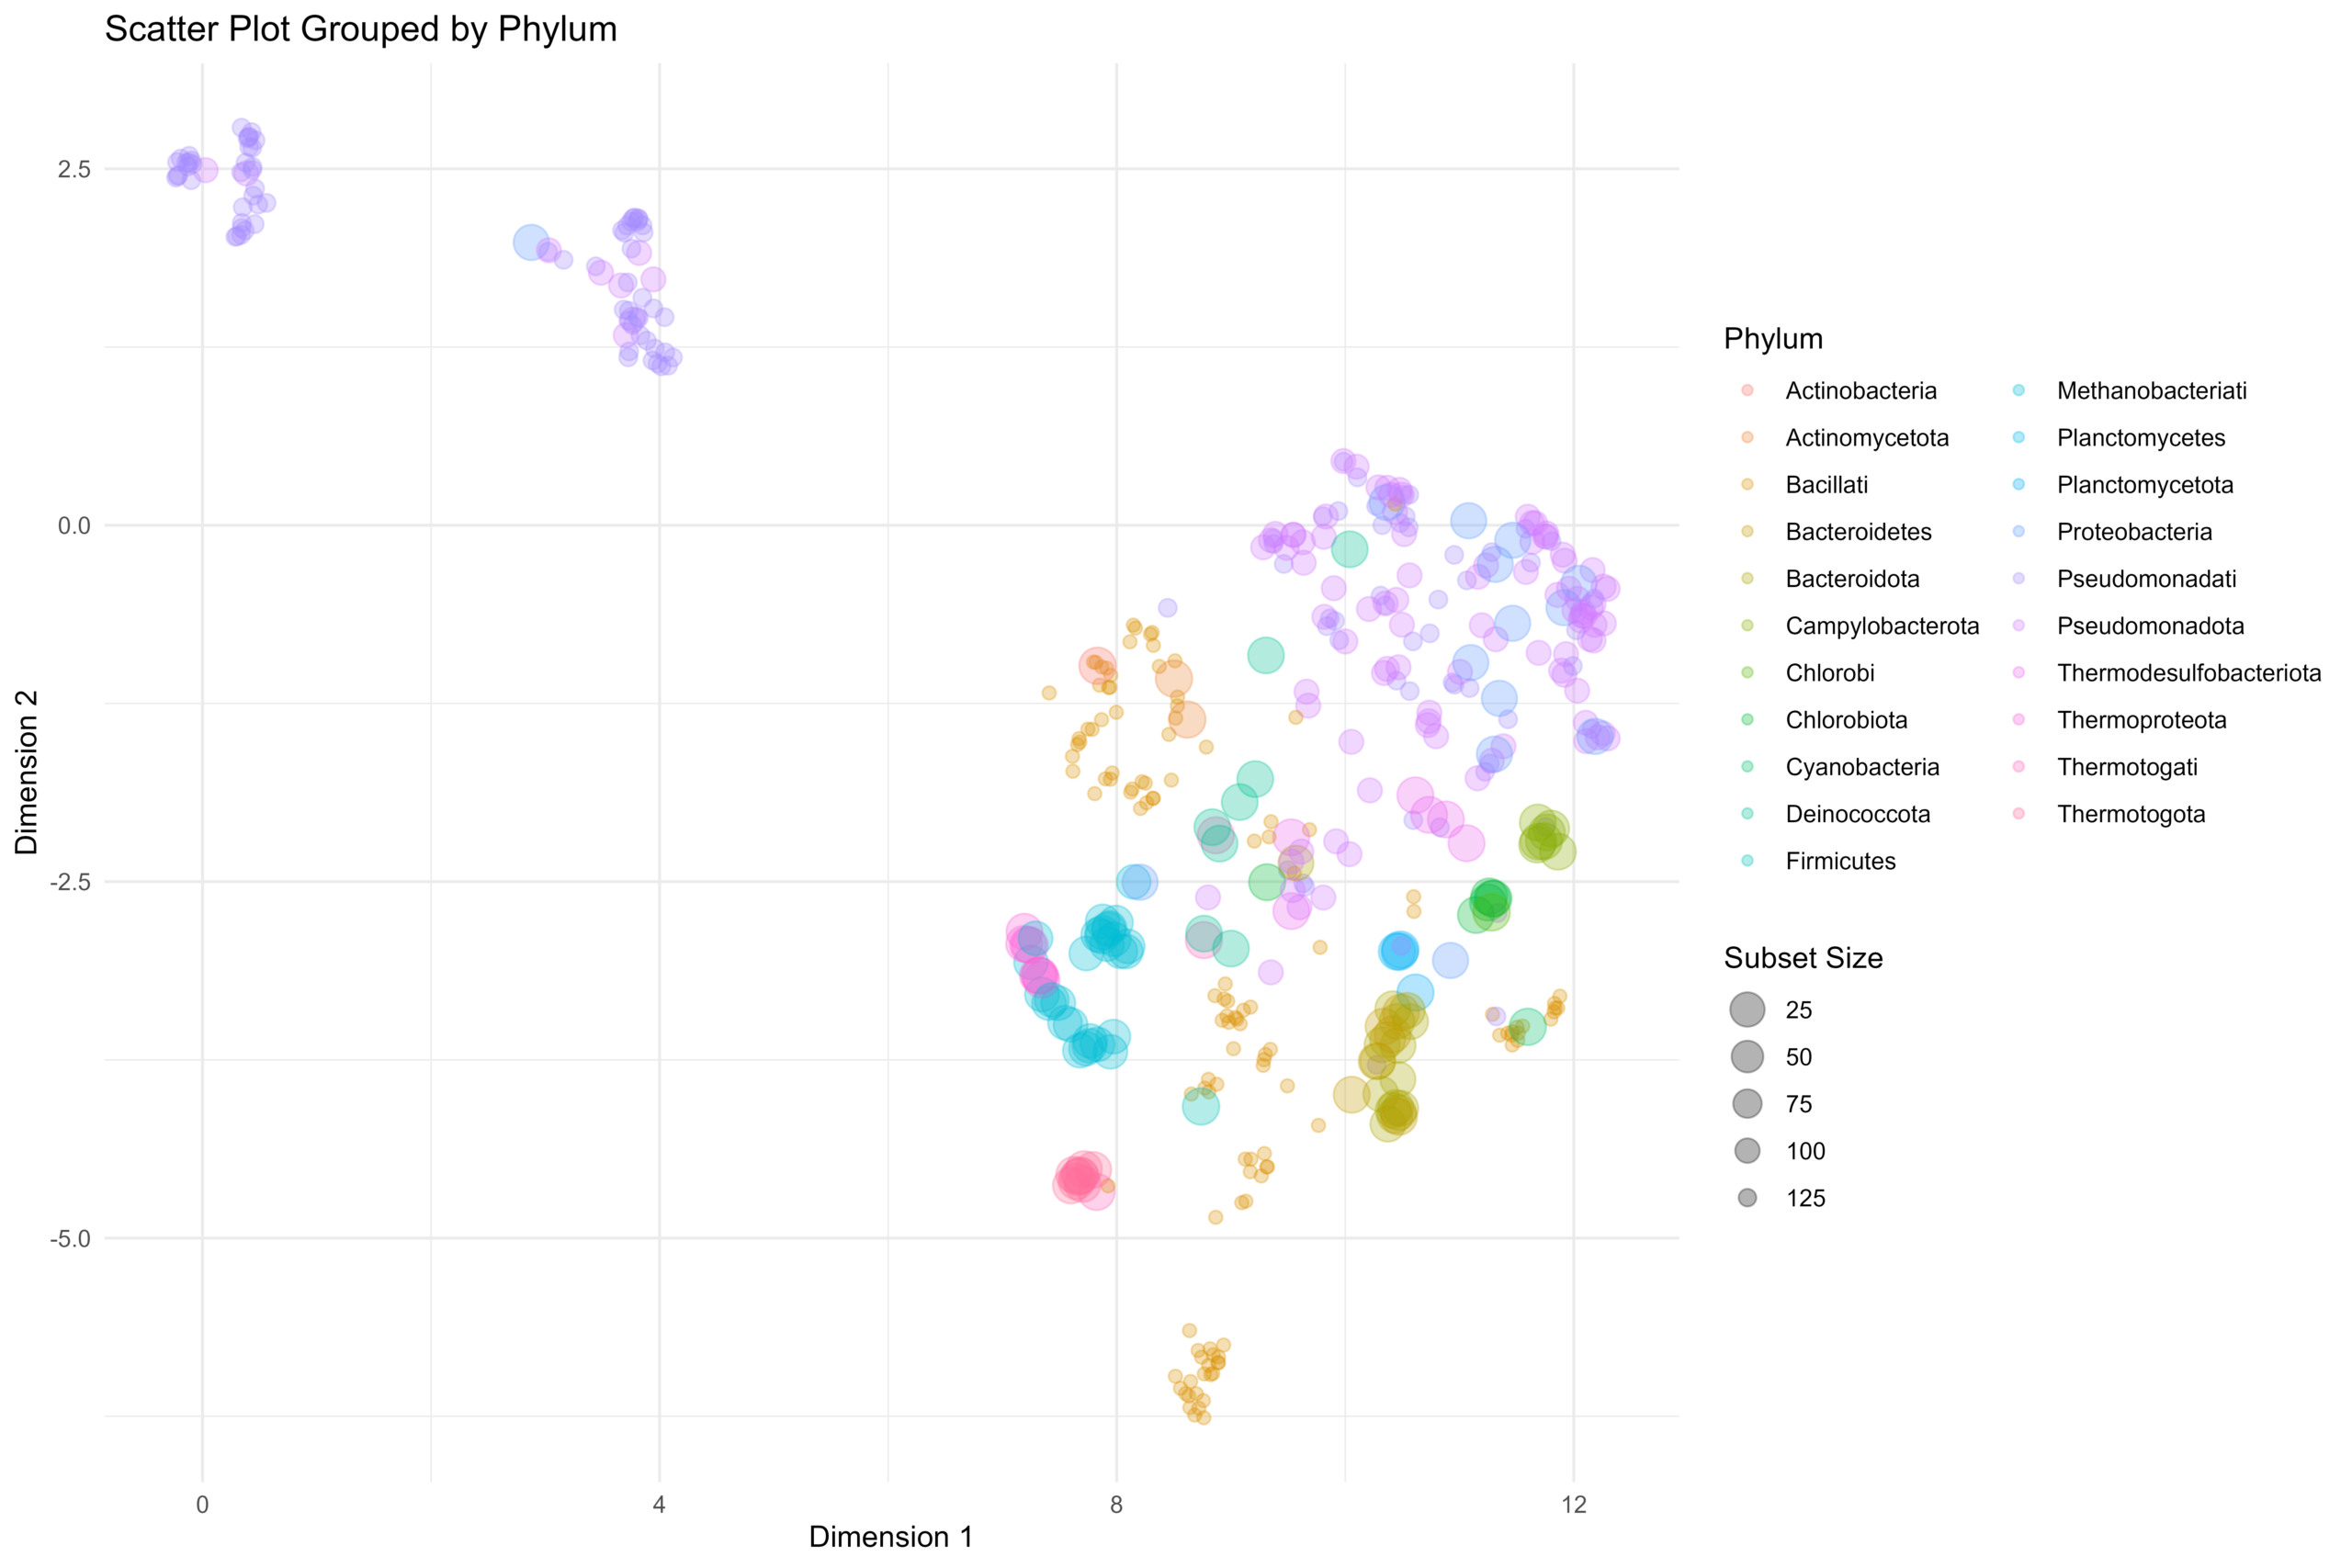
估计阅读时长: 17 分钟EC Number是国际酶学委员会(IUBMB)制定的一套酶分类编号体系,EC Number采用层级分类法,由4个数字组成,分别代表酶的大类、亚类、亚亚类和序号。例如,“EC 1.1.1.37”中,第一个“1”表示氧化还原酶大类;第二个“1”表示作用于CH-OH基团;第三个“1”表示以NAD+或NADP+为受体的酶;第四个“37”表示特定酶苹果酸脱氢酶。这种层次结构意味着EC编号蕴含了丰富的功能信息,包括酶催化的反应类型和底物/机制。将EC Number嵌入为向量,有助于我们利用机器学习模型进行功能预测、相似性分析等。
估计阅读时长: 11 分钟在将生物序列(如基因组或蛋白质序列)或文本数据转换为数值向量形式时,TF-IDF(Term Frequency-Inverse Document Frequency)和N-gram One-hot(又称Bag-of-n-grams)是两种经典且基础的文档嵌入算法。它们各自侧重于不同的特征提取方式,常被用于自然语言处理和生物信息学领域。
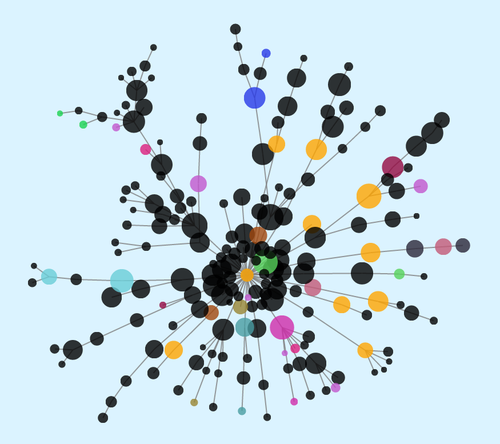
估计阅读时长: 5 分钟https://github.com/xieguigang/graphQL 构建一个图数据库,可以用来帮我们解决复杂的知识关联计算问题。例如我们想要程序向我们回答dihydrogen oxide与water是否是同一个东西。如果光从字符串比较角度上面来看待这个问题的话,很显然,二者的字符串比较结果肯定是False。面对上面的这个问题,图数据库则可以很简单的向我们回答道上面的两个字符串都是指代的同一个东西。
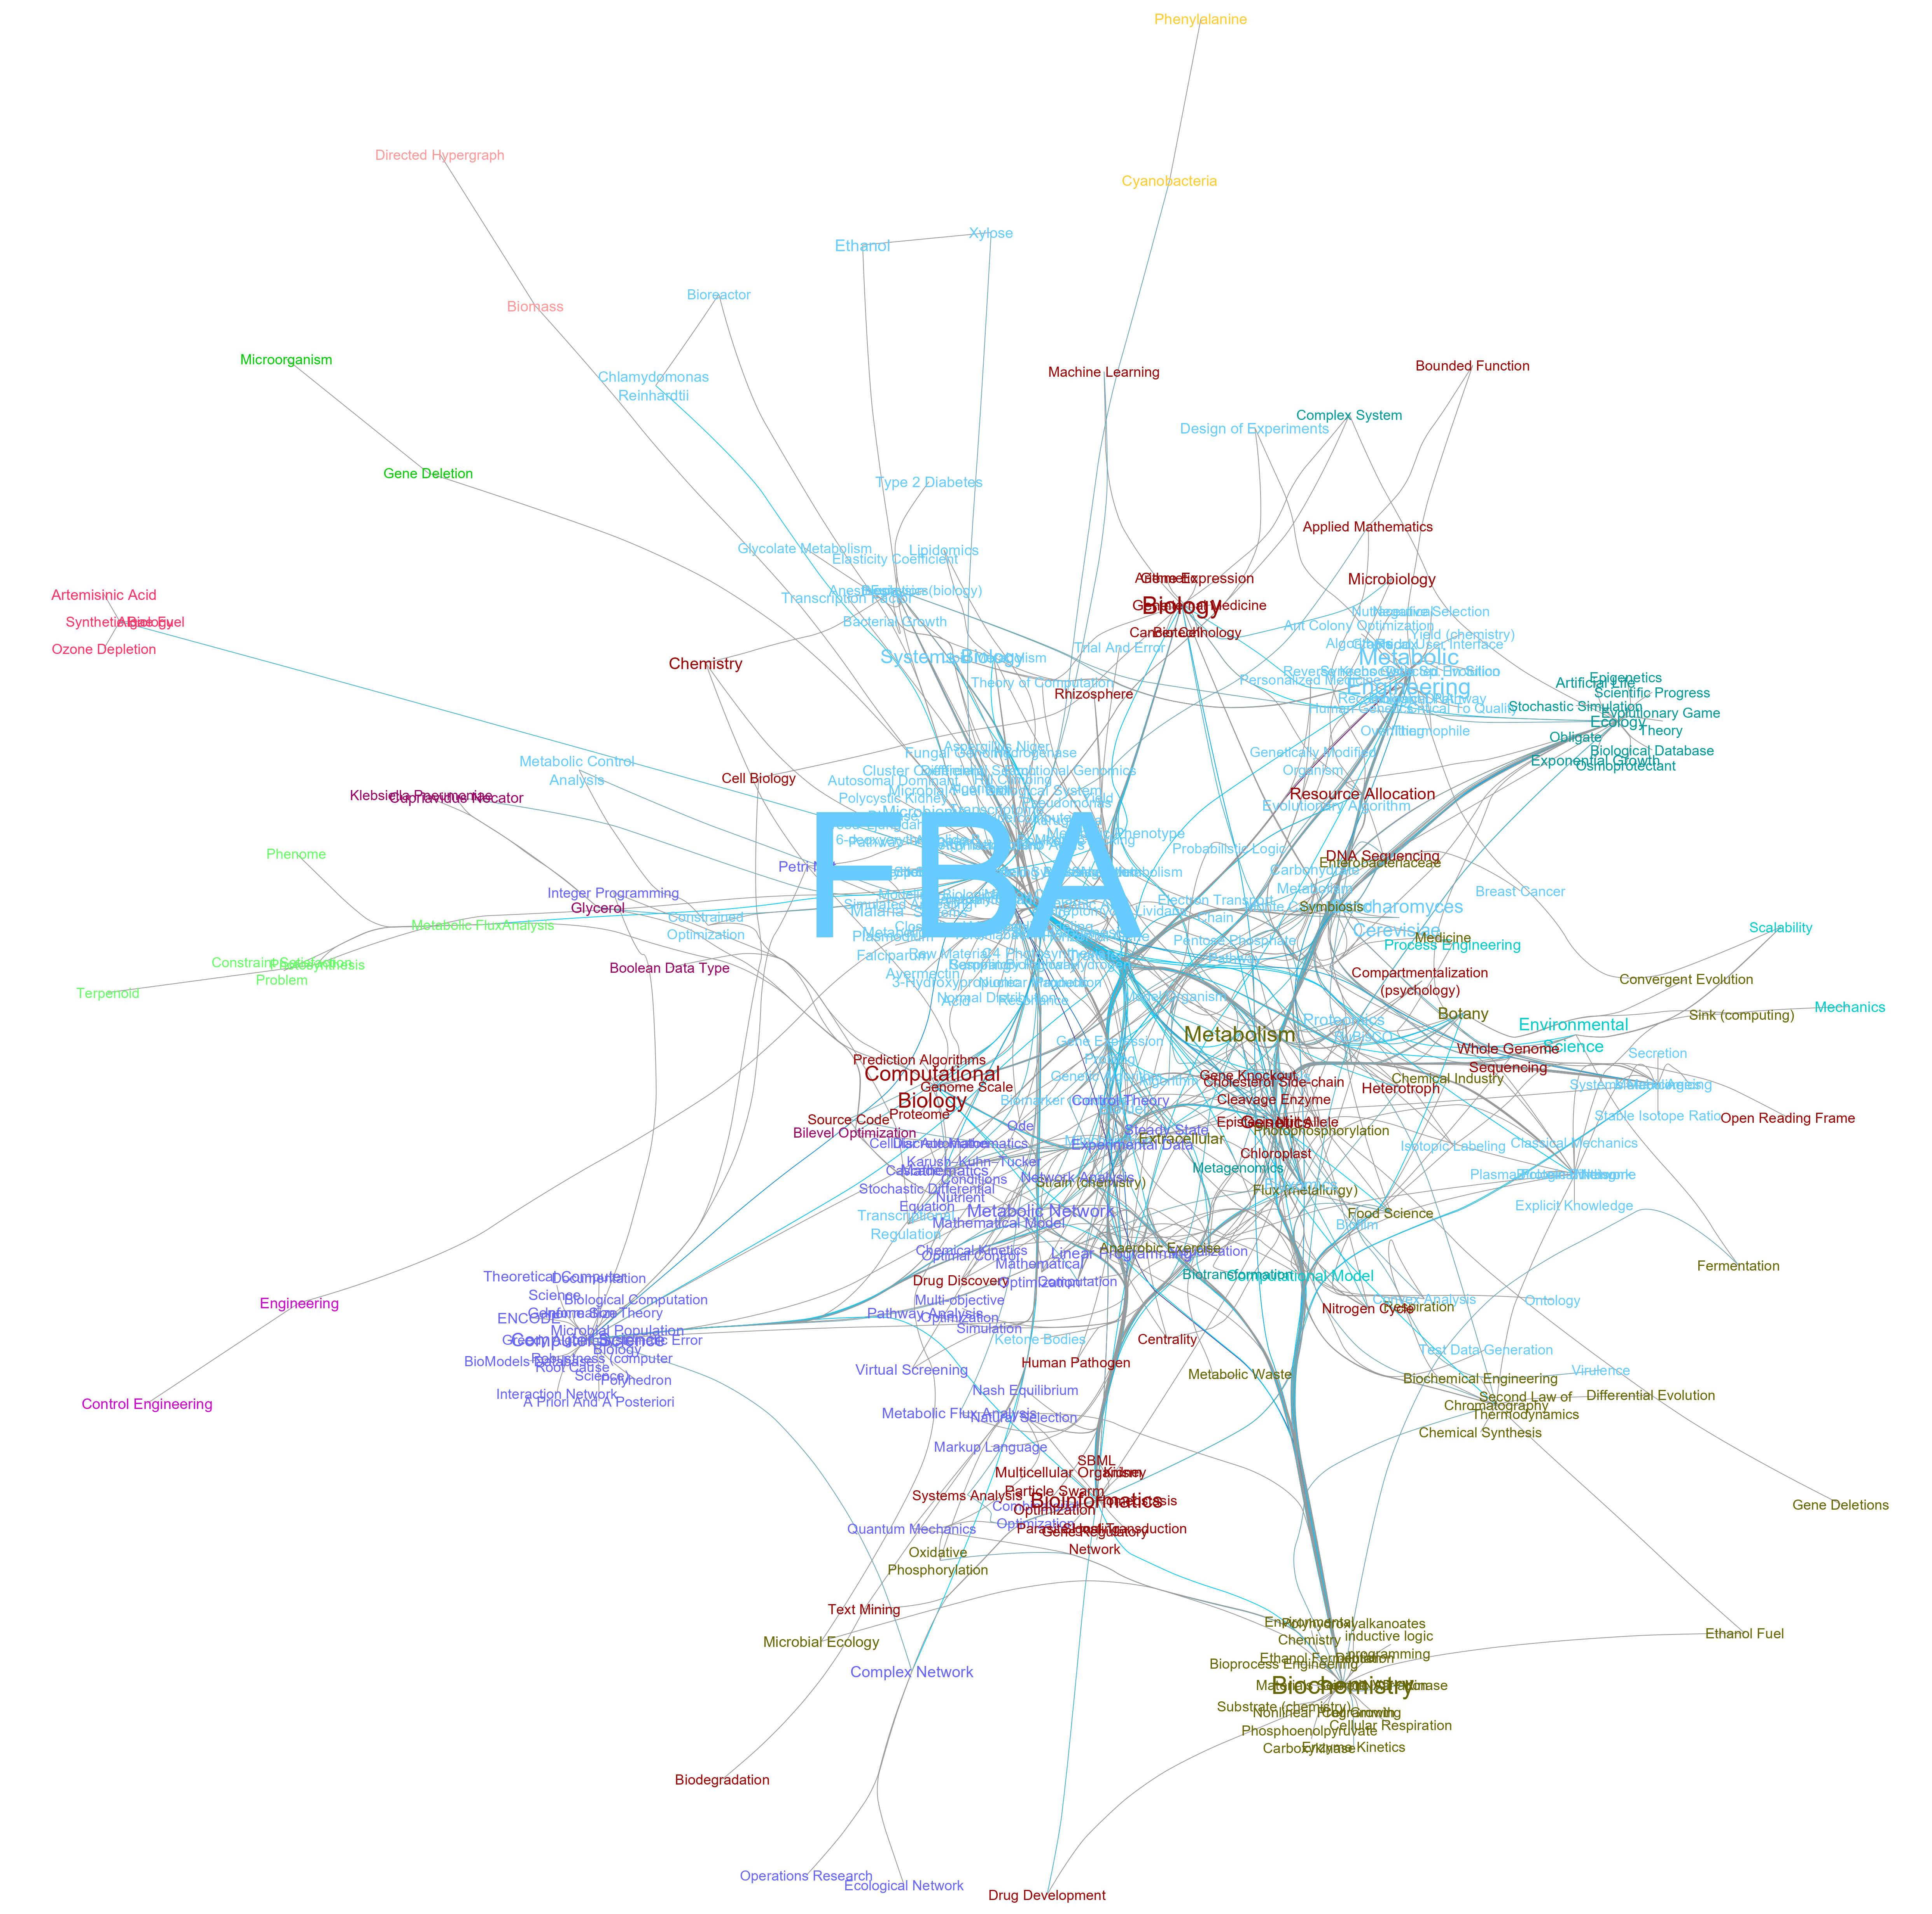
估计阅读时长: 7 分钟https://github.com/rsharp-lang/bing-academic 我们在进行一个新的课题项目开始之前,会需要经历过一个开题立项的报告过程。在这个过程之中,我们需要收集与课题相关的信息,例如相关的知识背景信息,建立出一个与课题相关的知识网络。基于此知识网络进行课题的技术相关概念的梳理。

代谢组学那堆名词我上次查资料时也手抄过一页,QC 样本、保留时间、m/z 这些混在一张表里,来回对照着看特别费劲。你这篇把英文缩写和中文解释排在一起,省了我不少翻文献的功夫,尤其是代谢物鉴定那几段。
文中提出的"能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢?"让我想到一个需要先厘清的问题:把Family层级的分类当作细胞分群标签时,功能相似性与亲缘关系可能会混在一起,图上的聚集未必能直接解释为代谢功能接近。如果借用单细胞分析中的降维流程,是否可以同时标注物种分类和基因组注释完整度,看看分离主要对应哪一种差异?尤其是这里用的是EC注释的TF-IDF矩阵,缺少某项注释究竟代表功能缺失还是未被识别,也可能影响对分群结果的判断。
这个角度之前没想到,零分布原理及其在生物信息学中的应用 确实值得深入了解。刚好之前看过,可以对照着看看。
Greetings! I stumbled upon this really useful site and figured I'd thanks for you post at here.
This content speaks to hearts