
估计阅读时长: 7 分钟https://github.com/xieguigang/mzkit SMILES字符串是一种在计算化学领域内使用线性ASCII字符串描述一个具有空间立体结构的分子结构所使用的一种语言规范。因为在工作中会需要使用到SMILES字符串做一些分子结构相关的数据建模分析,所以编写了一个很方便的用于SMILES字符串解析操作的模块,在这篇文章中为大家讲解具体的工作原理。
估计阅读时长: 2 分钟https://github.com/xieguigang/mzkit 在BILIBILI上观看视频:《【BioNovoGene Mzkit教程】代谢组学原始数据处理基础》
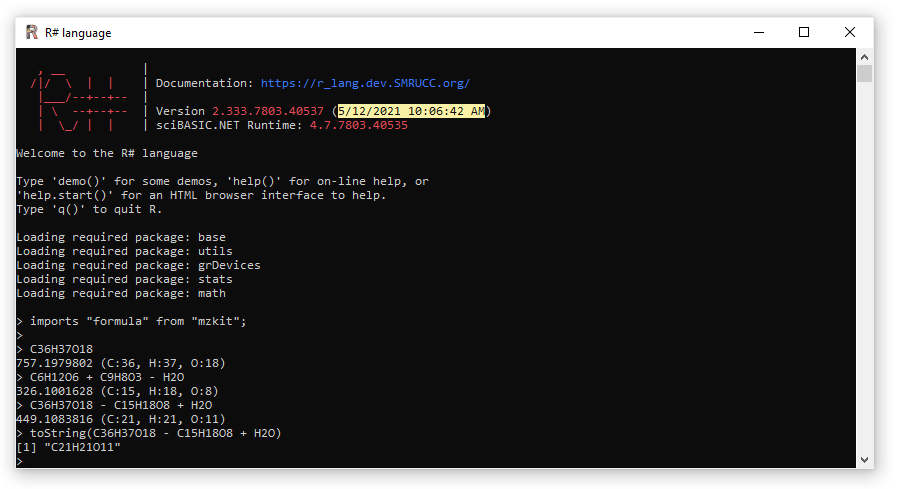
估计阅读时长: 4 分钟根据工作的需要,我为R#脚本解释器添加了一个符号计算的功能,这个符号语言特性在进行一些化学信息学分析的时候会非常有用。例如,我们在分析一些天然产物的质谱数据的时候,会需要通过母离子减掉一些糖来进行中性丢失的计算,基于中性丢失计算来进行一些解谱分析操作。在这个过程之中,化学式符号计算就可以派上很大用场了。假设我们有一个天然产物Cyanidin 3-glucoside-5-(6-p-coumaroylglucoside),从名称我们就可以看出这个天然产物是由一个Cyanidin母核,加上两个葡萄糖以及一个coumaroyl基团构成。这个天然产物的分子化学式为C36H37O18,那现在我们将这个化学式输入到R#解释器之中,按下回车就可以很清楚的了解到这个化学式的元素构成 > C36H37O18 757.1979802 (C:36, H:37, O:18) 如果想要使用这个特性,需要在R#终端上导入mzkit程序包模块:imports "formula" from "mzkit";

代谢组学那堆名词我上次查资料时也手抄过一页,QC 样本、保留时间、m/z 这些混在一张表里,来回对照着看特别费劲。你这篇把英文缩写和中文解释排在一起,省了我不少翻文献的功夫,尤其是代谢物鉴定那几段。
文中提出的"能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢?"让我想到一个需要先厘清的问题:把Family层级的分类当作细胞分群标签时,功能相似性与亲缘关系可能会混在一起,图上的聚集未必能直接解释为代谢功能接近。如果借用单细胞分析中的降维流程,是否可以同时标注物种分类和基因组注释完整度,看看分离主要对应哪一种差异?尤其是这里用的是EC注释的TF-IDF矩阵,缺少某项注释究竟代表功能缺失还是未被识别,也可能影响对分群结果的判断。
这个角度之前没想到,零分布原理及其在生物信息学中的应用 确实值得深入了解。刚好之前看过,可以对照着看看。
Greetings! I stumbled upon this really useful site and figured I'd thanks for you post at here.
This content speaks to hearts