
估计阅读时长: 20 分钟用 GCModeller 做泛基因组分析(二):801 个大肠杆菌基因组实战 面向读者:具有一定 R 语言编程基础的生物信息学初学者、实验室里的微生物研究者。 本篇是系列的实战篇:从 GenBank 原始注释文件出发,用两条 R# 脚本跑完大肠杆菌的泛基因组分析, 并结合真实运行产出的结果文件逐项解读。算法原理(CD-HIT 聚类、PAV 矩阵、香农信息熵等) 请先阅读系列第一篇《用 […]
估计阅读时长: 16 分钟用 GCModeller 做泛基因组分析(一):算法原理与香农信息熵 面向读者:具有一定 R 语言编程基础的生物信息学初学者、实验室里的微生物研究者。 本篇讲清楚两件事:GCModeller 的泛基因组分析是怎么算的,以及贯穿整个分析体系的"香农信息熵"到底在度量什么。 全文不依赖任何编程知识,算法原理一律用公式和自然语言伪代码讲解。实战操作请看系列第二篇。 1. 什么是泛基因组? 把大肠杆菌的两个菌株的基因组摆在一起看,你会发现一个 surprising 的事实:这两个"同一个物种"的基因组,基因组成可能相差 20% 以上。K-12 […]
估计阅读时长: 5 分钟基因组 为了能够实现上面所描述的这种基于EC Number的不同层级的加权嵌入,我们在原来的基因组嵌入工具上添加了一个hierarchical选项,用于支持切换为层级嵌入的操作: Imports Microsoft.VisualBasic.Data.Framework Imports Microsoft.VisualBasic.Data.NLP Imports SMRUCC.genomics.Interops.NCBI.Extensions.Pipeline Public Class GenomeMetabolicEmbedding ReadOnly vec As New […]
估计阅读时长: 20 分钟最近的工作中我需要按照之前的这篇博客文章《基因组功能注释(EC Number)的向量化嵌入》中所描述的流程,将好几十万个微生物基因组的功能蛋白进行酶编号的比对注释,然后基于注释结果进行向量化嵌入然后进行数据可视化。通过R#脚本对这些微生物基因组的蛋白fasta序列的提取操作,最终得到了一个大约是58GB的蛋白序列。然后将这个比较大型的蛋白序列比对到自己所收集到的ec number注释的蛋白序列参考数据库之上。 AttachmentsSort by:DefaultDateName diamond-output • 41 KB • 517 click 15.02.2026diamond-table-size • 19 KB […]
估计阅读时长: 17 分钟EC Number是国际酶学委员会(IUBMB)制定的一套酶分类编号体系,EC Number采用层级分类法,由4个数字组成,分别代表酶的大类、亚类、亚亚类和序号。例如,“EC 1.1.1.37”中,第一个“1”表示氧化还原酶大类;第二个“1”表示作用于CH-OH基团;第三个“1”表示以NAD+或NADP+为受体的酶;第四个“37”表示特定酶苹果酸脱氢酶。这种层次结构意味着EC编号蕴含了丰富的功能信息,包括酶催化的反应类型和底物/机制。将EC Number嵌入为向量,有助于我们利用机器学习模型进行功能预测、相似性分析等。 AttachmentsSort by:DefaultDateName Capture • 14 KB • 606 click 08.02.2026ec_numbers • […]
估计阅读时长: 22 分钟MSA(多序列比对)在生物信息学中的核心目标是:通过把多条同源序列“对齐”,来突出它们之间的相似与差异,从而帮助我们:识别保守区/功能位点、推断进化关系(系统发生)、预测或解释蛋白质/核酸结构、发现共进化与功能模块,以及为后续分析(如模体搜索、结构建模、从头设计等)提供基础。基于多序列比对分析,我们可以通过这种算法,把一堆表面看上去“乱糟糟”的序列,整理成一个可以“逐位点比较”的框架。基于我们所得到的这个框架基础,我们可以进行下游的后续分析,例如: 识别哪些部分是“不能动”的(功能/结构核心); 推断它们是如何“进化而来”的(系统发生); 推测它们在空间中“长什么样”(结构预测与建模); 找出哪些部分“一起变化”(共进化与功能耦合); 并把这些信息封装成模型(HMM、profile)用于大规模搜索与注释。 AttachmentsSort by:DefaultDateName MSA • 174 KB • 694 click 08.01.2026MSA_console […]
估计阅读时长: 16 分钟KEGG 里面目前并没有“现成的每个 KO 一条代表性序列 FASTA”这种官方序列数据库,假若我们需要基于KEGG数据库中的KO信息的注释,那我们一般会需要自己从 KEGG GENES 里面把每个 KO 对应的基因/蛋白序列抓出来,再按 KO 编号组织成 fasta 集合构建出对应的数据库。基于所建立好的KEGG基因序列数据库,我们就可以实现下面的一些基因注释工作: 在全基因组规模代谢网络重建工作中,进行我们的目标基因组中的代谢网络中的酶节点的直系同源推断,从而将我们的目标基因组中的基因映射到具体的KEGG代谢网络上的节点位置,从而重建出代谢网络模型(使用带有KO编号的蛋白序列做比对注释) 假若我们在进行宏基因组的基因丰度的计算,则可以基于所建立的KEGG基因序列数据库作为参考库,进行宏基因组测序数据中的KO基因丰度的计算(使用带有KO编号的基因序列做比对注释) […]
估计阅读时长: 34 分钟在前面写了一篇文章来介绍我们可以如何通过KEGG的BHR评分来注释直系同源。在KEGG数据库的同源注释算法中,BHR的核心思想是“双向最佳命中”。它比简单的单向BLAST搜索(例如,只看你的基因A在数据库里的最佳匹配是基因B)更为严格和可靠。在基因注释中,这种方法可以有效减少因基因家族扩张、结构域保守等原因导致的假阳性注释,从而更准确地识别直系同源基因,而直系同源基因通常具有相同的功能。在今天重新翻看了下KAAS的帮助文档之后,发现KAAS系统中更新了下面的Assignment score计算公式: We define a score for each ortholog group in order to assign the best […]
估计阅读时长: 7 分钟一般而言,进行全基因组的转录表达调控网络的建立,我们需要基于两个数据结果来完成: 目标基因的转录调控位点信息(Motif搜索结果,构成网络之中的节点) 转录调控位点相应的转录调控因子(Motif位点相关的转录调控因子,构成网络之中的边连接) AttachmentsSort by:DefaultDateName Xor • 271 KB • 1126 click 11.06.2022An integrated multi-omics approach […]

This content speaks to hearts
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 对于基于ec number来生成层级数据,我们直接使用《酶EC编号结构解析》文章末尾所展示的层级数据生成函数来实现。 […]
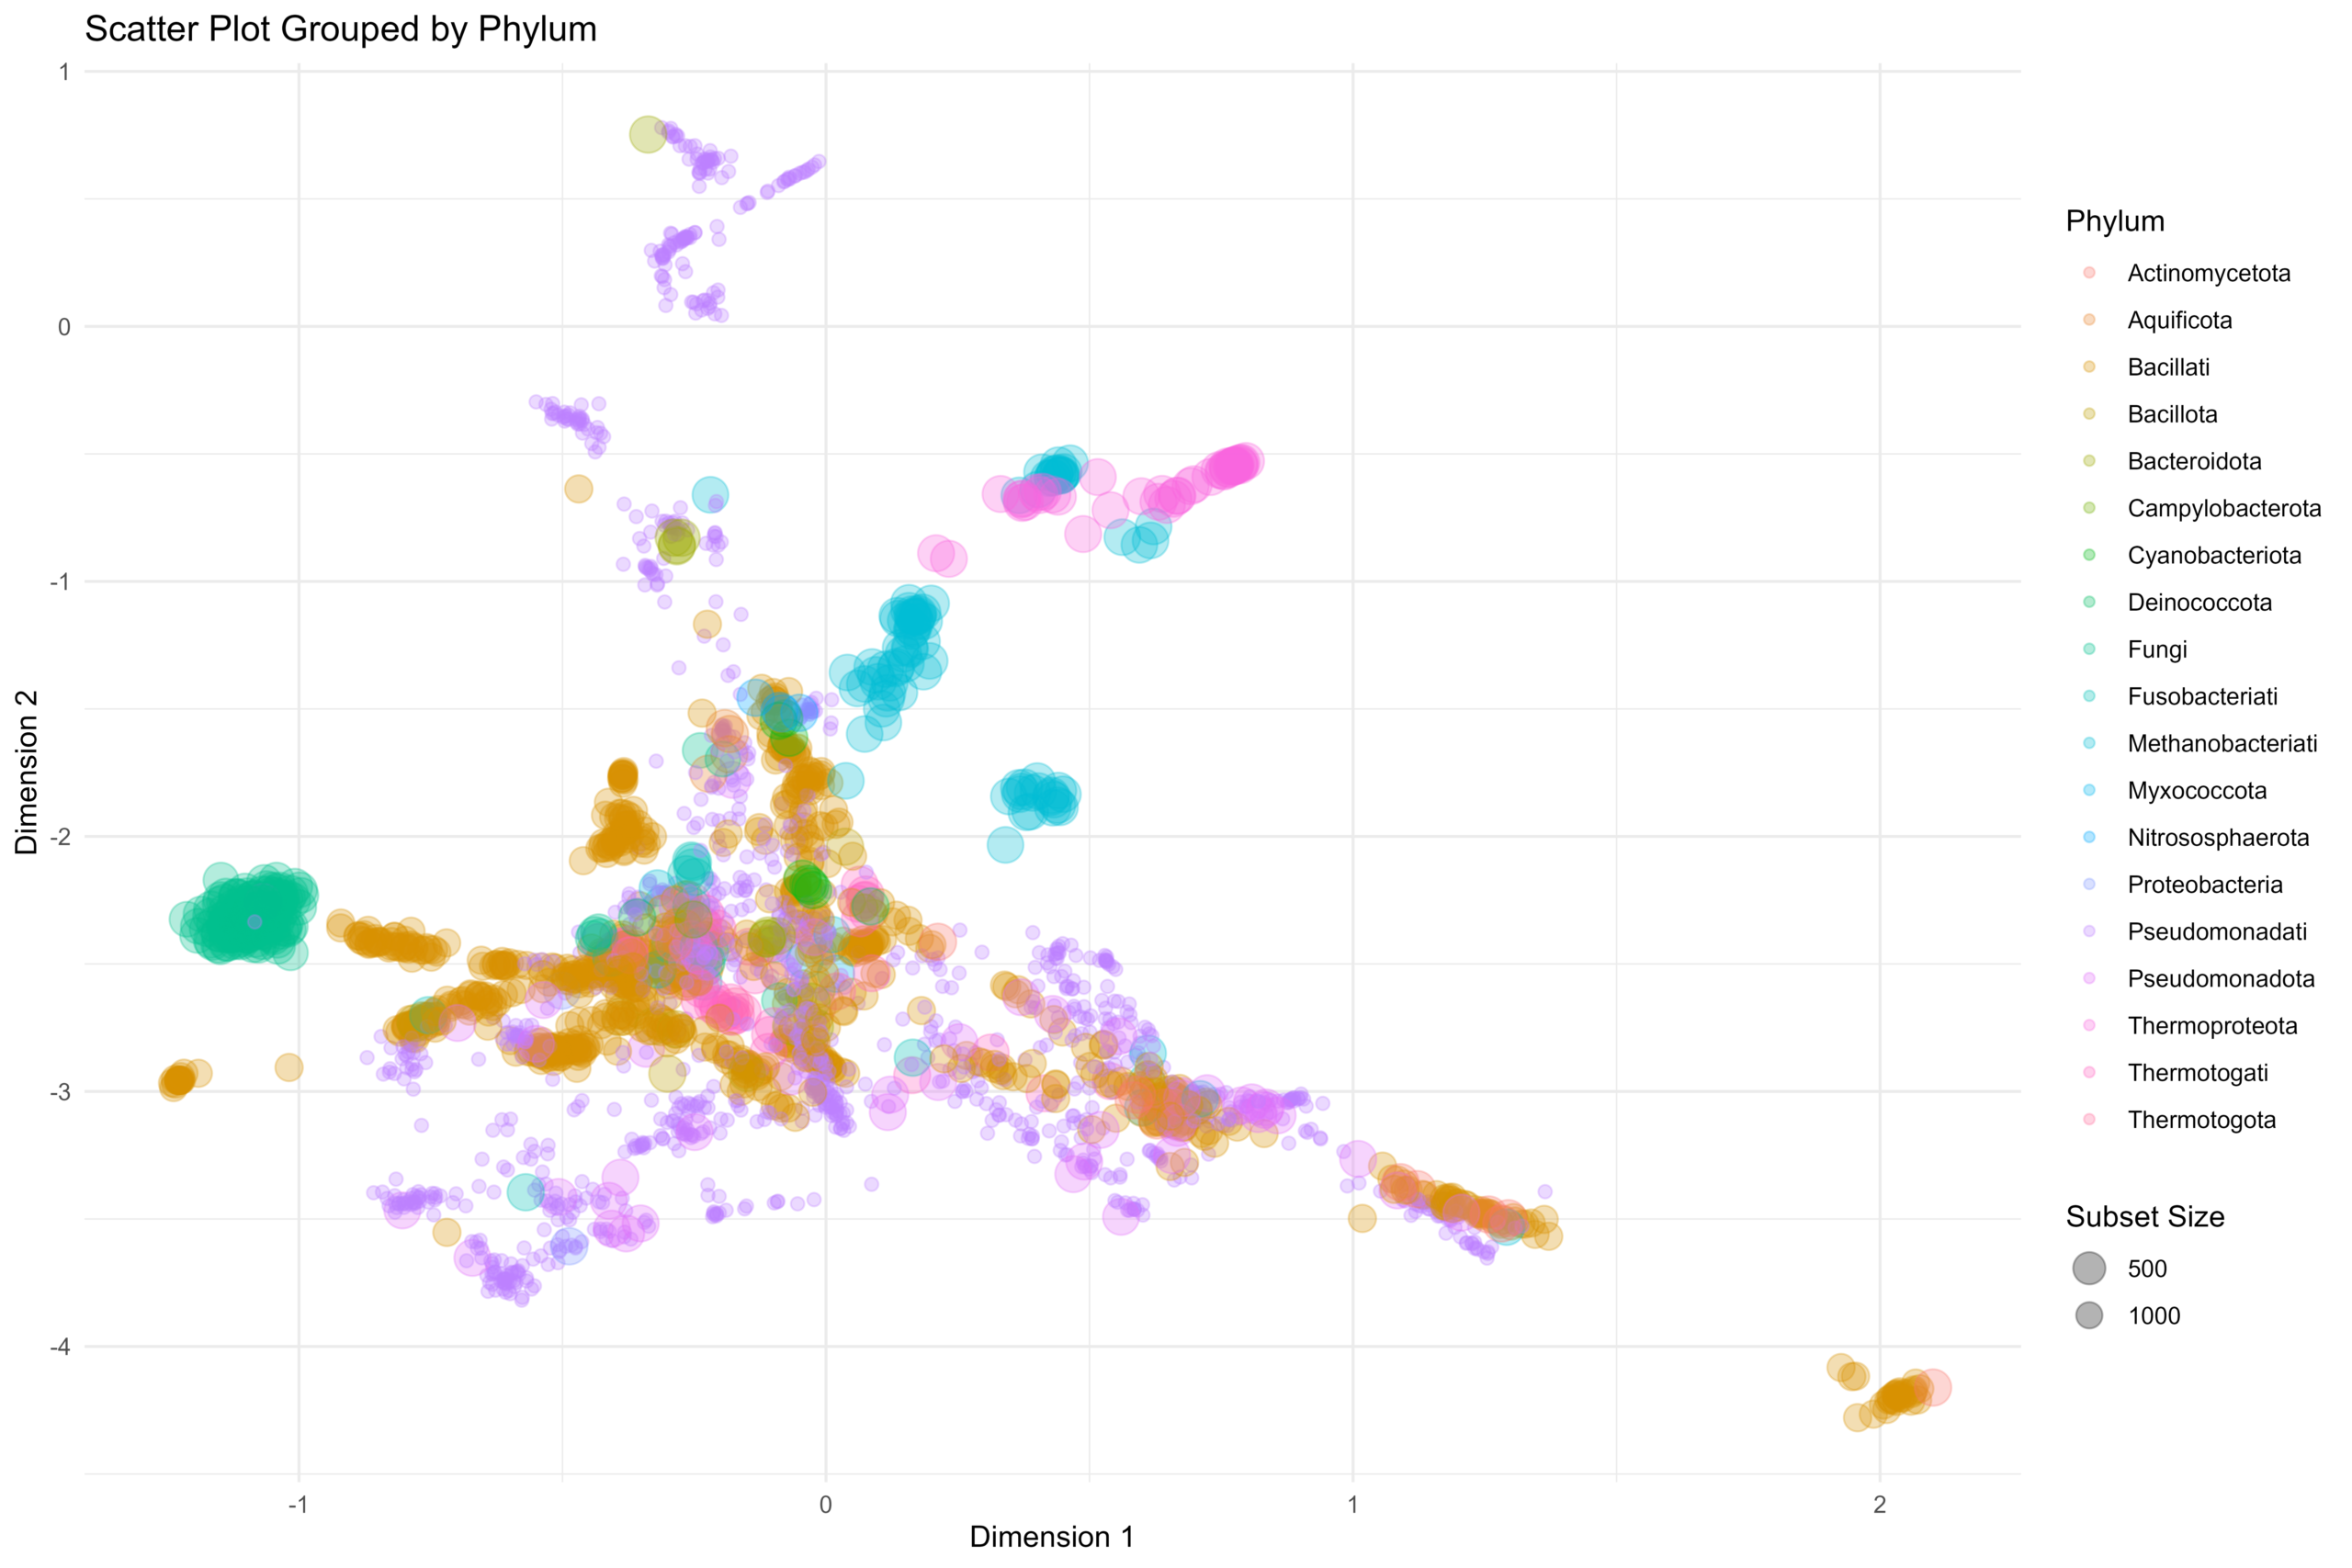
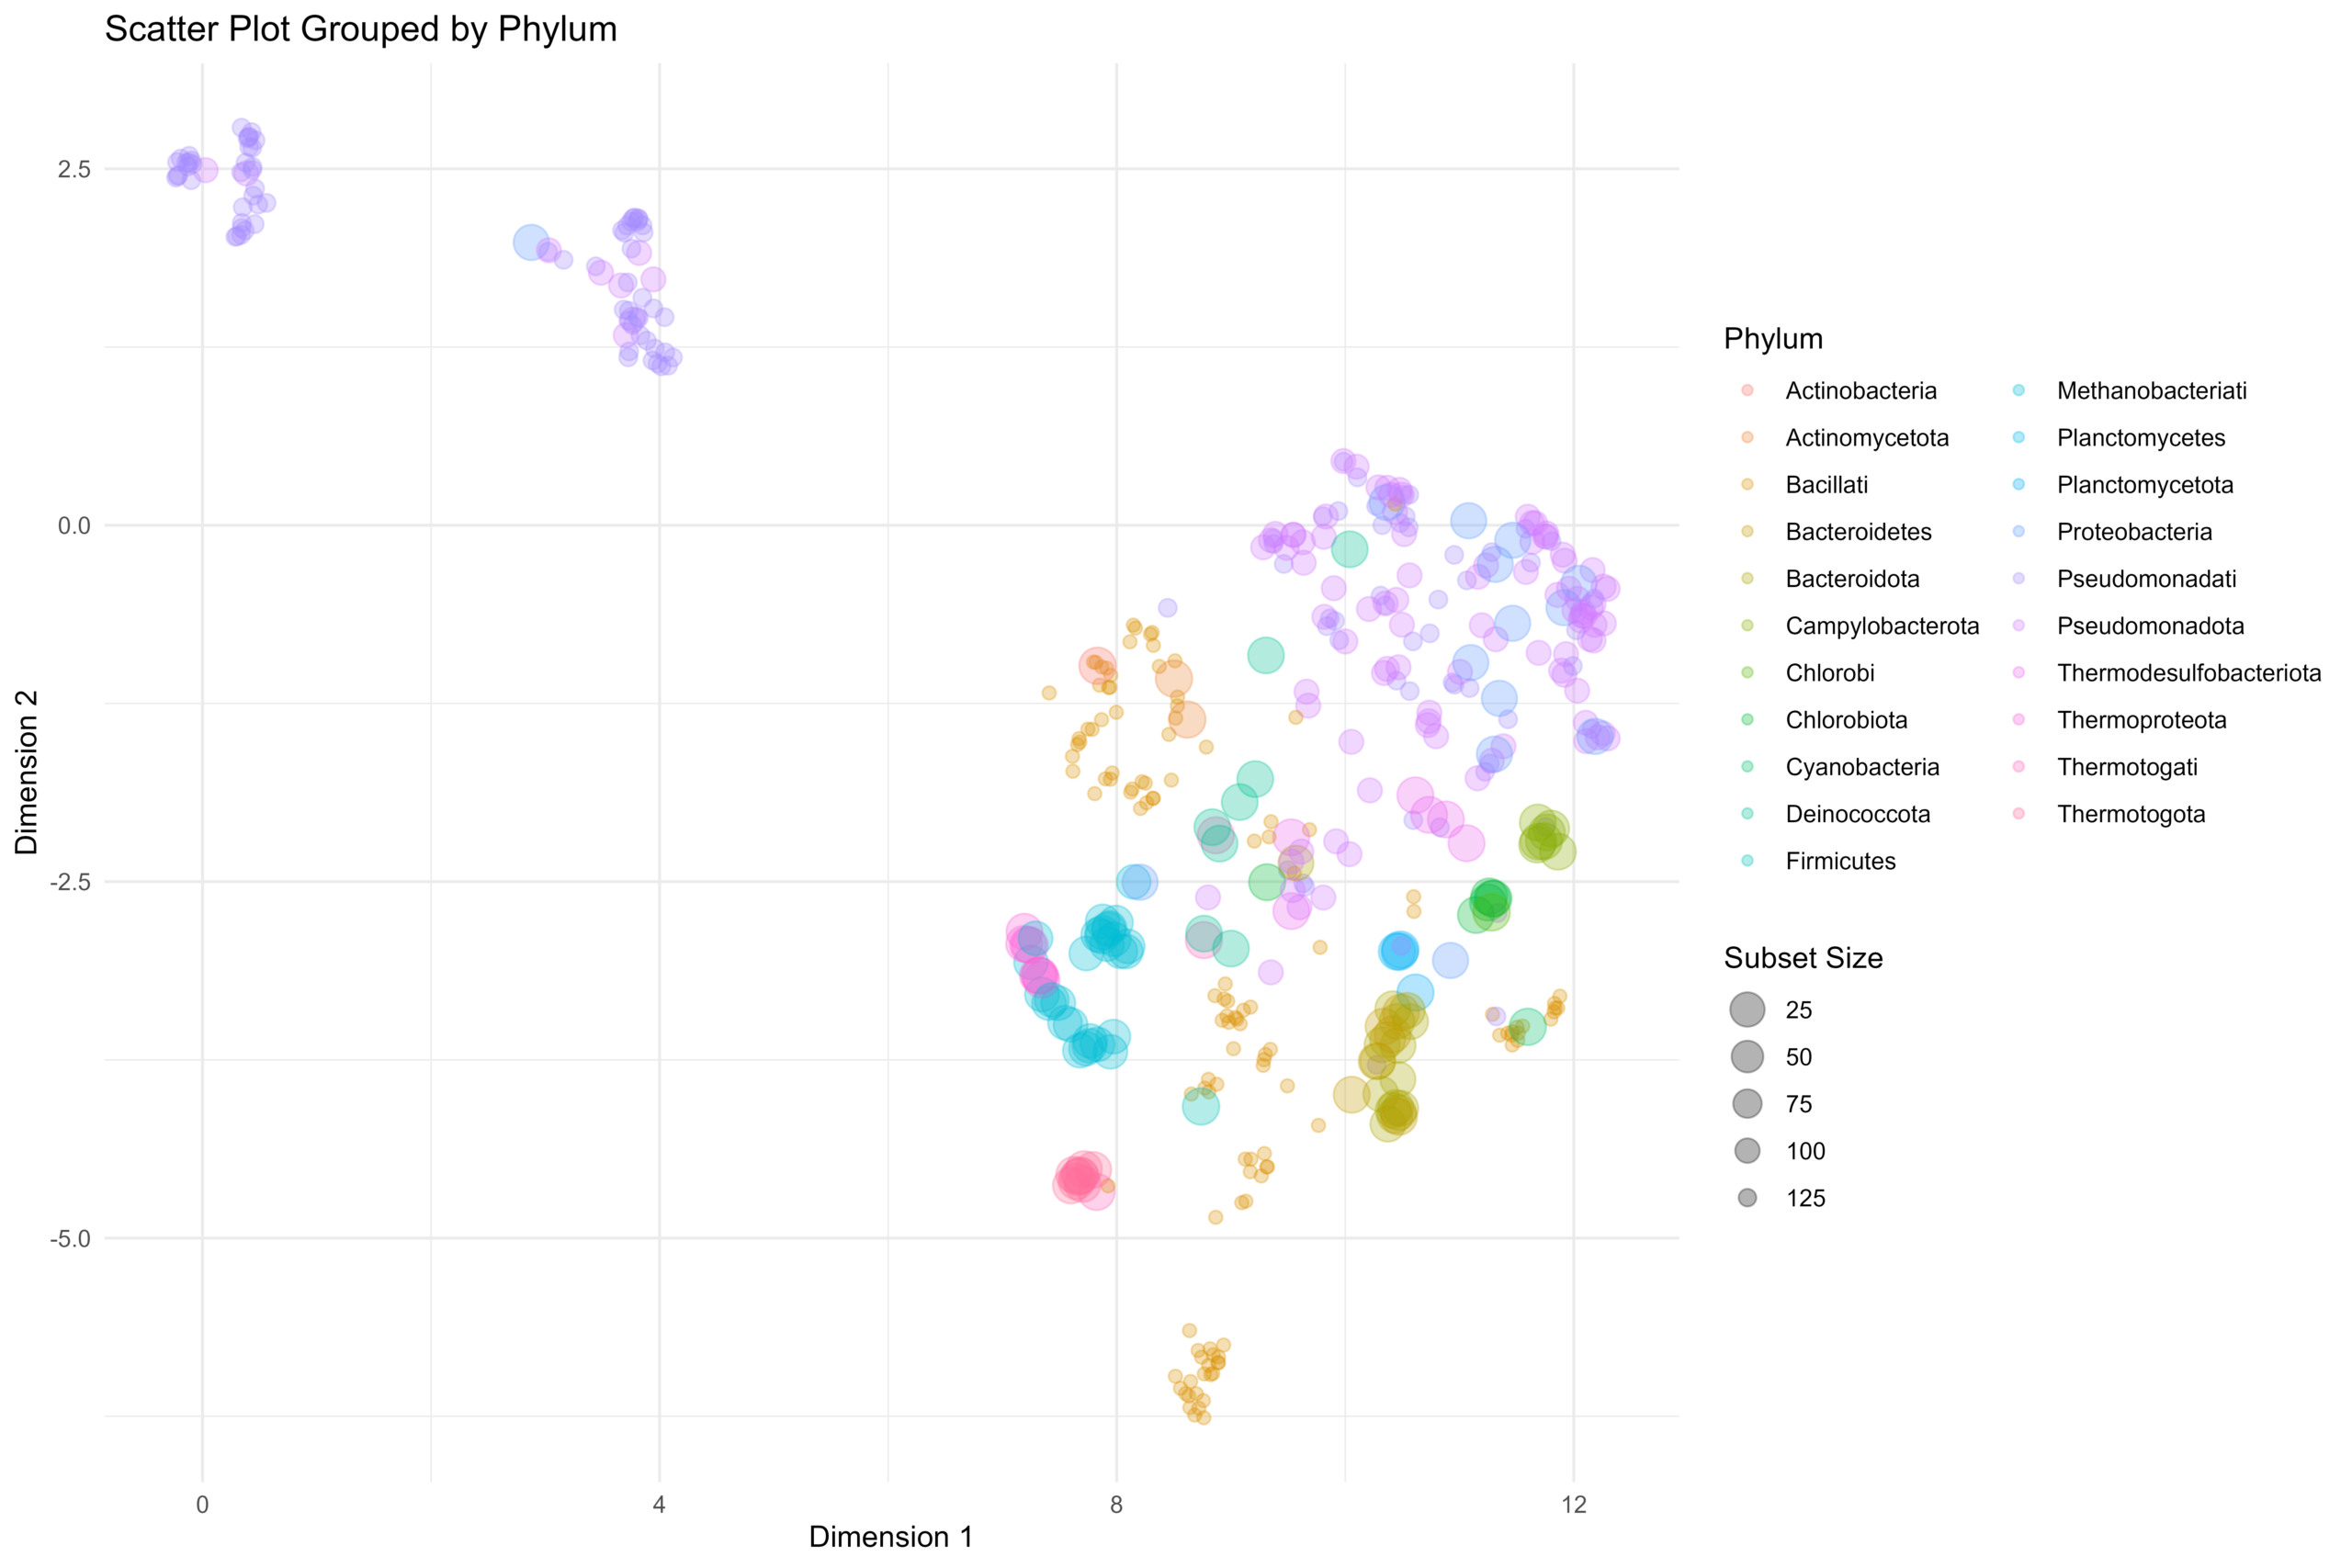
[…] 在前面的一篇《基因组功能注释(EC Number)的向量化嵌入》博客文章中,针对所注释得到的微生物基因组代谢信息,进行基于TF-IDF的向量化嵌入之后。为了可视化向量化嵌入的效果,通过UMAP进行降维,然后基于降维的结果进行散点图可视化。通过散点图可视化可以发现向量化的嵌入结果可以比较好的将不同物种分类来源的微生物基因组区分开来。 […]