
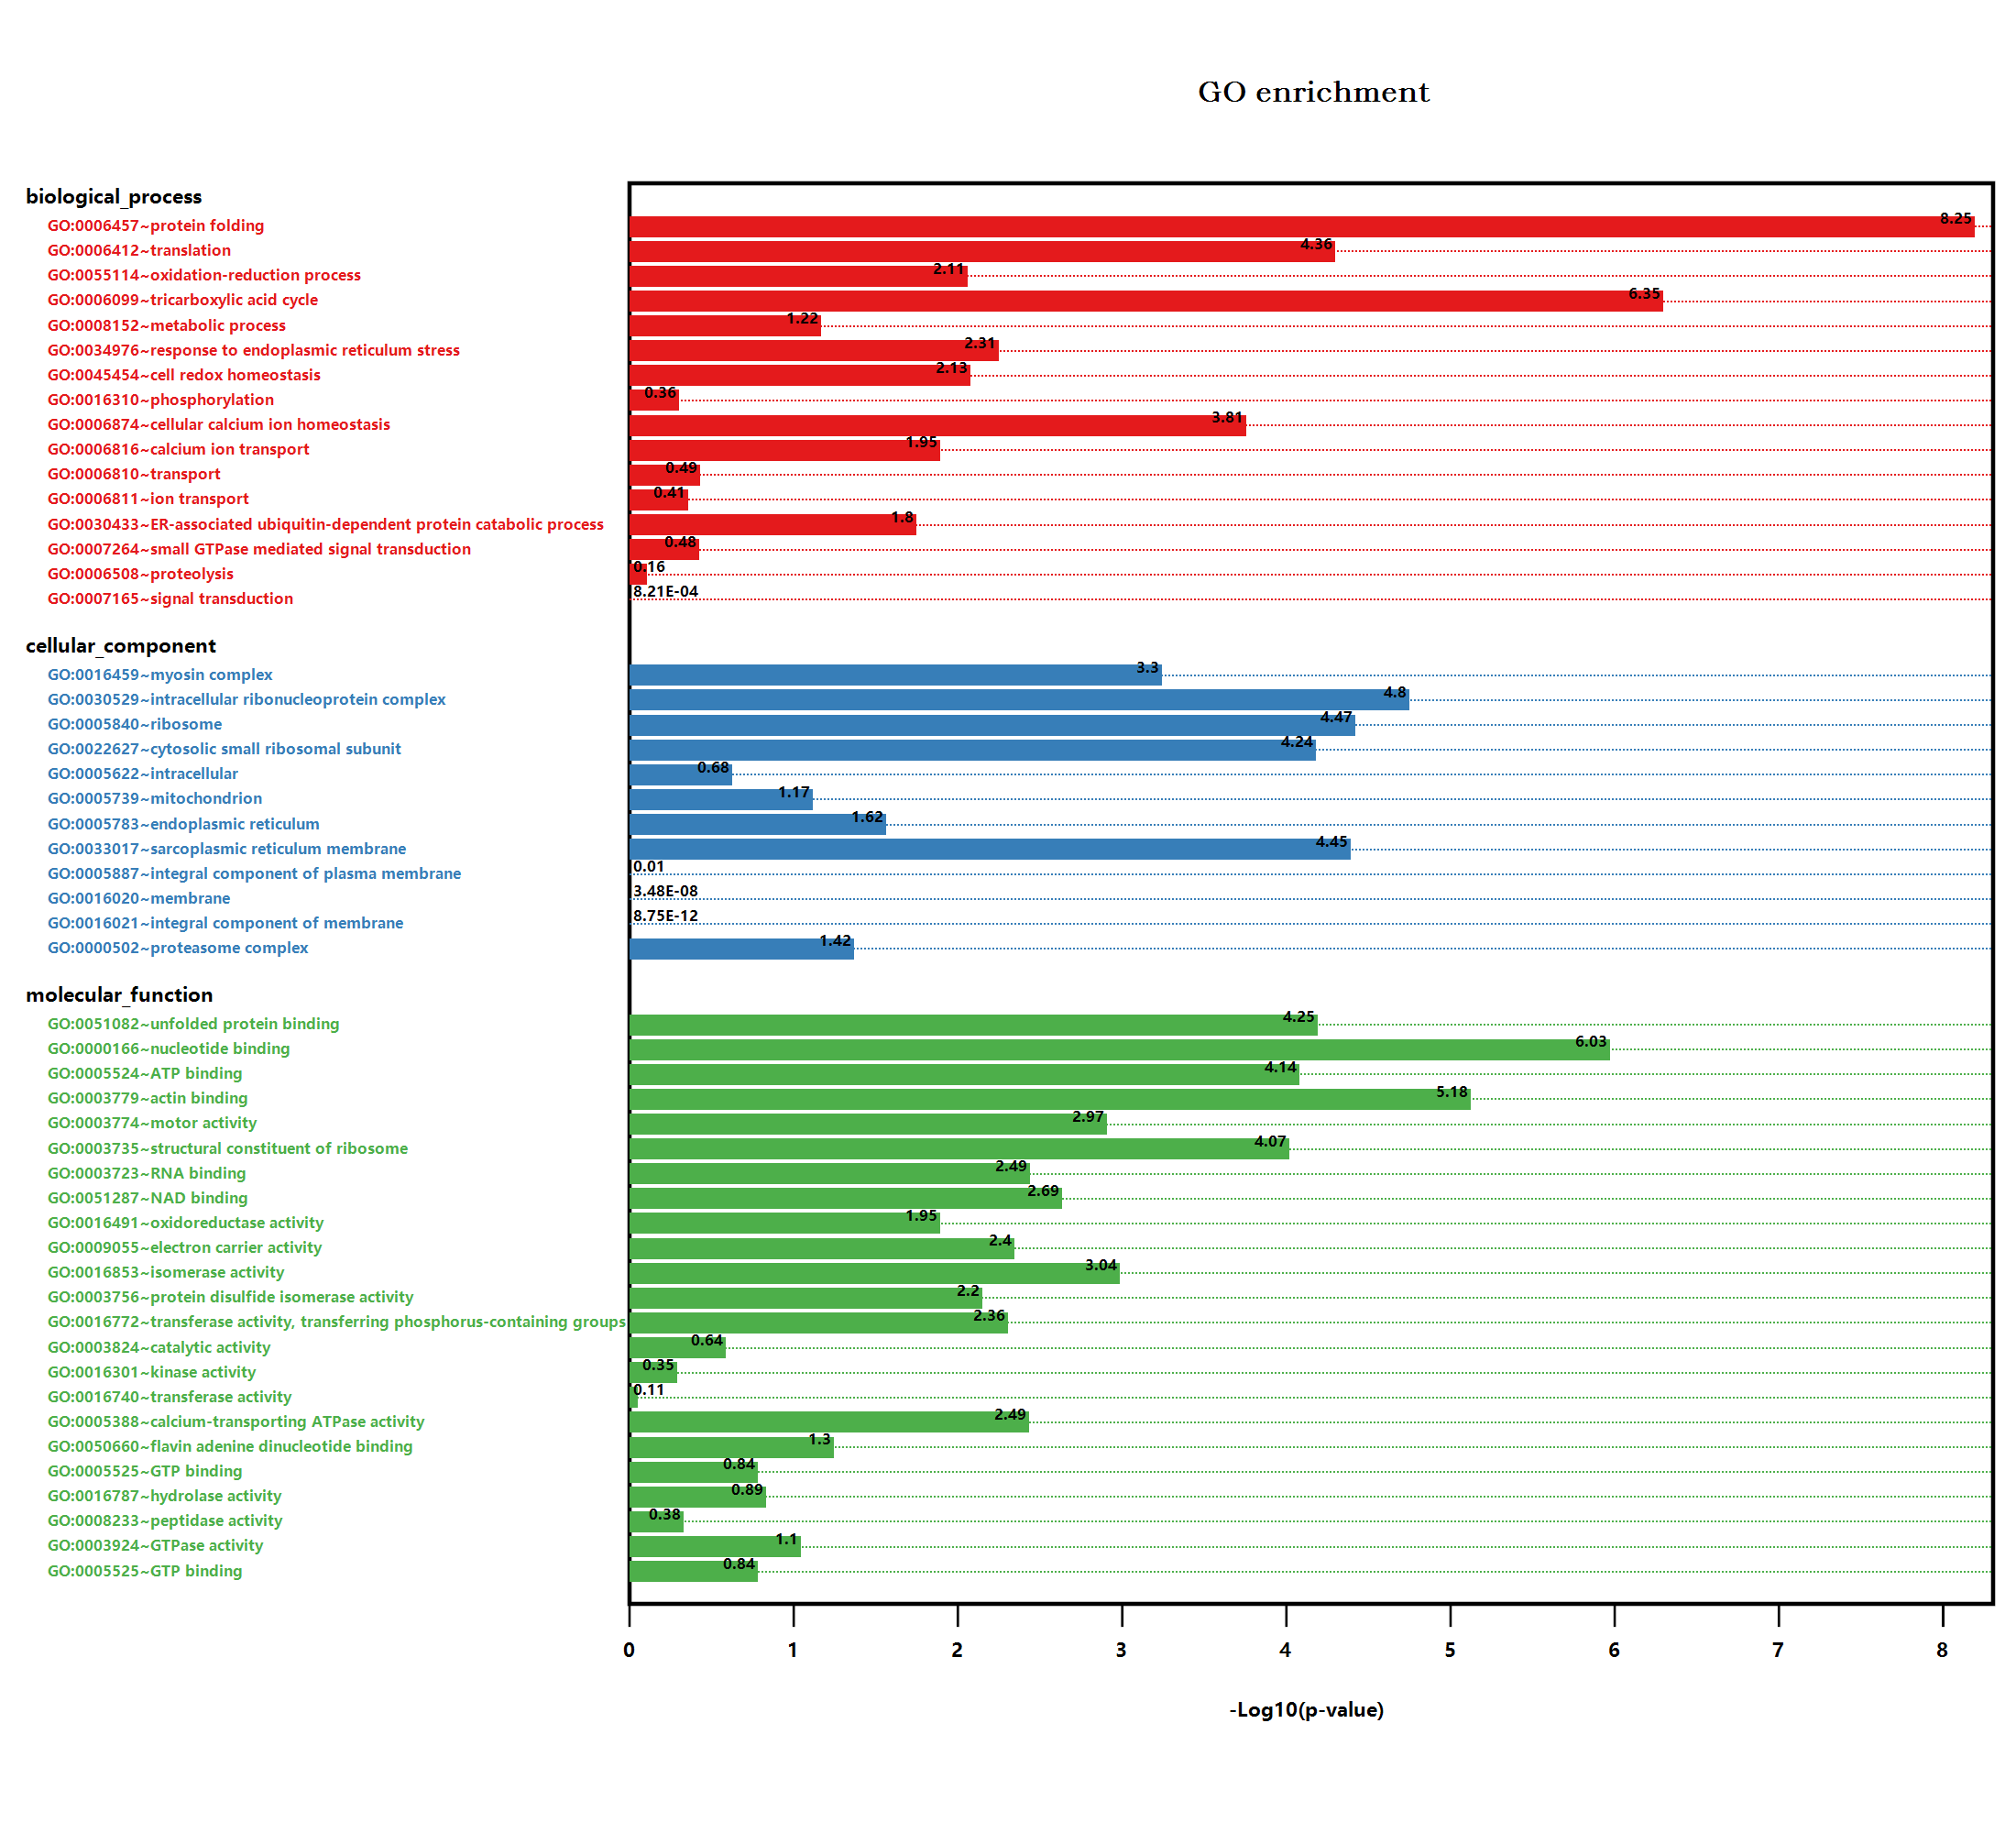
估计阅读时长: 20 分钟最近的工作中我需要按照之前的这篇博客文章《基因组功能注释(EC Number)的向量化嵌入》中所描述的流程,将好几十万个微生物基因组的功能蛋白进行酶编号的比对注释,然后基于注释结果进行向量化嵌入然后进行数据可视化。通过R#脚本对这些微生物基因组的蛋白fasta序列的提取操作,最终得到了一个大约是58GB的蛋白序列。然后将这个比较大型的蛋白序列比对到自己所收集到的ec number注释的蛋白序列参考数据库之上。 AttachmentsSort by:DefaultDateName diamond-output • 41 KB • 515 click 15.02.2026diamond-table-size • 19 KB […]
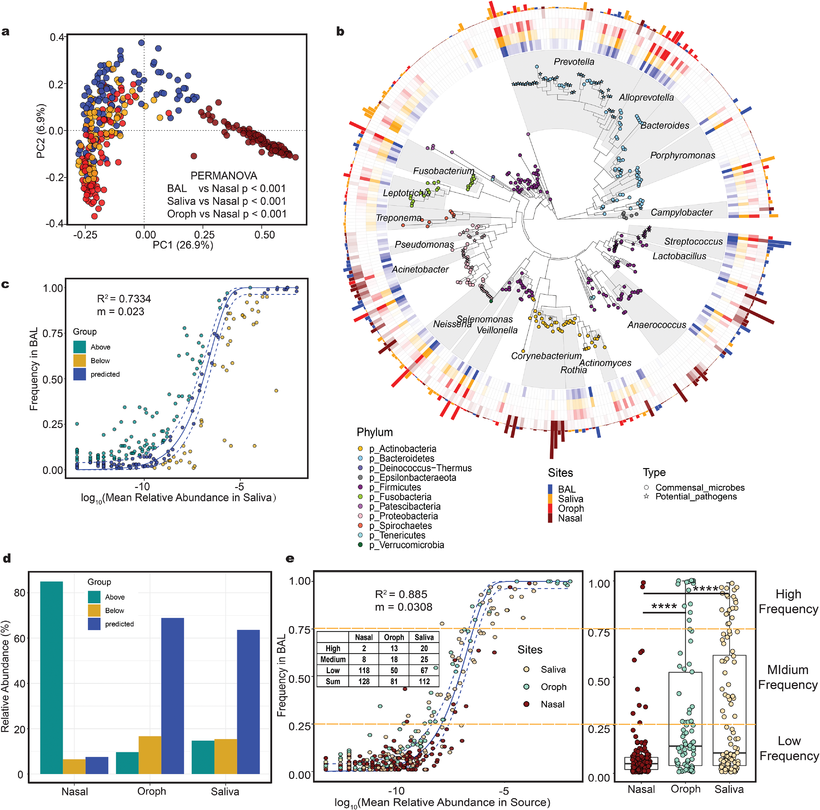
估计阅读时长: < 1 分钟UPGMA(Unweighted Pair Group Method with Arithmetic Mean,非加权配对组平均法)是一种经典的基于距离矩阵构建系统发育树的聚类算法。其核心思想是假设进化速率恒定(分子钟假说),通过迭代合并距离最近的两个类群(或序列)来构建树。UPGMA算法具有原理简单,计算速度快,易于理解和实现。对于符合分子钟假说(即所有分支进化速率相同)的数据,能给出正确的拓扑结构这些优点。但是其“进化速率恒定”的假设在现实中常常不成立。如果数据存在明显的速率差异(即存在长枝),UPGMA可能会构建出错误的树(拓扑结构错误)。因此,它更适用于进化速率相对均匀的近缘物种或基因的比较。
估计阅读时长: 17 分钟EC Number是国际酶学委员会(IUBMB)制定的一套酶分类编号体系,EC Number采用层级分类法,由4个数字组成,分别代表酶的大类、亚类、亚亚类和序号。例如,“EC 1.1.1.37”中,第一个“1”表示氧化还原酶大类;第二个“1”表示作用于CH-OH基团;第三个“1”表示以NAD+或NADP+为受体的酶;第四个“37”表示特定酶苹果酸脱氢酶。这种层次结构意味着EC编号蕴含了丰富的功能信息,包括酶催化的反应类型和底物/机制。将EC Number嵌入为向量,有助于我们利用机器学习模型进行功能预测、相似性分析等。 AttachmentsSort by:DefaultDateName Capture • 14 KB • 603 click 08.02.2026ec_numbers • […]
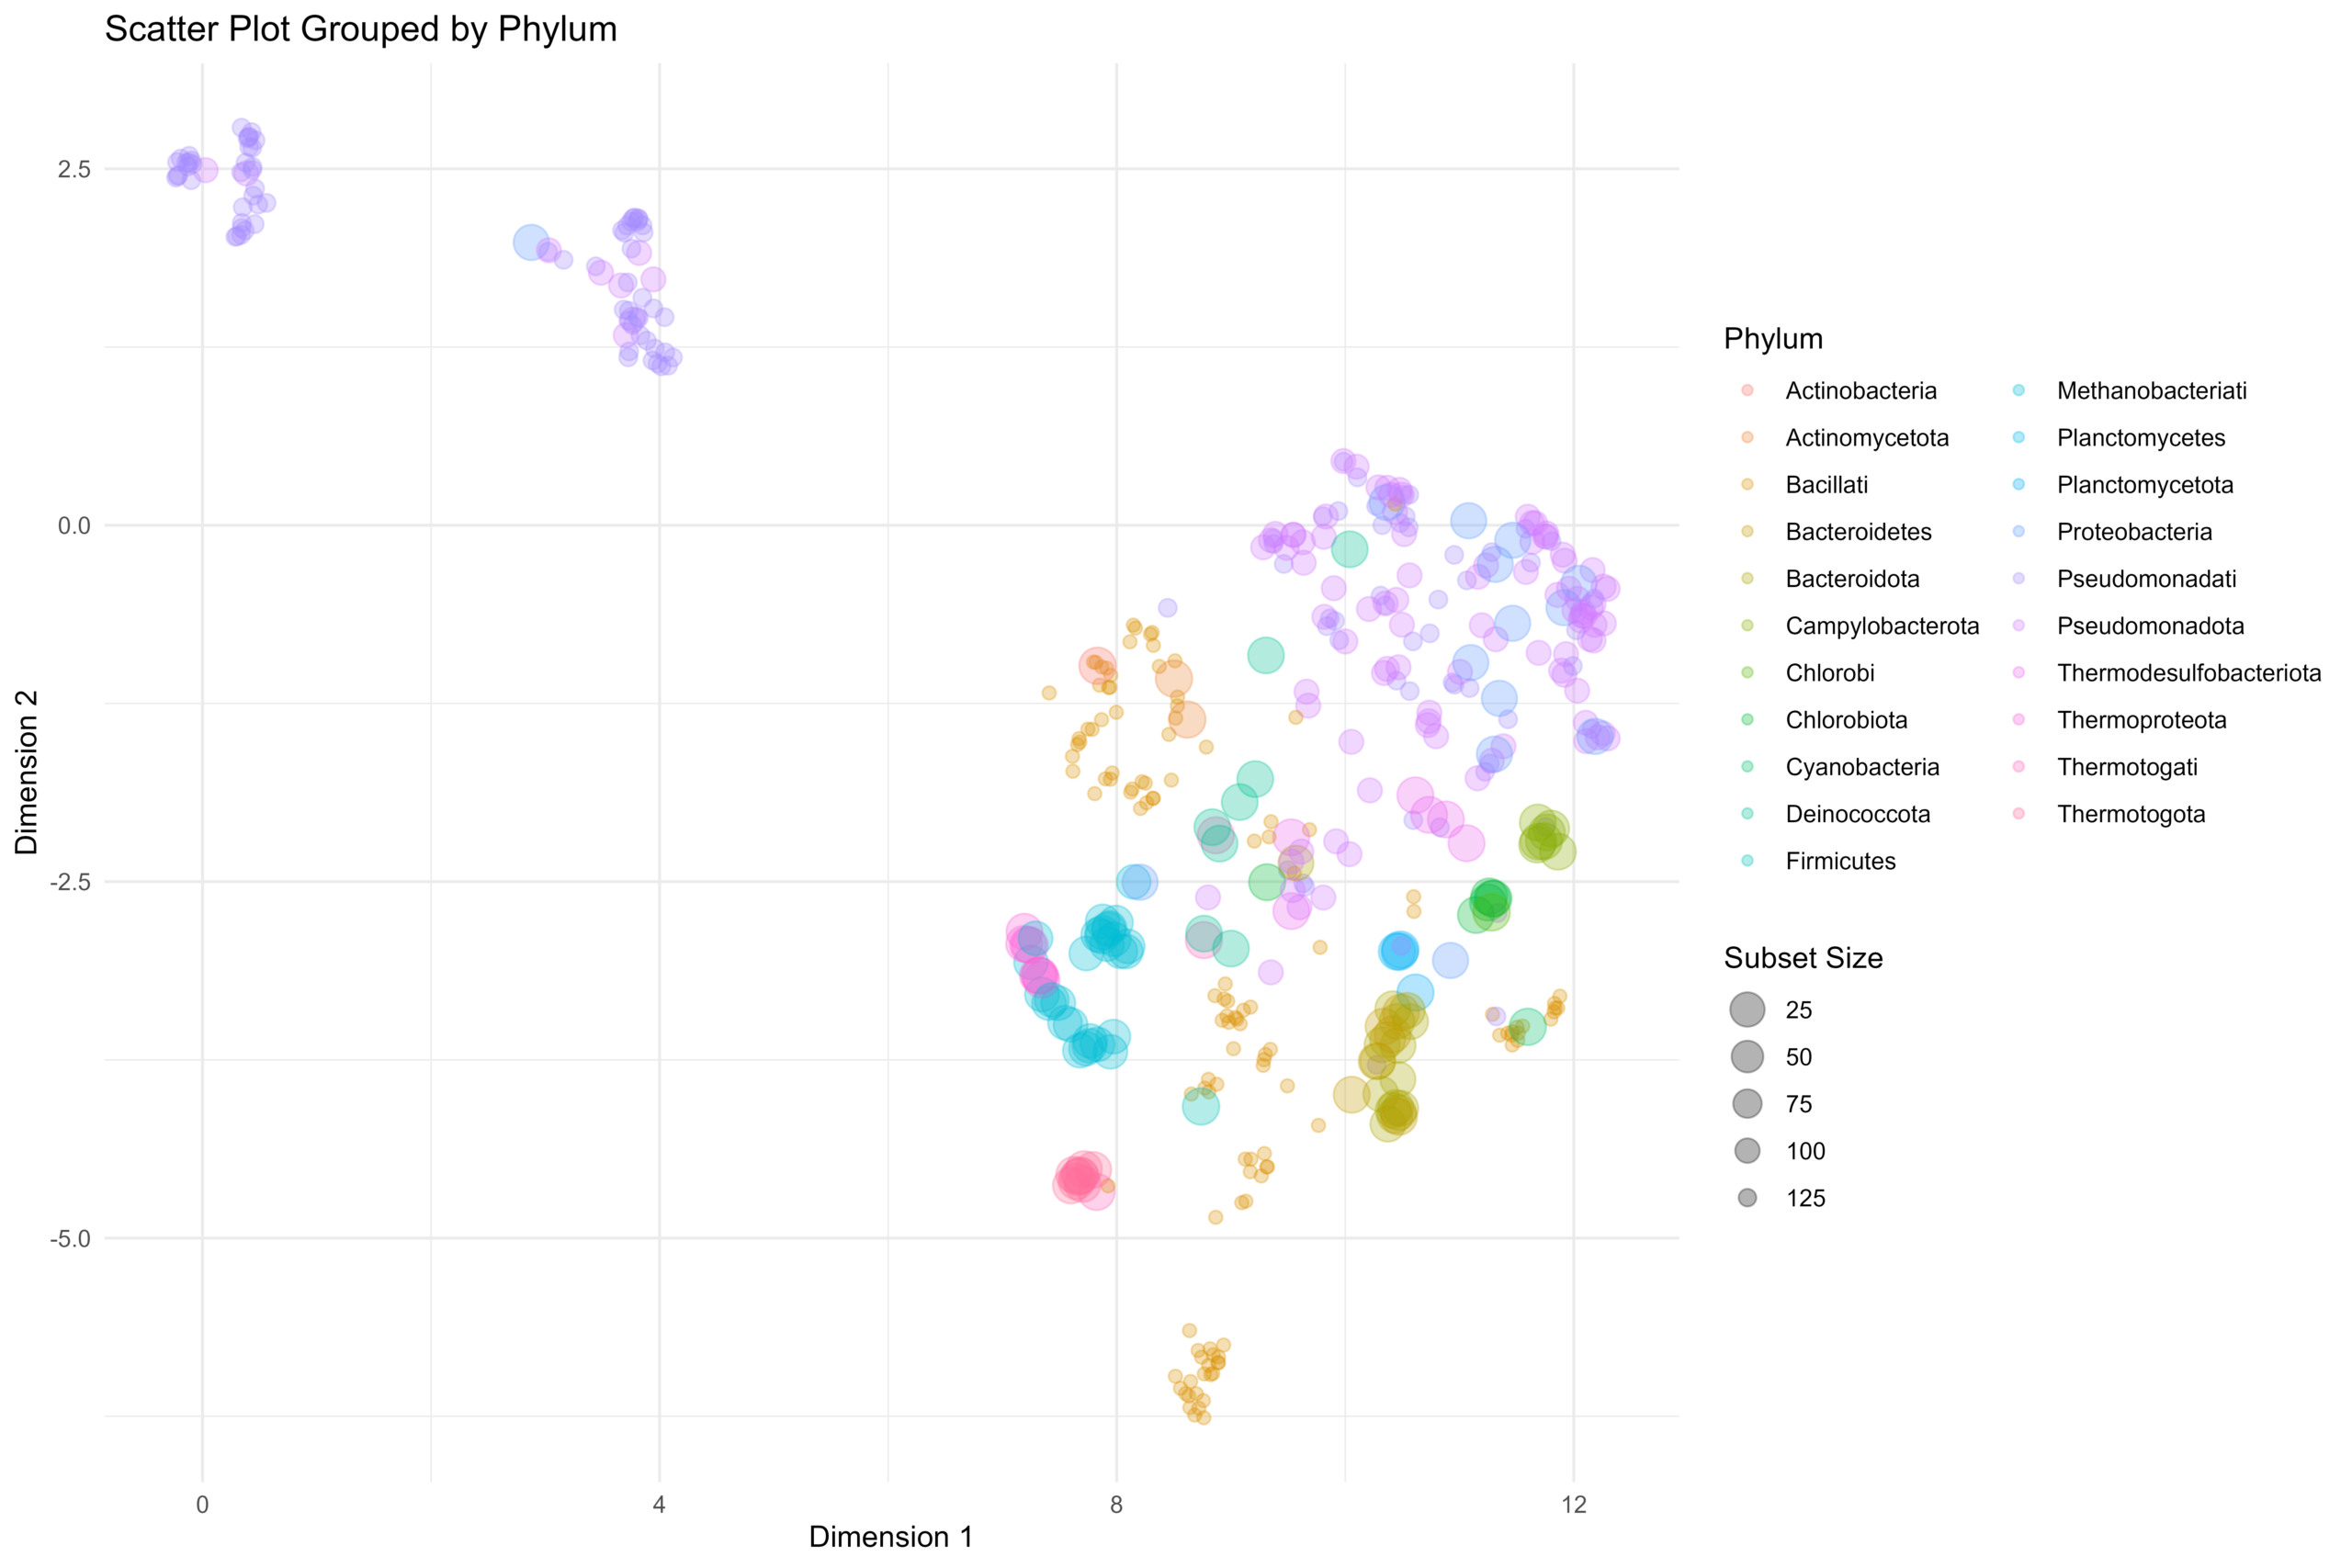
估计阅读时长: 11 分钟在将生物序列(如基因组或蛋白质序列)或文本数据转换为数值向量形式时,TF-IDF(Term Frequency-Inverse Document Frequency)和N-gram One-hot(又称Bag-of-n-grams)是两种经典且基础的文档嵌入算法。它们各自侧重于不同的特征提取方式,常被用于自然语言处理和生物信息学领域。 Attachments scatter_plot • 432 KB • 633 click 10.02.2026
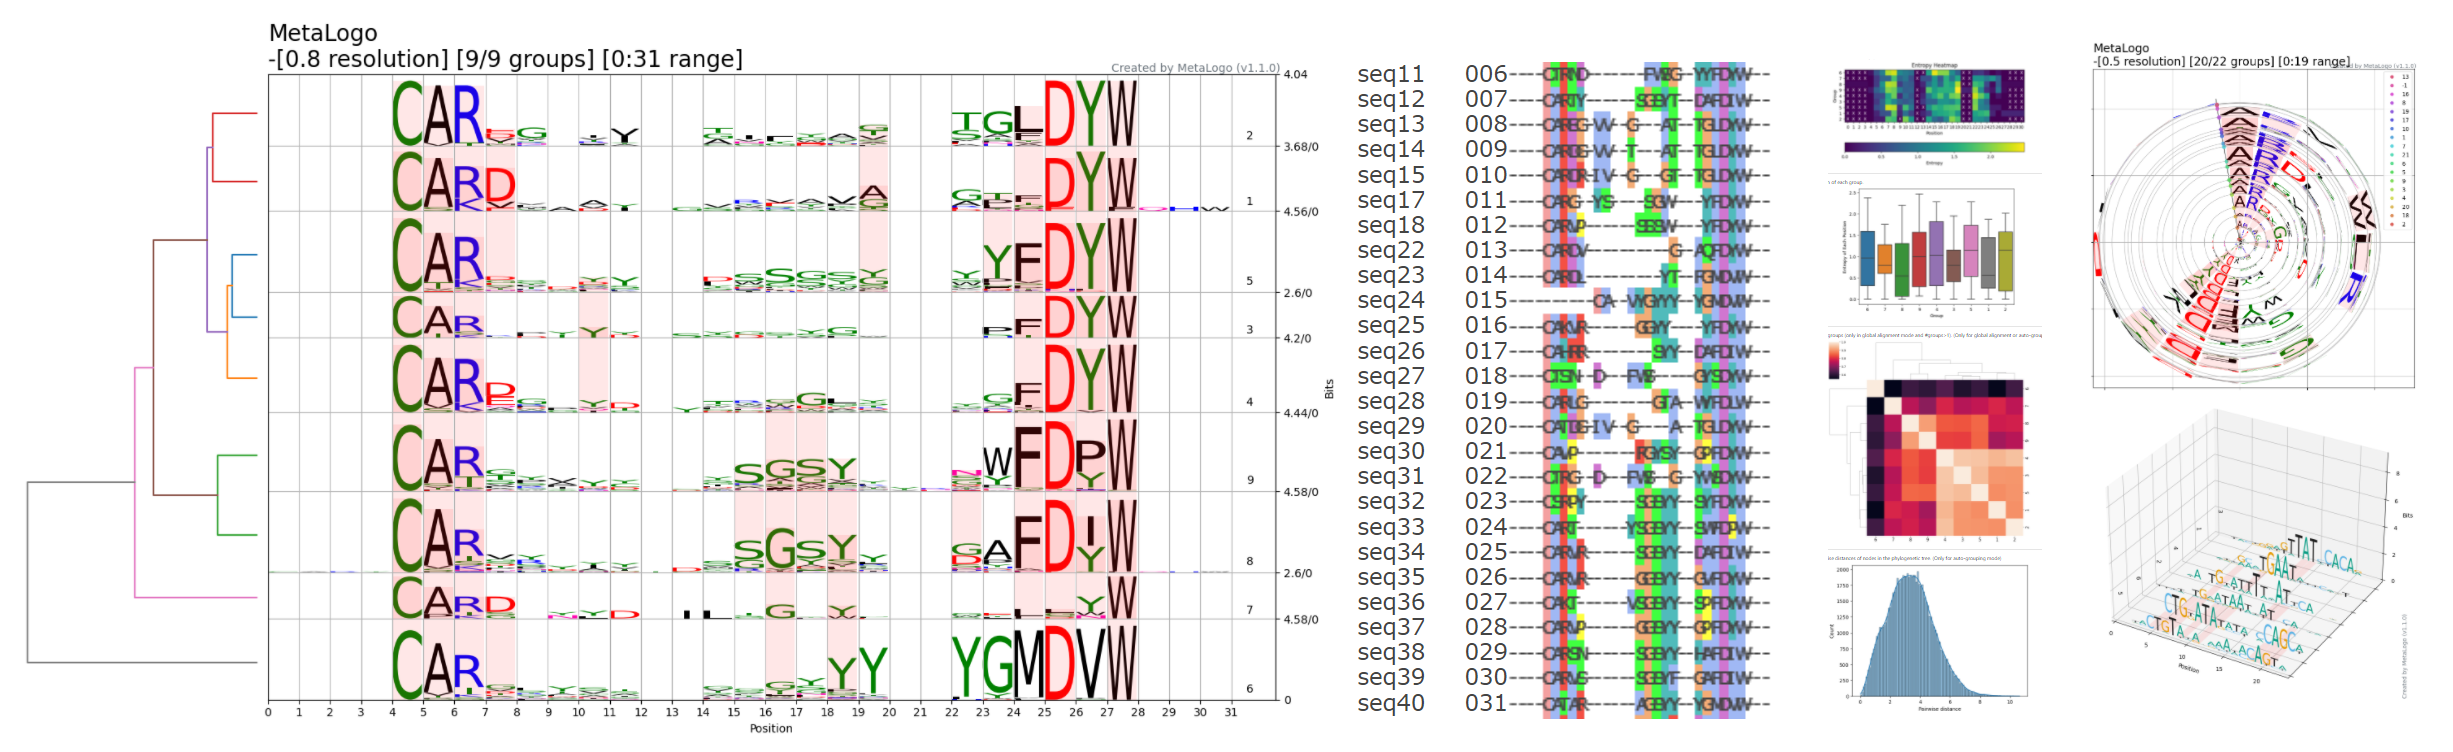
估计阅读时长: 22 分钟MSA(多序列比对)在生物信息学中的核心目标是:通过把多条同源序列“对齐”,来突出它们之间的相似与差异,从而帮助我们:识别保守区/功能位点、推断进化关系(系统发生)、预测或解释蛋白质/核酸结构、发现共进化与功能模块,以及为后续分析(如模体搜索、结构建模、从头设计等)提供基础。基于多序列比对分析,我们可以通过这种算法,把一堆表面看上去“乱糟糟”的序列,整理成一个可以“逐位点比较”的框架。基于我们所得到的这个框架基础,我们可以进行下游的后续分析,例如: 识别哪些部分是“不能动”的(功能/结构核心); 推断它们是如何“进化而来”的(系统发生); 推测它们在空间中“长什么样”(结构预测与建模); 找出哪些部分“一起变化”(共进化与功能耦合); 并把这些信息封装成模型(HMM、profile)用于大规模搜索与注释。 AttachmentsSort by:DefaultDateName MSA • 174 KB • 692 click 08.01.2026MSA_console […]
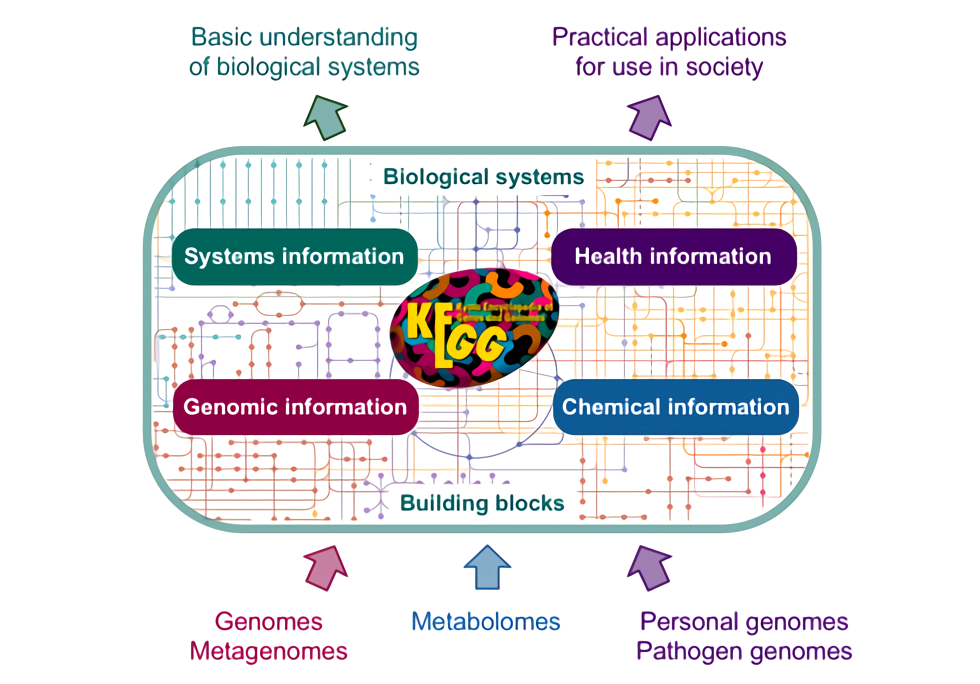
估计阅读时长: 16 分钟KEGG 里面目前并没有“现成的每个 KO 一条代表性序列 FASTA”这种官方序列数据库,假若我们需要基于KEGG数据库中的KO信息的注释,那我们一般会需要自己从 KEGG GENES 里面把每个 KO 对应的基因/蛋白序列抓出来,再按 KO 编号组织成 fasta 集合构建出对应的数据库。基于所建立好的KEGG基因序列数据库,我们就可以实现下面的一些基因注释工作: 在全基因组规模代谢网络重建工作中,进行我们的目标基因组中的代谢网络中的酶节点的直系同源推断,从而将我们的目标基因组中的基因映射到具体的KEGG代谢网络上的节点位置,从而重建出代谢网络模型(使用带有KO编号的蛋白序列做比对注释) 假若我们在进行宏基因组的基因丰度的计算,则可以基于所建立的KEGG基因序列数据库作为参考库,进行宏基因组测序数据中的KO基因丰度的计算(使用带有KO编号的基因序列做比对注释) […]
估计阅读时长: < 1 分钟环境中的微生物往往以复杂群落的形式存在,不同物种之间通过代谢相互作用形成协同或竞争关系,共同完成生物地球化学循环、维持生态系统功能。近年来,随着高通量基因组测序技术的发展,研究者可以从环境样本中获取海量微生物基因组数据,为构建基因组尺度代谢模型(Genome-scale metabolic models, GEMs)提供了基础。GEMs将微生物的全基因组注释与生化反应网络相结合,可以用于模拟微生物在特定环境条件下的代谢能力,预测其生长和代谢产物。在单菌株层面,GEMs已被广泛用于解析微生物对环境变化的代谢适应机制、指导代谢工程设计以及预测药物靶点等。在群落层面,通过将多个GEMs耦合,可以研究微生物之间的相互作用,例如通过代谢物交换实现的协同或竞争关系。 Attachments The-taxonomic-composition-of-various-type-samples-and-the-results-of-neutral-model • 499 KB • 563 click 04.01.2026
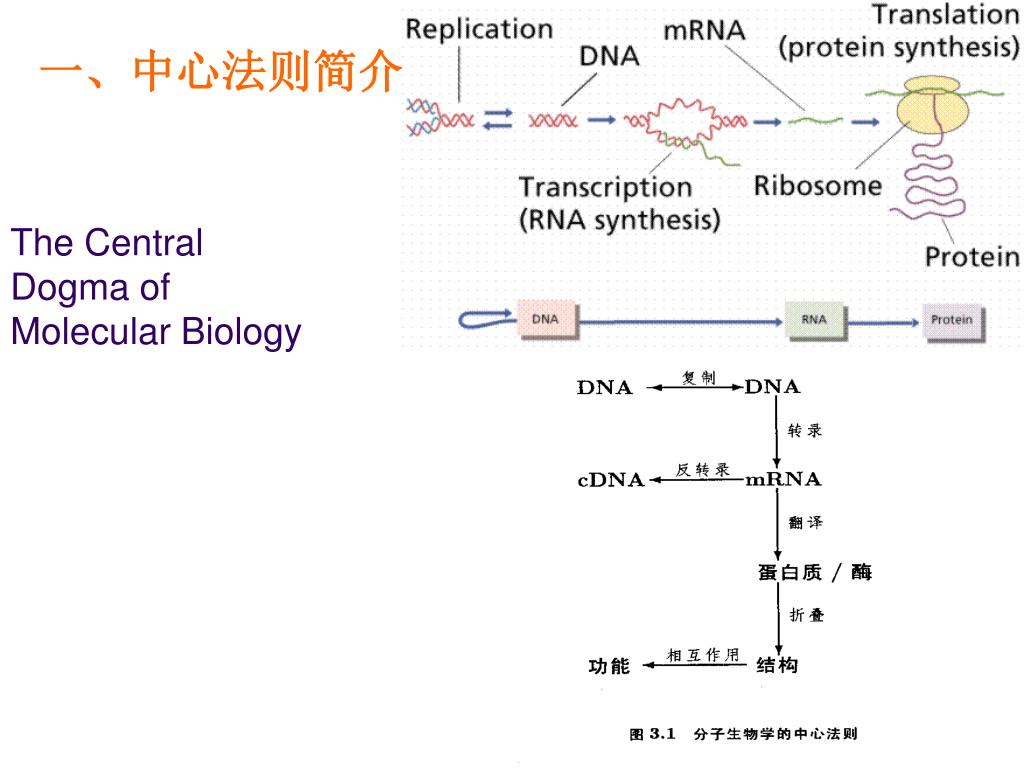
估计阅读时长: 8 分钟原核生物细胞内的中心法则是指遗传信息从DNA经RNA到蛋白质的传递过程,具有高效和经济的特点。DNA复制、转录和翻译均在细胞质中进行,且转录与翻译高度偶联——新生mRNA尚未完全合成,核糖体便已结合并开始翻译,极大提升了蛋白质合成速率。原核生物mRNA常为多顺反子结构,一条mRNA可编码多个功能相关的蛋白质,且无内含子、无需剪接,可直接作为翻译模板。此外,原核mRNA半衰期极短,便于快速响应环境变化。基因表达主要通过操纵子结构在转录水平进行精细调控,如乳糖操纵子和色氨酸操纵子,使原核生物能够灵活适应多变环境。这些机制共同构成了原核生物中心法则的核心,体现了其高度优化的遗传信息传递系统。 Attachments the-central-dogma-of-molecular-biology1-l • 69 KB • 656 click 21.12.2025
估计阅读时长: 23 分钟Sequence Logo 是一种可视化 DNA 或蛋白质序列保守性的图形表示方法。每个位置(列)上的字母堆叠高度代表该位点的信息含量(以 bits 为单位),而每个字母的高度则与其在该位点出现的频率成正比。高信息量的位置字母堆得高,低信息量的位置则矮甚至接近零。Sequence Logo的绘制遵循信息熵原理,我们可以很直观的通过某一个位置的总高低来了解该处位置的信息含量有多少,高信息量的位置,字母堆的高,一般会出现某一个字符特别高,表明该处非常保守。 位置权重矩阵(Position Weight Matrix, PWM)是描述基因组调控因子结合位点序列模式的核心模型。它通过统计在结合位点序列中每个位置上各核苷酸(或氨基酸)出现的频率,来量化该位置对不同碱基的偏好程度。PWM通常以矩阵形式表示,行对应核苷酸(A、C、G、T/U),列对应序列中的位置,矩阵元素即为该位置该核苷酸相对于背景的权重得分。这一模型简洁且易于计算,因此在转录因子结合位点(TFBS)等调控元件的识别和表征中被广泛采用。 AttachmentsSort by:DefaultDateName motif_scan • […]
估计阅读时长: 34 分钟在前面写了一篇文章来介绍我们可以如何通过KEGG的BHR评分来注释直系同源。在KEGG数据库的同源注释算法中,BHR的核心思想是“双向最佳命中”。它比简单的单向BLAST搜索(例如,只看你的基因A在数据库里的最佳匹配是基因B)更为严格和可靠。在基因注释中,这种方法可以有效减少因基因家族扩张、结构域保守等原因导致的假阳性注释,从而更准确地识别直系同源基因,而直系同源基因通常具有相同的功能。在今天重新翻看了下KAAS的帮助文档之后,发现KAAS系统中更新了下面的Assignment score计算公式: We define a score for each ortholog group in order to assign the best […]

This content speaks to hearts
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 我们在基于前面所论述的《通过diamond软件进行blastp搜索》对大规模的基因组数据进行了代谢酶的EC number的注释以及按照文章《基因组功能注释(EC Number)的向量化嵌入》的方法,得到了一个比较大的基因组代谢酶TF-IDF嵌入丰度矩阵后,如果将这里所得到的嵌入结果矩阵中的基因组,基于Family层级的物种分类分组看作为单细胞转录数据中的细胞分群结果,能否基于单细胞数据分析方法来分析和可视化我的基因组功能嵌入的结果矩阵呢? […]
[…] 对于基于ec number来生成层级数据,我们直接使用《酶EC编号结构解析》文章末尾所展示的层级数据生成函数来实现。 […]
[…] 在前面的一篇《基因组功能注释(EC Number)的向量化嵌入》博客文章中,针对所注释得到的微生物基因组代谢信息,进行基于TF-IDF的向量化嵌入之后。为了可视化向量化嵌入的效果,通过UMAP进行降维,然后基于降维的结果进行散点图可视化。通过散点图可视化可以发现向量化的嵌入结果可以比较好的将不同物种分类来源的微生物基因组区分开来。 […]